انتخاب مدل هوش مصنوعی فقط پیدا کردن بالاترین نمره در جدول نیست. در این راهنما با داده روز لیدربورد Artificial Analysis نشان میدهیم چطور بین هوش، هزینه هر تسک و سرعت تعادل برقرار کنید و مدل را با کار واقعی خودتان بسنجید، نه فقط با رتبه صدر جدول.
آخرین بهروزرسانی: ۱۹ آبان ۱۴۰۵ — منابع بررسیشده در این روز: لیدربورد مدلها و صفحه Model Recommender در Artificial Analysis، صفحه روششناسی شاخص هوش، و صفحههای Optima و MicroEvals.
⚡ پاسخ کوتاه
در ۱۹ آبان ۱۴۰۵، بالاترین نمره شاخص هوش در لیدربورد Artificial Analysis متعلق به Claude Fable 5.2 در سطح max بود: ۶۵؛ اما هزینه هر تسک آن ۲۶٫۵۴ دلار و زمانش ۴۶٫۴ دقیقه گزارش شده بود. مدلهایی مثل GPT-6.1 Sol در سطح max با نمره ۵۵ و هزینه ۱٫۲۷ دلار، برای بسیاری از کارها تعادل بهتری بین کیفیت و هزینه داشتند. قویترین مدل را فقط وقتی انتخاب کنید که کیفیت بالاتر واقعاً به کارتان میآید و بودجه و زمان انتظارش را میپذیرید.
وقتی جدول رتبهبندی مدلهای زبانی را باز میکنید، چشم معمولاً به بالاترین نمره میرود. در لیدربورد Artificial Analysis در ۱۹ آبان ۱۴۰۵، بالاترین نمره شاخص هوش متعلق به Claude Fable 5.2 در سطح تلاش max بود: ۶۵ از ۱۰۰. همان ردیف اما هزینه هر تسک را ۲۶٫۵۴ دلار و زمان هر تسک را ۴۶٫۴ دقیقه نشان میداد. چند ردیف پایینتر، GPT-6.1 Sol در سطح max نمره ۵۵ داشت؛ یعنی ده واحد کمتر. هزینه هر تسک آن ۱٫۲۷ دلار و زمانش ۱۹٫۷ دقیقه بود. اگر فقط نمره را ببینید، انتخاب واضح به نظر میرسد. اگر هزینه و زمان را هم ببینید، ممکن است مدل دوم برای کار روزمرهتان منطقیتر باشد.
این همان نقطهای است که «انتخاب مدل هوش مصنوعی» از «پیدا کردن قویترین مدل» جدا میشود. نمره بالاتر یعنی در مجموعه آزمونهای آن لیدربورد، مدل دقیقتر یا کاملتر عمل کرده است. اما کار شما ممکن است به آن دقت مرزی نیاز نداشته باشد، یا بودجه و زمان انتظارتان اجازه ندهد مدل صدر جدول را برای هر درخواست صدا بزنید. مقاله بهترین هوش مصنوعی برای هر کار مدلها را بر اساس نوع کار معرفی میکند. اینجا روی روش انتخاب تمرکز میکنیم: چطور بین هوش، سرعت و هزینه تعادل برقرار کنید، عددها را درست بخوانید، و قبل از خرید، مدل را روی کار خودتان بسنجید.
یک نکته را از همین ابتدا روشن کنیم. عددهایی که در این مقاله میآید، همان اعداد نمایشدادهشده در لیدربورد Artificial Analysis در ۱۹ آبان ۱۴۰۵ است. شرکتها مدل جدید میدهند، سطح تلاش را عوض میکنند و خود شاخص هم گاهی نسخه عوض میکند. پس این جدول یک عکس از امروز است، نه حکم همیشگی. قبل از تصمیم نهایی، دوباره همان صفحه را ببینید.
سه محور انتخاب مدل؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
سه محوری که باید با هم دیده شوند
تقریباً هر انتخاب جدی مدل، به سه محور برمیگردد: هوش، هزینه، و سرعت. اگر یکی را بدون دو تای دیگر ببینید، احتمال اشتباه بالاست.
هوش را در Artificial Analysis با شاخص هوش (Intelligence Index) میسنجند. این شاخص از میانگین وزندار چهار دسته ساخته میشود: کار دانش، کدنویسی، علم، و دانش عمومی. نمره از صفر تا صد گزارش میشود و در صفحه لیدربورد به صورت عدد صحیح دیده میشود. خود Artificial Analysis میگوید این شاخص برای مقایسه کلی مدلها مفید است، اما مثل هر معیار ارزیابی محدودیت دارد و ممکن است مستقیماً به هر کاربرد شما مربوط نباشد. جزئیات ساخت شاخص، آزمونها و محدودیتها را در مقاله شاخص هوش آوردهایم؛ اینجا فقط از نمره نمایشدادهشده برای مقایسه استفاده میکنیم.
هزینه را بهتر است با «هزینه هر تسک» ببینید، نه فقط قیمت هر میلیون توکن. قیمت توکن میگوید ورودی و خروجی هر مدل چند دلار است؛ اما مدل پرهوشتر معمولاً توکن بیشتری برای فکر کردن و جواب دادن مصرف میکند. به همین دلیل ممکن است مدلی با قیمت توکن بالاتر، در عمل برای یک کار مشخص ارزانتر تمام شود، یا برعکس. در لیدربورد Artificial Analysis ستونی به نام Cost per Task هست که هزینه اجرای یک تسک متوسط از مجموعه شاخص هوش را نشان میدهد. طبق روششناسی همان سایت، این هزینه فقط فراخوانی خود مدل را میپوشاند و هزینه داور، آمادهسازی فایل پیدیاف و نویسهخوانی را حساب نمیکند. یعنی این عدد برای مقایسه مدلها مفید است، اما صورتحساب دقیق پروژه شما نیست. اگر میخواهید قیمت توکن و روش محاسبه را عمیقتر ببینید، قیمت API مدلهای هوش مصنوعی و توکن در هوش مصنوعی چیست را بخوانید. برای گزینههای ارزانتر هم ارزانترین مدلهای هوش مصنوعی با کیفیت بالا را ببینید.
سرعت هم یک عدد نیست. «زمان هر تسک» در همان لیدربورد میگوید مدل برای تکمیل یک تسک متوسط شاخص هوش چقدر زمان میبرد. طبق روششناسی Artificial Analysis، این زمان از تعداد توکن خروجی و سرعت خروجی مدل برآورد میشود و زمان داور و آمادهسازی پرونده را شامل نمیشود؛ یعنی زمان دیوارساعتی کل ارزیابی نیست. جدا از آن، «زمان تا اولین توکن پاسخ» یا TTFT میگوید بعد از ارسال درخواست، چقدر طول میکشد تا اولین بخش جواب برسد. برای گفتوگوی زنده و چتبات، این تأخیر اول خیلی محسوس است. برای کار دستهای مثل خلاصه کردن صد فایل در شب، زمان کل هر تسک مهمتر است. توضیح کاملتر را در سرعت مدل هوش مصنوعی بخوانید.
علاوه بر این سه محور، دو ویژگی دیگر را هم باید در چکلیست بگذارید: اندازه پنجره متن یا Context Window، و اینکه مدل را از کدام مسیر صدا میزنید؛ چتبات آماده یا API. بسیاری از مدلهای صدر جدول در روز بررسی پنجره یکمیلیونتوکنی داشتند، اما این برای همه مدلها و همه ارائهدهندهها صادق نیست. اگر فایلهای بلند یا تاریخچه گفتوگوی طولانی دارید، این عدد را جداگانه چک کنید.
نمودار هوش در برابر هزینه؛ خواندن عددهای امروز
برای اینکه تعادل هوش و هزینه ملموس شود، چند ردیف از لیدربورد ۱۹ آبان ۱۴۰۵ را اینجا میآوریم. همه اعداد همان چیزی است که در صفحه رسمی نمایش داده میشد. خانههایی که در منبع با خط تیره آمده بود، اینجا هم خالی گذاشتهایم و عددی از خودمان نگذاشتهایم.
مدل و سطح تلاش
نمره شاخص هوش
هزینه هر تسک (دلار)
زمان هر تسک (دقیقه)
Claude Fable 5.2 (max)
۶۵
۲۶٫۵۴
۴۶٫۴
Claude Fable 5.2 (high)
۶۲
۹٫۰۸
۱۷٫۹
Gemini 4 Carbon (high)
۶۰
۷٫۷۶
۲۶٫۴
Claude Opus 5.5 (max)
۵۹
۱۰٫۰۴
۲۵٫۱
GPT-6 Astra (max)
۵۷
۶٫۲۴
۲۳٫۰
GPT-6.1 Sol (max)
۵۵
۱٫۲۷
۱۹٫۷
Claude Sonnet 5.5 (max)
۵۵
۱۰٫۰۲
۳۱٫۴
GPT-6.1 Terra (max)
۵۱
۰٫۹۶
۱۳٫۶
Kimi K3.1 Pro
۴۶
۳٫۶۸
۳۷٫۷
Claude Opus 5.5 (low)
۳۵
۰٫۹۸
۳٫۰
DeepSeek V4.1 Flash 1017 (max)
۳۳
۰٫۶۰
۱۶٫۶
Claude Haiku 5.5 (max)
۳۶
۰٫۴۱
۱۴٫۸
از این جدول چند الگوی عملی درمیآید، بدون اینکه بخواهیم برنده واحدی اعلام کنیم.
اول، فاصله نمره در بالای جدول کوچکتر از فاصله هزینه است. Claude Fable 5.2 در سطح max با نمره ۶۵ صدر جدول بود، اما هزینه هر تسک آن ۲۶٫۵۴ دلار گزارش شده بود. Gemini 4 Carbon در سطح high نمره ۶۰ داشت و هزینه هر تسکش ۷٫۷۶ دلار بود. Claude Opus 5.5 در سطح max نمره ۵۹ و هزینه ۱۰٫۰۴ دلار داشت. GPT-6 Astra در سطح max نمره ۵۷ و هزینه ۶٫۲۴ دلار داشت. یعنی چند واحد اختلاف در شاخص، میتواند چند برابر اختلاف در هزینه باشد.
دوم، مدلهای میانی جدول گاهی نسبت نمره به هزینه خیلی بهتری دارند. GPT-6.1 Sol در سطح max نمره ۵۵ و هزینه ۱٫۲۷ دلار داشت. GPT-6.1 Terra در سطح max نمره ۵۱ و هزینه ۰٫۹۶ دلار داشت. اگر کارتان به آخرین حد دقت نیاز ندارد، این ردیفها معمولاً انتخاب معقولتری هستند.
سوم، سطح تلاش را جدی بگیرید. یک مدل با چند برچسب low، medium، high، xhigh و max در جدول تکرار میشود. همین Claude Opus 5.5 در سطح max نمره ۵۹ و هزینه ۱۰٫۰۴ دلار داشت و در سطح low نمره ۳۵ و هزینه ۰٫۹۸ دلار. یعنی با عوض کردن سطح تلاش، هم هوش و هم هزینه و زمان عوض میشود. اگر در محصولتان سطح تلاش را روی max قفل کنید، ممکن است بدون نیاز واقعی چند برابر هزینه بپردازید.
چهارم، بعضی ردیفها نمره دارند اما هزینه یا زمان گزارش نشده است. مثلاً Muse Wonder Full در سطح max نمره ۵۰ داشت، اما هزینه و زمان آن در جدول با خط تیره آمده بود. در چنین مواردی ما عددی حدس نمیزنیم؛ یا از ستونهای موجود استفاده میکنید، یا آن مدل را فعلاً از مقایسه هزینه کنار میگذارید.
پنجم، مدلهای متنباز یا ارزانتر را نباید فقط با صدر جدول مقایسه کرد. در همین روز، Kimi K3.1 Pro با نمره ۴۶ در جدول بهعنوان مدل متنباز علامت خورده بود و هزینه هر تسک آن ۳٫۶۸ دلار بود. DeepSeek V4.1 Flash 1017 در سطح max نمره ۳۳ و هزینه ۰٫۶۰ دلار داشت. اینکه وزن این مدلها همین امروز قابل دانلود است یا نه را از صفحه خود سازنده چک کنید؛ ما فقط همان نمره و هزینهای را میآوریم که لیدربورد نشان میداد. برای مقایسه وسیعتر مدلهای متنباز، بهترین مدلهای هوش مصنوعی متنباز را ببینید.
مسیر انتخاب مدل مناسب؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
وقتی سرعت مهمتر از نمره است
همه کارها به بالاترین نمره نیاز ندارند. اگر کاربر پشت صفحه منتظر جواب است، تأخیر اولین توکن و زمان تمام شدن پاسخ، بخشی از کیفیت محصول است. اگر شبانه صدها سند را پردازش میکنید، زمان هر تسک روی هزینه نیروی انسانی و ظرفیت سرور اثر میگذارد.
مدل و سطح تلاش
نمره شاخص
زمان هر تسک (دقیقه)
زمان تا اولین توکن پاسخ (ثانیه)
هزینه هر تسک (دلار)
GPT-6 Luna (low)
۱۰
۰٫۶
۲٫۵۱
۰٫۰۱
GPT-6.1 Terra (low)
۲۹
۱٫۱
۲٫۳۳
۰٫۰۷
GPT-6.1 Sol (low)
۳۵
۱٫۷
۲٫۴۷
۰٫۱۶
GPT-6 Astra (medium)
۵۲
۶٫۸
۵٫۷۸
۲٫۷۳
Claude Fable 5.2 (low)
۵۴
۶٫۵
۶٫۵۴
۳٫۱۰
Claude Haiku 5.5 (max)
۳۶
۱۴٫۸
۱۸۱٫۵۰
۰٫۴۱
Claude Fable 5.2 (max)
۶۵
۴۶٫۴
۲۱۵٫۹۵
۲۶٫۵۴
در روز بررسی، بین ردیفهایی که زمان هر تسکشان گزارش شده بود، GPT-6 Luna در سطح low با ۰٫۶ دقیقه یکی از سریعترینها بود و هزینه هر تسک آن ۰٫۰۱ دلار گزارش شده بود. نمره شاخص آن ۱۰ بود. GPT-6.1 Terra در سطح low زمان ۱٫۱ دقیقه، هزینه ۰٫۰۷ دلار و نمره ۲۹ داشت. Claude Haiku 5.5 در سطح max نمره ۳۶، هزینه ۰٫۴۱ دلار و زمان ۱۴٫۸ دقیقه داشت. اینها برای کار سبک، پیشپردازش، طبقهبندی، بازنویسی کوتاه یا پاسخهای پرتعداد مناسبترند تا برای استدلال سنگین.
نکته مهم درباره مدلهای استدلالی این است که زمان تا اولین توکن پاسخ ممکن است خیلی طولانی شود. برای Claude Fable 5.2 در سطح max، همین عدد ۲۱۵٫۹۵ ثانیه گزارش شده بود؛ یعنی چند دقیقه فکر کردن قبل از شروع جواب. اگر محصولتان گفتوگوی زنده است، این تأخیر را باید در طراحی ببینید: یا سطح تلاش را پایین بیاورید، یا مدل سبکتری برای پاسخ اول بگذارید و مدل قوی را فقط برای کارهای سخت صدا بزنید.
سرعت یک مدل در ارائهدهندههای مختلف هم یکسان نیست. Artificial Analysis سرعت را جداگانه هم گزارش میکند. اگر به یک مدل مشخص رسیدهاید، مسیر اجرا و ارائهدهنده را هم مقایسه کنید. در ایران، دسترسی و پرداخت هم به همین انتخاب گره میخورد؛ شرایط را در خرید و استفاده از API هوش مصنوعی در ایران ببینید.
سطح تلاش استدلال را مثل یک تنظیم هزینه ببینید
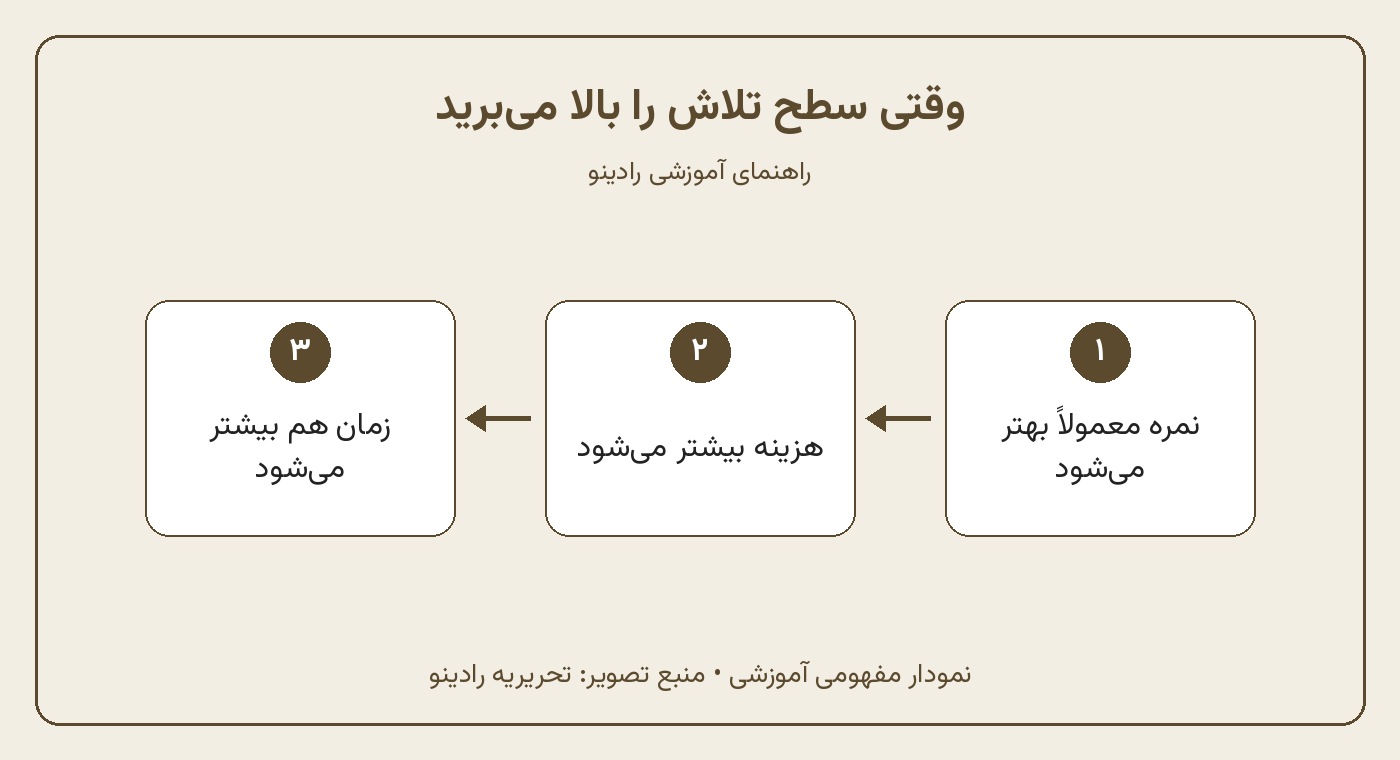
بسیاری از مدلهای امروزی یک «سطح تلاش» یا effort setting دارند: از low تا max. این تنظیم به مدل میگوید چقدر برای جواب وقت و توکن صرف کند. اثرش را در همان جدول هوش و هزینه دیدید: بالا بردن سطح تلاش معمولاً نمره را بالا میبرد، اما هزینه و زمان را هم زیاد میکند.
یک مثال روشن همین Claude Opus 5.5 است: از سطح low تا max، نمره از ۳۵ به ۵۹ رسید و هزینه هر تسک از ۰٫۹۸ دلار به ۱۰٫۰۴ دلار. GPT-6.1 Sol از سطح low با نمره ۳۵ و هزینه ۰٫۱۶ دلار تا سطح max با نمره ۵۵ و هزینه ۱٫۲۷ دلار بالا میآمد. پس «این مدل خوب است یا نه» بدون ذکر سطح تلاش، سؤال ناقصی است. در مستندات و فاکتور API هم باید همین سطح را ثبت کنید، وگرنه آزمایش امروز با هزینه فردا یکی نخواهد بود.
اگر میخواهید بدانید حالت استدلال اصلاً چیست و چه فرقی با پاسخ معمولی دارد، مدلهای استدلالی را بخوانید. قاعده عملی ما این است: کار را اول با سطح متوسط یا حتی پایین روی چند نمونه واقعی امتحان کنید. فقط وقتی کیفیت کافی نبود، سطح را بالا ببرید و دوباره هزینه و زمان را اندازه بگیرید.
وقتی سطح تلاش را بالا میبرید؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
سناریوهای واقعی: چتبات، کدنویسی، محتوا و تحلیل
عددهای لیدربورد وقتی معنا پیدا میکنند که آنها را به کار مشخص وصل کنید. در این بخش چند سناریوی رایج را با همان دادههای امروز بررسی میکنیم. اینها پیشنهاد اولیه هستند، نه نسخه نهایی برای همه تیمها.
چتبات پشتیبانی یا دستیار سایت
در چتبات، معمولاً سه چیز همزمان مهم است: جواب باید به اندازه کافی دقیق باشد، تأخیر نباید کاربر را خسته کند، و هزینه هر گفتوگو باید قابل پیشبینی بماند. اگر هزاران گفتوگوی کوتاه در روز دارید، مدل صدر جدول با هزینه چند دلاری برای هر تسک شاخص، بهسرعت بودجه را تمام میکند. اینجا مدلهای میانی یا سبکتر، مثل خانواده Sol و Terra در سطح متوسط یا Haiku، معمولاً نقطه شروع بهتری هستند. برای سؤالهای سخت یا موارد حساس، میتوانید درخواست را به مدل قویتر بفرستید.
پنجره متن را هم بسنجید. اگر چتبات باید سیاست فروشگاه، سابقه سفارش و چند پرونده راهنما را همزمان ببیند، مدل با پنجره بزرگتر راحتتر است؛ اما باز هم لازم نیست برای هر سلاموعلیک، کل تاریخچه را به گرانترین مدل بدهید. اگر میخواهید مدل را به سایت وصل کنید، اتصال سرویسهای سایت با API را ببینید.
کدنویسی و بازبینی کد
برای کدنویسی، شاخص هوش عمومی نقطه شروع است، اما همه داستان نیست. بخشی از این شاخص به کدنویسی اختصاص دارد، ولی کار واقعی برنامهنویس معمولاً به ایجنت، ابزار و محیط اجرا هم وابسته است. اگر کارتان نوشتن تابعهای کوتاه، توضیح کد یا پیشنهاد تست است، مدل میانی با هزینه کمتر غالباً کافی است. اگر ایجنت باید چند فایل را در مخزن تغییر دهد و آزمون اجرا کند، مقایسه ایجنتها را جداگانه ببینید: بهترین هوش مصنوعی برای برنامهنویسی و مقایسه ایجنتهای کدنویسی. نمره بالای مدل در شاخص هوش، بهتنهایی موفقیت ایجنت را تضمین نمیکند.
تولید محتوا و بازاریابی
برای نوشتن پیشنویس کپشن، ایمیل یا طرح تبلیغ، مدل خیلی گران لزوماً متن بهتری از مدل متوسط نمیدهد؛ مخصوصاً اگر پرامپت ضعیف باشد یا لحن برند را مشخص نکرده باشید. این کار بیشتر به دستورالعمل روشن و بازبینی انسانی نیاز دارد تا به آخرین حد نمره شاخص. مدلهای میانی یا حتی سبک، برای پیشنویسهای پرتعداد مناسباند و مدل قویتر را میشود برای بازنویسی نهایی یا ایدههای سختتر گذاشت. مجموعه پرامپتهای آماده را در بازاریابی با هوش مصنوعی؛ ۳۰ پرامپت برای تبلیغات، کپشن و ایمیل آوردهایم.
اگر محتوا فارسی است، یک هشدار مهم دارید: شاخص هوش Artificial Analysis عمدتاً مجموعهای انگلیسیزبان است و زبان فارسی در فهرست زبانهای شاخص چندزبانه همان سایت، در روز بررسی، نیامده بود. پس رتبه خوب در آن جدول بهمعنای درک بهتر فارسی نیست. برای این موضوع کدام هوش مصنوعی فارسی را بهتر میفهمد را بخوانید و حتماً روی متن خودتان هم آزمون کنید.
تحلیل داده، خلاصه فایل و کار دانش
اگر مدل باید جدول، گزارش یا پیدیاف بلند را بخواند و جمعبندی قابل اتکا بدهد، هوش و پنجره متن هر دو مهم میشوند. بخشی از شاخص هوش دقیقاً به کار دانش و استدلال روی پروندههای بلند مربوط است. اینجا ممکن است هزینه بالاتر مدل قوی توجیه داشته باشد، چون یک اشتباه در عدد یا یک نتیجهگیری غلط، گرانتر از اختلاف قیمت مدل تمام میشود. با این حال، باز هم لازم نیست همه مراحل را با گرانترین مدل انجام دهید: استخراج اولیه با مدل سبکتر و بررسی نهایی با مدل قویتر، غالباً تعادل بهتری است. برای خلاصه کردن فایلهای بلند، بهترین هوش مصنوعی برای خلاصه کردن PDF را هم ببینید.
ابزارهای کمکی برای انتخاب؛ از لیدربورد تا آزمون خودتان
اگر نمیخواهید جدول را دستی سبکسنگین کنید، خود Artificial Analysis ابزاری به نام Model Recommender دارد که مدل پیشنهاد میدهد. جزئیات دقیق تنظیمات این ابزار را در متن صفحه عمومی آن پیدا نکردیم و حدس نمیزنیم؛ بهعنوان یک نقطه شروع مفید است، اما جای آزمایش روی کار خودتان را نمیگیرد.
دو ابزار دیگر همان سایت برای آزمون واقعیتر طراحی شدهاند. MicroEvals اجازه میدهد یک پرامپت را روی چند مدل اجرا و خروجی را مقایسه کنید. Optima برای ساخت بنچمارک اختصاصی روی کارهای خودتان است. ما قیمت این ابزارها را در این مقاله بررسی نکردیم؛ اگر خواستید استفاده کنید، تعرفه را در خود صفحه ببینید.
هیچکدام از این ابزارها، حتی شاخص هوش، جایگزین یک آزمایش کوچک روی داده واقعی شما نیستند. چند نمونه از کارهای پرتکرار تیم را انتخاب کنید، همان متن را به دو یا سه مدل با سطح تلاش مشخص بدهید، و نتیجه را با سه معیار ثابت بسنجید: کیفیت قابل قبول بود یا نه، چقدر طول کشید، و هزینه هر بار چقدر شد. اگر کیفیت دو مدل نزدیک بود، ارزانتر و سریعتر را بردارید. اگر فقط مدل قویتر کیفیت لازم را داشت، همان را برای همان نوع کار نگه دارید، نه لزوماً برای همه کارها.
قبل از خرید اشتراک یا بستن قرارداد API، این فهرست را یکبار مرور کنید.
۱. کار را دقیق بنویسید. «یک مدل خوب میخواهم» کافی نیست. بگویید مدل باید چت کند، کد بنویسد، فایل بلند خلاصه کند، یا محتوا تولید کند. حجم درخواست روزانه و حداکثر تأخیر قابل قبول را هم مشخص کنید.
۲. حداقل کیفیت را تعریف کنید. مثلاً «در ده نمونه واقعی، حداقل هشت پاسخ باید بدون ویرایش اساسی قابل استفاده باشد.» بدون این خط، همیشه وسوسه میشوید مدل گرانتر را بردارید.
۳. نمره شاخص هوش را بهعنوان نقطه شروع ببینید، نه حکم نهایی. نمره امروز را از لیدربورد بخوانید و سطح تلاش را هم یادداشت کنید.
۴. هزینه هر تسک و قیمت توکن را با هم ببینید. هزینه هر تسک برای مقایسه بین مدلها مفید است؛ برآورد صورتحساب خودتان را با چند درخواست واقعی حساب کنید.
۵. سرعت را متناسب با نوع کار بسنجید. گفتوگوی زنده به تأخیر اول حساس است؛ کار دستهای به زمان کل و هزینه.
۶. پنجره متن، ابزارها، خروجی ساختیافته و محدودیتهای ارائهدهنده را چک کنید. مدلی که نمره بالا دارد اما به ابزار یا قالب مورد نیاز شما وصل نمیشود، انتخاب عملی نیست.
۷. زبان فارسی را جداگانه آزمون کنید. روی شاخص انگلیسی حساب نکنید.
۸. دسترسی و پرداخت را قبل از طراحی محصول قطعی کنید. مخصوصاً اگر تیم در ایران است.
۹. وابستگی به یک مدل یا یک شرکت را سبکسنگین کنید. اگر بتوانید با یک واسط یا چند مدل کار کنید، عوض کردن مدل بعدی ارزانتر تمام میشود.
۱۰. مسیر ادامه را مشخص کنید: مدل سبک برای کار پرتعداد، مدل قوی برای کار سخت، و بازبینی انسانی برای خروجیهای حساس.
سؤالات متداول درباره انتخاب مدل هوش مصنوعی
قویترین مدل هوش مصنوعی امروز کدام است؟
در لیدربورد Artificial Analysis در ۱۹ آبان ۱۴۰۵، بالاترین نمره شاخص هوش متعلق به Claude Fable 5.2 در سطح max بود: ۶۵. این بهمعنای بهترین انتخاب برای هر کار و هر بودجه نیست. همان ردیف هزینه و زمان بالاتری نسبت به چند مدل نزدیک به صدر داشت.
برای شروع ارزان، کدام مدل را امتحان کنیم؟
اگر کیفیت متوسط کافی است و تعداد درخواست بالاست، در همین روز ردیفهایی مثل GPT-6.1 Terra یا GPT-6.1 Sol در سطح تلاش پایینتر تا متوسط، و مدلهای سبکتری مثل Claude Haiku 5.5 یا GPT-6 Luna، هزینه هر تسک خیلی کمتری نسبت به صدر جدول داشتند. اینها را اول روی کار خودتان امتحان کنید. ارزانترین ردیف جدول لزوماً برای کار شما کافی نیست.
تفاوت هزینه هر تسک با قیمت هر توکن چیست؟
قیمت هر توکن، نرخ ورودی و خروجی مدل است. هزینه هر تسک برآوردی است از اینکه اجرای یک کار مشخص، با احتساب توکنهایی که واقعاً مصرف میشود، چقدر تمام میشود. مدل استدلالی ممکن است توکن بیشتری مصرف کند و در نتیجه هزینه هر تسکش بالاتر از چیزی باشد که فقط از قیمت توکن حدس میزنید.
آیا باید همیشه مدل استدلالی با سطح max بگذارم؟
خیر. سطح تلاش بالاتر معمولاً نمره را بهتر میکند، اما هزینه و زمان را هم بالا میبرد. کار را اول با سطح پایینتر بسنجید و فقط وقتی کیفیت کافی نبود، سطح را زیاد کنید.
چتبات رایگان برای انتخاب مدل کافی است؟
برای آشنایی اولیه بله. برای تصمیم محصول، بهتر است مصرف را با API یا پلن مشخص اندازه بگیرید، چون سهمیه، مدل در دسترس و هزینه در نسخه رایگان و پولی فرق دارد. مقایسه پلنهای رایگان و پولی ChatGPT را در ChatGPT رایگان یا پولی بخوانید. مقایسه کلی چند دستیار معروف را هم در مقایسه ChatGPT، Claude، Gemini و Copilot ببینید.
از کجا بفهمم مدل برای فارسی مناسب است؟
از روی شاخص هوش انگلیسی نمیفهمید. چند متن واقعی فارسی، با لحن و اصطلاحات خودتان، به مدل بدهید و کیفیت، صحت و طبیعی بودن زبان را خودتان قضاوت کنید. مقاله مقایسه مدلها در زبان فارسی را هم ببینید.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.