«کدام هوش مصنوعی بهتر است؟» شاید پرتکرارترین سؤالی باشد که این روزها میشنویم. جواب صادقانه این است: بستگی دارد چه کاری میخواهید انجام دهید. مدلی که در کدنویسی بیرقیب است، لزوماً بهترین گزینه برای ساخت تصویر یا تبدیل گفتار به متن نیست. در این راهنما بهترین هوش مصنوعی را برای کارهای رایج یعنی نوشتن، ترجمه، کدنویسی، تحلیل داده، تصویر، ویدیو و صدا بر اساس دادههای مستقل و بهروز معرفی میکنیم تا بتوانید برای هر کار، ابزار درست را انتخاب کنید.
آخرین بهروزرسانی: ۲۷ مهر ۱۴۰۵ — رتبهها و قیمتها از لیدربوردهای Artificial Analysis (متن، کدنویسی، تصویر، ویدیو و صدا؛ دریافت: ۲۷ مهر ۱۴۰۵)، LMArena (دادههای ۲۳ و ۲۶ مهر ۱۴۰۵) و صفحههای رسمی اشتراکها برداشته شدهاند.
قبل از اینکه سراغ فهرستها برویم، بیایید روشن کنیم «بهتر» یعنی چه. برای انتخاب مدل هوش مصنوعی سه معیار اصلی داریم که تقریباً همیشه با هم در کشمکشاند:
هوش یا کیفیت: مدل چقدر درست، دقیق و عمیق جواب میدهد. برای مدلهای زبانی، شاخص هوش Artificial Analysis و امتیاز کاربران در LMArena دو مرجع اصلیاند. اگر میخواهید بدانید این اعداد چطور ساخته میشوند، راهنمای بنچمارکهای هوش مصنوعی را بخوانید.
سرعت: چند ثانیه طول میکشد تا جواب برسد. مدلهای استدلالی در بالاترین سطح فکر کردن گاهی چند دقیقه زمان میبرند.
هزینه: یا قیمت اشتراک ماهانه، یا اگر از API استفاده میکنید، هزینهٔ هر تسک.
بهترین ابزار، تعادلی بین کیفیت، سرعت و بودجهٔ شماست.
یک مثال واقعی از لیدربورد Artificial Analysis این کشمکش را خوب نشان میدهد: Claude Opus 5.5 در سطح max با امتیاز ۵۸ باهوشترین مدل است، اما هزینهٔ هر تسکش ۵.۹۸ دلار است و به طور میانه بیش از ۹ دقیقه تا اولین تکهٔ پاسخ صبر میکند. در مقابل، GPT-6.1 Sol در سطح max با امتیاز ۵۲ فقط ۰.۷۲ دلار هزینه دارد. برای اکثر کارهای روزمره، تفاوت ۶ امتیاز ارزش ۸ برابر هزینه را ندارد. رتبهبندی کامل را در رتبهبندی مدلهای هوش مصنوعی ۲۰۲۶ آوردهایم.
چتبات یا API؟
اگر کاربر عادی هستید، معمولاً از طریق چتباتهایی مثل ChatGPT، Claude یا Gemini با مدلها کار میکنید و هزینه همان اشتراک ماهانه است. اگر توسعهدهندهاید و میخواهید مدل را در محصول خود به کار ببرید، API و قیمت هر توکن مهم میشود که در مقالهٔ قیمت API مدلهای هوش مصنوعی کامل بررسی کردهایم. برای آشنایی کلیتر با کاربردهای این فناوری هم مقالهٔ مزایا و کاربردهای هوش مصنوعی نقطهٔ شروع خوبی است.
سرویس
پلن رایگان
پلنهای پولی (ماهانه)
Claude
دارد
Pro با ۲۰ دلار (۱۷ دلار در پرداخت سالانه)، Max از ۱۰۰ دلار
Gemini (Google AI)
دارد
AI Plus با ۴.۹۹، AI Pro با ۱۹.۹۹، AI Ultra با ۹۹.۹۹ یا ۱۹۹.۹۹ دلار
ChatGPT
دارد
Go، Plus و Pro (پلن Pro با استدلال GPT-6 Astra)
منبع: صفحههای رسمی قیمت Claude، Google AI و ChatGPT (دریافت: ۲۷ مهر ۱۴۰۵). قیمت پلنهای ChatGPT در کشورهای مختلف متفاوت نمایش داده میشود و ما عدد آن را ثبت نکردهایم.
بهترین هوش مصنوعی برای نوشتن و ترجمه
برای نوشتن مقاله، ایمیل، متن تبلیغاتی یا ترجمه، مهمترین چیز کیفیت زبانی و پیروی دقیق از دستورالعمل است. بهترین معیار عمومی در این زمینه، امتیاز Text Arena در LMArena است که بر اساس رأی کور میلیونها کاربر ساخته میشود.
رتبه
مدل
امتیاز Text Arena
1
Gemini 4 Argon (High)
1524 (مقدماتی)
2
Muse Wonder (Max)
1509
3
Claude Opus 5.5 (High)
1508
4
Claude Fable 5 (High)
1504
9
Gemini 3.8 Flash (High)
1496
منبع: LMArena Text Arena (دادههای ۲۳ مهر ۱۴۰۵، بر پایهٔ ۸٬۸۳۴٬۲۱۱ رأی).
برای نوشتن و ترجمه، کیفیت زبانی و پیروی از لحن مهمتر از قدرت استدلال است.
پیشنهاد ما برای نوشتن و ترجمه:
بهترین کیفیت: Gemini 4 Argon و Claude Opus 5.5 در صدر رأی کاربران هستند. Gemini از طریق اشتراک Google AI Pro و Claude از طریق Pro در دسترس است.
بهترین نسبت کیفیت به هزینه: Gemini 3.8 Flash با رتبهٔ ۹ در Text Arena، مدلی سبک است که سطح رایگان هم دارد.
ترجمهٔ متنهای طولانی: مدلهایی که کانتکست یک میلیون توکنی دارند (مثل Claude 5.5، GPT-6 و Gemini 4) میتوانند کل یک کتاب یا قرارداد را یکجا بخوانند و اصطلاحات را یکدست نگه دارند.
یک هشدار مهم: هیچکدام از این لیدربوردها کیفیت فارسی را جداگانه نمیسنجند. پس قبل از انتخاب نهایی، یک متن نمونهٔ فارسی از کار خودتان را به دو یا سه مدل بدهید و خروجی را مقایسه کنید. اگر برای سایت محتوا تولید میکنید، حتماً متن را ویرایش و راستیآزمایی کنید؛ در مقالهٔ تولید محتوای مفید و قابل اعتماد توضیح دادهایم چرا محتوای خام هوش مصنوعی کافی نیست.
بهترین هوش مصنوعی برای کدنویسی
در کدنویسی دو نوع داده داریم: کیفیت ساخت رابط وب در WebDev Arena و توانایی حل مسئلههای واقعی مهندسی نرمافزار در شاخص ایجنت کدنویسی Artificial Analysis.
ابزار + مدل
Coding Agent Index
هزینهٔ هر تسک
Claude Code + Sonnet 5.5 (max)
68.4
$14.19
Devin Fusion CLI (Opus 5.5 + GPT-6 Luna)
68.1
$9.01
Antigravity CLI + Gemini 4 Argon (high)
63.8
$5.84
Codex + GPT-6.1 Sol (xhigh)
62.9
$1.04
Codex + GPT-6.1 Sol (medium)
61.4
$0.70
منبع: Artificial Analysis Coding Agent Index نسخهٔ ۱.۵ (دریافت: ۲۷ مهر ۱۴۰۵). هزینهها بر اساس پرداخت به ازای توکن است و با اشتراک ماهانه فرق میکند.
خلاصه اینکه Claude Code با Sonnet 5.5 در بالاترین سطح اول است، اما Codex با GPT-6.1 Sol با کمتر از یکدهم هزینه فقط حدود ۵ تا ۷ امتیاز عقبتر است. در WebDev Arena هم Claude Opus 5.5 با امتیاز ۱۸۰۶ اول است. بررسی کامل مدلها، IDEها و ایجنتها را در بهترین هوش مصنوعی برای برنامهنویسی ۲۰۲۶ بخوانید.
بهترین هوش مصنوعی برای تحلیل داده
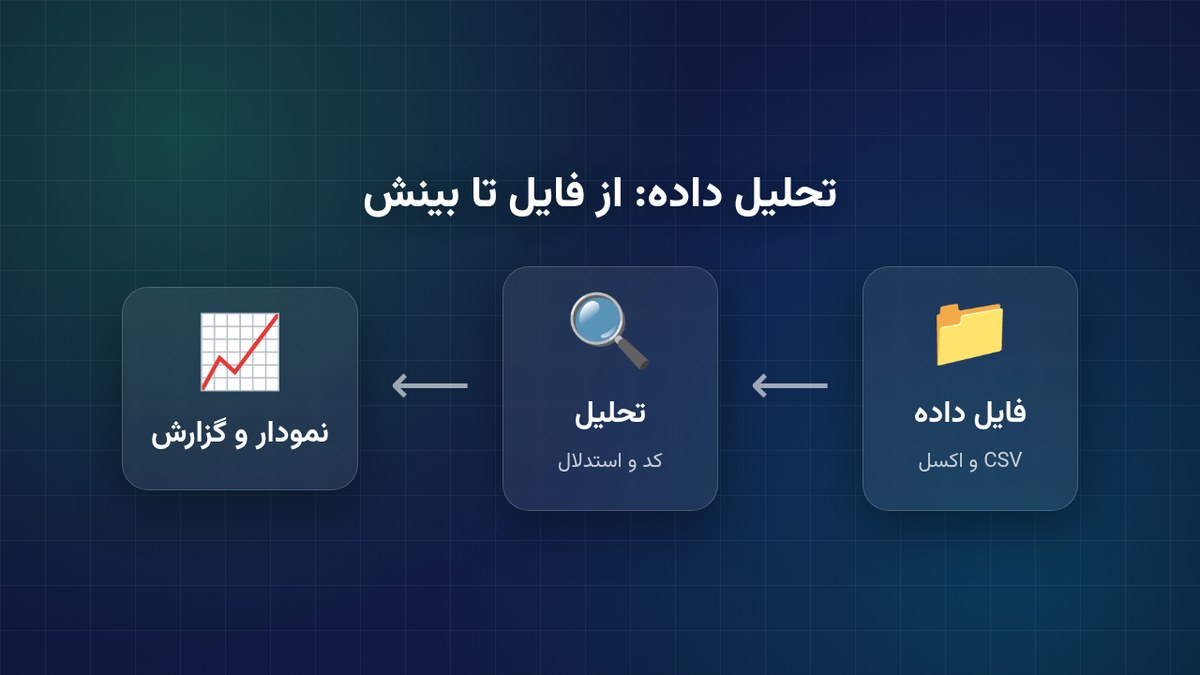
تحلیل داده یعنی مدل بتواند یک فایل اکسل یا CSV را بخواند، با نوشتن و اجرای کد محاسبه کند و نتیجه را به نمودار و گزارش تبدیل کند. اینجا سه ویژگی مهم است: قدرت استدلال، کانتکست طولانی برای فایلهای بزرگ و امکان اجرای کد در خود چتبات یا ابزار.
تحلیل داده با هوش مصنوعی: بارگذاری فایل، تحلیل با کد و استدلال، و خروجی نمودار و گزارش.
تحلیل پیچیده و چندمرحلهای: Claude Opus 5.5 (شاخص هوش ۵۸) و GPT-6 Astra (۵۳) در صدر توانایی استدلالاند.
تحلیل روزمره با هزینهٔ کم: GPT-6.1 Sol و Gemini 4 Argon با امتیاز ۵۲ و ۵۳ و هزینهٔ هر تسک پایینتر انتخابهای متعادلی هستند.
دادههای خیلی حجیم: بیشتر مدلهای پرچمدار کانتکست یک میلیون توکنی دارند و طبق Artificial Analysis، بیشترین کانتکست (۱۰ میلیون توکن) متعلق به Llama 4 Scout است که مدلی با وزن باز است.
دادههای محرمانه: اگر نمیخواهید داده از سازمان خارج شود، مدلهای با وزن باز مثل MiMo-V2.6-Pro یا DeepSeek V4.1 Flash (هر دو با شاخص هوش حدود ۴۵ تا ۴۶) را روی سرور خودتان اجرا کنید.
یک نکتهٔ عملی: همیشه از مدل بخواهید کدی را که برای محاسبه نوشته نشانتان بدهد. عددی که مدل بدون اجرای کد «حدس» میزند، قابل اعتماد نیست.
بهترین هوش مصنوعی برای تصویر، ویدیو و صدا
برای تولید رسانه، مدلهای زبانی معمولی کنار میروند و مدلهای تخصصی وارد میشوند. Artificial Analysis برای هر کدام لیدربورد جداگانهای دارد که بر پایهٔ رأی کور کاربران و امتیاز Elo ساخته میشود.
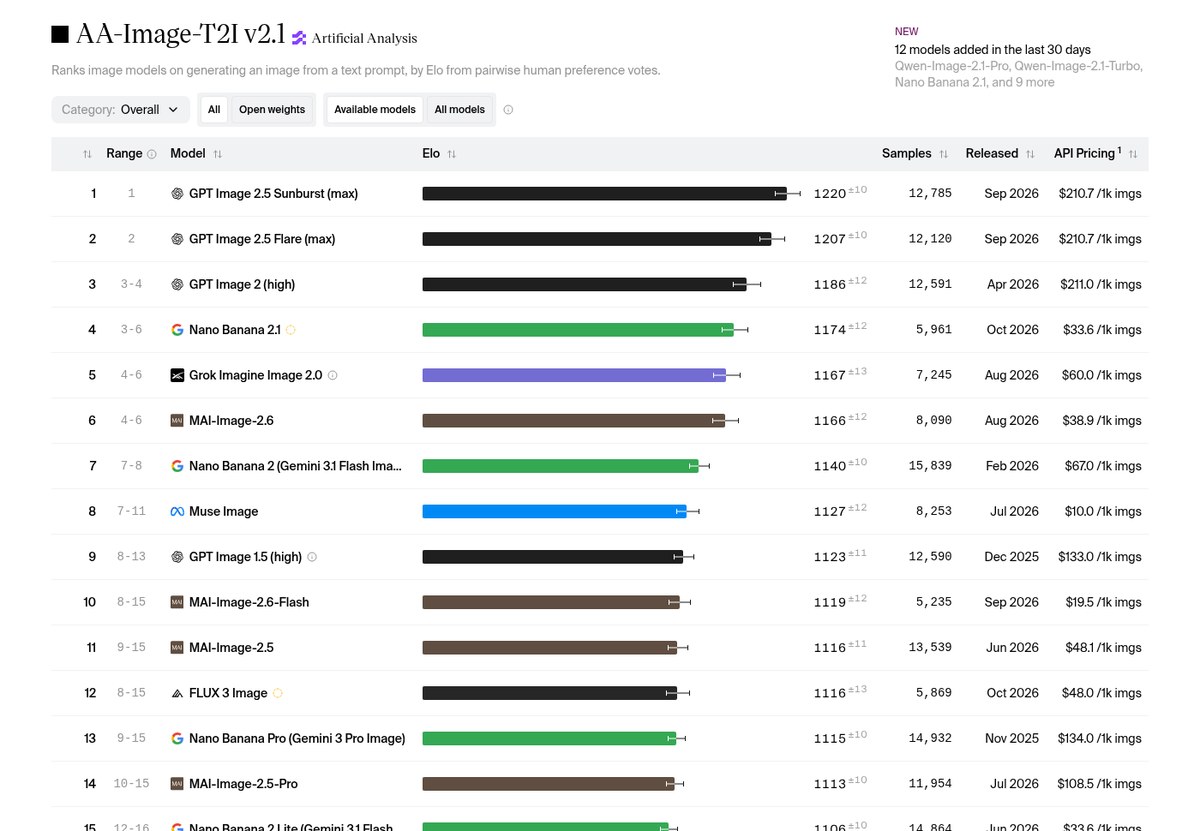
مدلهای تصویری OpenAI سه رتبهٔ اول را دارند، اما Nano Banana 2.1 گوگل با حدود یکششم قیمت در رتبهٔ چهارم است و برای بیشتر کاربردها انتخاب اقتصادیتری است. اگر دنبال گزینههای رایگان هستید، مقالهٔ بهترین هوش مصنوعی رایگان ساخت تصویر را ببینید.
لیدربورد تبدیل متن به تصویر Artificial Analysis با امتیاز Elo و قیمت API هر مدل. منبع تصویر: Artificial Analysis
تولید ویدیو
رتبه
مدل
امتیاز Elo
قیمت API
1
Wan 3.0
1174
$12.00 در دقیقه
2
Utopai X
1169
API ندارد
3
Dreamina Seedance 2.5
1160
$34.12 در دقیقه
4
MiniMax H3 (768p)
1159
$4.80 در دقیقه
6
FLUX 3
1146
$17.40 در دقیقه
8
Gemini Omni Flash 1.1
1132
$9.12 در دقیقه
منبع: Artificial Analysis Text-to-Video Leaderboard، ویدیو همراه با صدا (دریافت: ۲۷ مهر ۱۴۰۵).
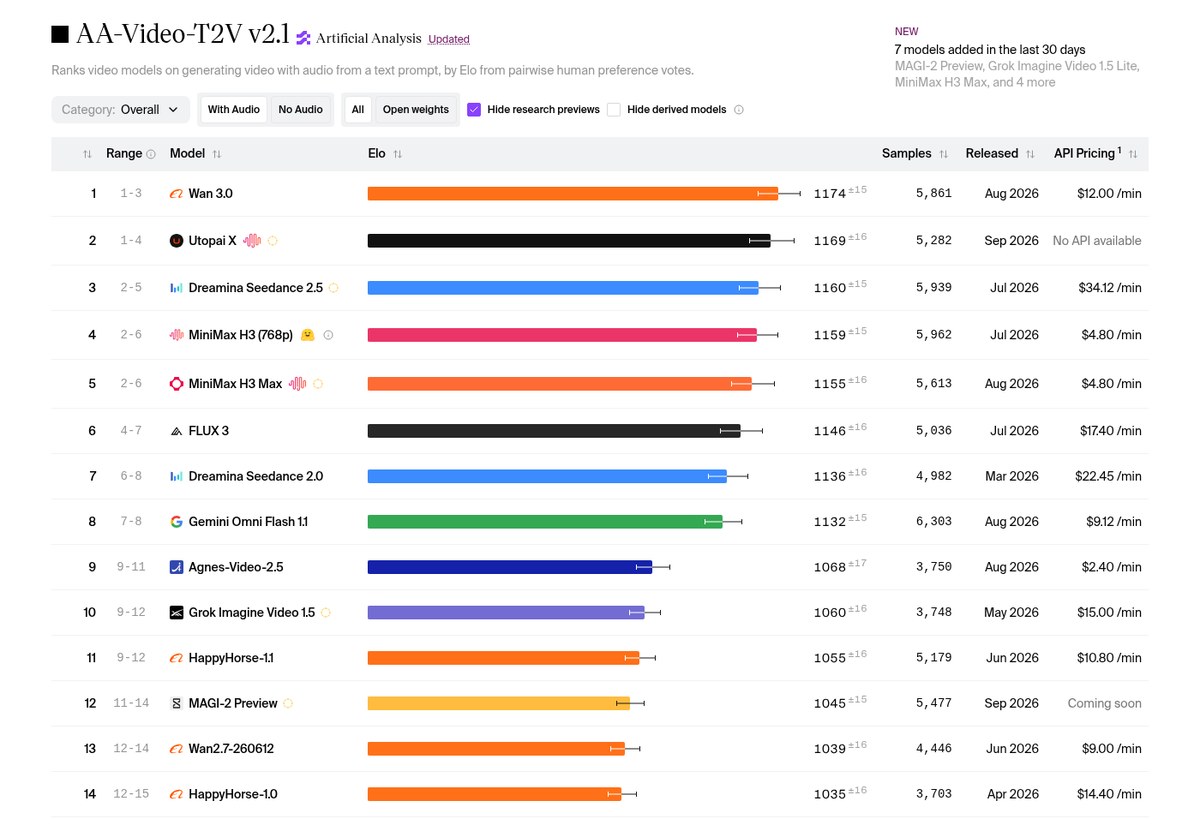
در ویدیو رقابت بسیار نزدیک است و چهار مدل اول فقط ۱۵ امتیاز با هم فاصله دارند. MiniMax H3 با ۴.۸ دلار در دقیقه بهترین نسبت کیفیت به قیمت را در بالای جدول دارد.
لیدربورد تبدیل متن به ویدیو Artificial Analysis. منبع تصویر: Artificial Analysis
صدا: تبدیل متن به گفتار و گفتار به متن
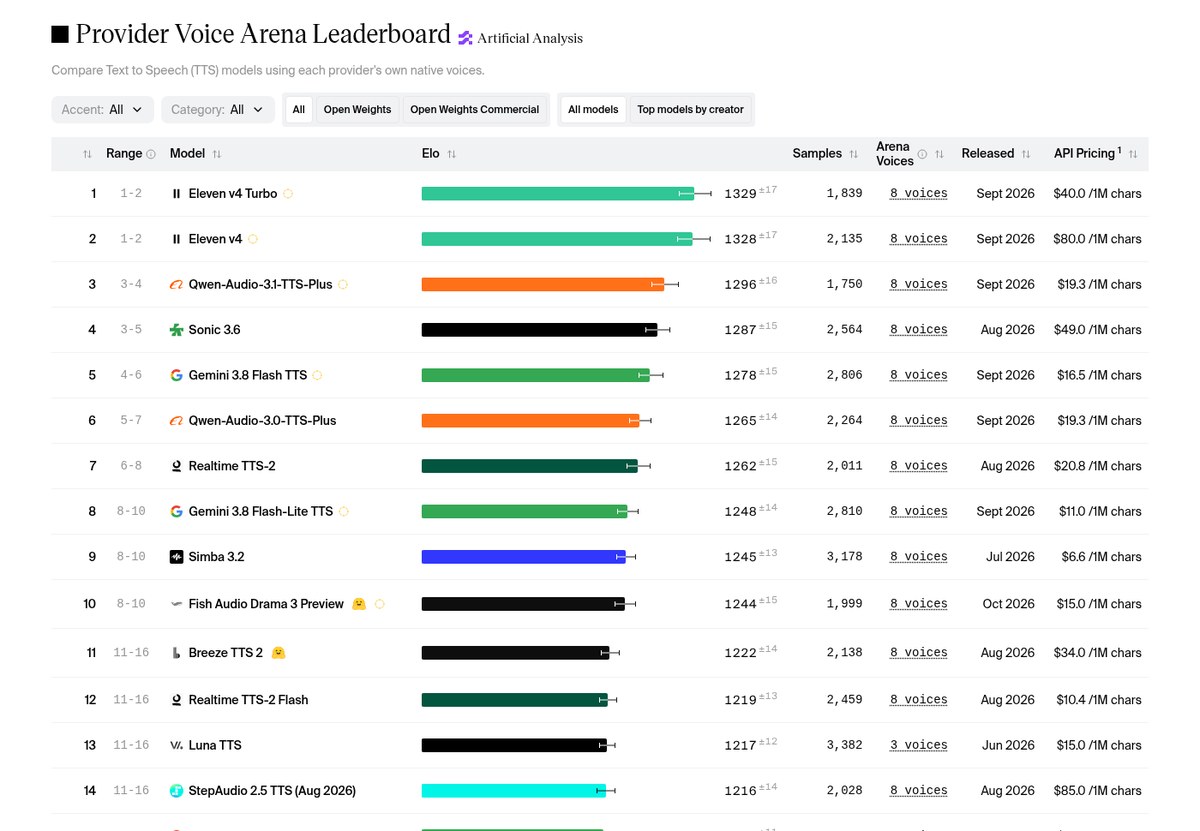
در تبدیل متن به گفتار (TTS)، Eleven v4 Turbo با امتیاز ۱۳۲۹ و قیمت ۴۰ دلار برای هر یک میلیون کاراکتر اول است و Eleven v4 با ۱۳۲۸ دوم. Qwen-Audio-3.1-TTS-Plus با ۱۲۹۶ امتیاز و قیمت ۱۹.۳ دلار، و Gemini 3.8 Flash TTS با ۱۲۷۸ امتیاز و ۱۶.۵ دلار، گزینههای ارزانتری هستند.
در تبدیل گفتار به متن (STT)، معیار اصلی نرخ خطای کلمه (WER) است. طبق Artificial Analysis، کمترین خطا متعلق به Fun-Realtime-ASR-preview با ۱.۷ درصد است و MAI-Transcribe-2 با ۲.۰ درصد، ElevenLabs Scribe v2 با ۲.۲ درصد، Grok Voice Transcribe 2.0 با ۲.۳ درصد و Gemini 3.5 Transcribe با ۲.۶ درصد پشت سر آن هستند. این آزمونها روی زبان فارسی انجام نشدهاند، پس برای فایلهای فارسی حتماً خودتان آزمایش کنید. دربارهٔ کاربردها و ریسکهای شبیهسازی صدا هم در مقالهٔ تقلید صدا با هوش مصنوعی نوشتهایم.
لیدربوردها نقطهٔ شروع خوبیاند، اما کار شما با کار میانگین کاربران فرق دارد. یک آزمایش کوچک و منظم معمولاً بهتر از ساعتها خواندن مقایسه جواب میدهد. این روش ساده را امتحان کنید:
پنج نمونهٔ واقعی جمع کنید. مثلاً سه ایمیل واقعی که باید جواب بدهید، یک متن برای ترجمه و یک فایل داده. نمونهها باید شبیه کار روزمرهٔ خودتان باشند، نه سؤالهای عمومی.
یک پرامپت ثابت بنویسید. همان دستورالعمل را بدون تغییر به همهٔ مدلها بدهید تا مقایسه منصفانه باشد.
دو یا سه مدل را کنار هم بگذارید. معمولاً یک مدل پرچمدار، یک مدل میانرده و یک مدل ارزان کافی است.
خروجیها را بدون نام مدل مقایسه کنید. اگر ممکن است، از یک همکار بخواهید بدون دانستن نام مدل، بهترین پاسخ را انتخاب کند؛ همان کاری که LMArena در مقیاس میلیونی انجام میدهد.
زمان و هزینه را هم یادداشت کنید. مدلی که پاسخ کمی بهتری میدهد اما سه برابر کندتر است، شاید برای کار روزمرهٔ شما مناسب نباشد.
این آزمایش را هر چند ماه یکبار تکرار کنید. همانطور که در رتبهبندیهای این مقاله دیدید، جای مدلها مدام عوض میشود و مدلی که امروز بهترین گزینهٔ شماست، ممکن است چند ماه دیگر رقیب ارزانتر و بهتری پیدا کند.
اشتباههای رایج در انتخاب هوش مصنوعی
انتخاب فقط بر اساس شهرت: معروفترین چتبات لزوماً بهترین ابزار برای کار تخصصی شما نیست.
بیتوجهی به سطح استدلال: روشن کردن بالاترین سطح فکر کردن برای سؤالهای ساده فقط زمان و هزینه را بالا میبرد.
اعتماد بیچونوچرا به خروجی: همهٔ مدلها گاهی اطلاعات نادرست تولید میکنند؛ عددها، نقلقولها و منابع را همیشه بررسی کنید.
فراموش کردن حریم خصوصی: قبل از فرستادن اطلاعات محرمانه، سیاست استفاده از دادههای هر سرویس را بخوانید.
سؤالات متداول دربارهٔ انتخاب بهترین هوش مصنوعی
کدام هوش مصنوعی بهتر است؛ ChatGPT، Claude یا Gemini؟
هیچکدام در همهچیز بهترین نیست. طبق دادههای مهر ۱۴۰۵، Claude در کدنویسی و استدلال پیشتاز است، Gemini 4 Argon در رأی کاربران LMArena برای گفتگوهای متنی اول است و مدلهای OpenAI در تولید تصویر و نسبت کیفیت به هزینه (GPT-6.1 Sol) میدرخشند.
بهترین هوش مصنوعی رایگان کدام است؟
هر سه سرویس ChatGPT، Claude و Gemini پلن رایگان دارند. برای توسعهدهندهها هم Gemini 3.8 Flash و Gemini 3.5 Flash-Lite در Gemini API سطح رایگان دارند که برای تست و پروژههای کوچک مناسب است.
بهترین AI ۲۰۲۶ برای تولید تصویر کدام است؟
طبق لیدربورد Artificial Analysis، GPT Image 2.5 Sunburst با امتیاز ۱۲۲۰ اول است. اگر هزینه برایتان مهم است، Nano Banana 2.1 با امتیاز ۱۱۷۴ و قیمتی حدود یکششم، انتخاب بهصرفهتری است.
آیا لازم است برای هر کار یک ابزار جدا بخرم؟
خیر. برای بیشتر کاربران یک اشتراک چتبات اصلی کافی است، چون این سرویسها نوشتن، تحلیل فایل و ساخت تصویر را در یکجا ارائه میدهند. ابزارهای تخصصی فقط وقتی ارزش دارند که آن کار را زیاد و حرفهای انجام میدهید.
کدام هوش مصنوعی فارسی را بهتر میفهمد؟
لیدربوردهای مرجع کیفیت فارسی را جداگانه گزارش نمیکنند. بهترین راه این است که یک متن نمونهٔ فارسی از کار خودتان را به دو یا سه مدل برتر بدهید و نتیجه را مقایسه کنید.
جمعبندی
بهترین هوش مصنوعی آن است که با کار، سرعت مورد نیاز و بودجهٔ شما جور باشد. در مهر ۱۴۰۵، Claude در کدنویسی و استدلال، Gemini 4 Argon در گفتگو و نوشتن، GPT Image 2.5 در تصویر، Wan 3.0 در ویدیو و مدلهای ElevenLabs در صدا پیشتازند؛ و تقریباً در هر دسته، یک گزینهٔ اقتصادی با کیفیت نزدیک وجود دارد. پیشنهاد ما این است که با پلن رایگان یکی از چتباتهای اصلی شروع کنید و فقط وقتی به سقف آن رسیدید یا کار تخصصی داشتید، سراغ ابزار یا پلن گرانتر بروید.
اگر میخواهید کار با این ابزارها را اصولی و قدمبهقدم یاد بگیرید، دورهٔ کپسول هوش مصنوعی رادینو برای شما طراحی شده است.



نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.