اگر در یک سال اخیر خبر انتشار مدلهای هوش مصنوعی را دنبال کرده باشید، احتمالاً جملهای مثل «این مدل در شاخص Artificial Analysis رتبهٔ چهارم را گرفت» را شنیدهاید. Artificial Analysis امروز یکی از پراستنادترین مرجعهای مستقل برای مقایسهٔ مدلهای زبانی، تصویری، ویدیویی و صوتی است. در این راهنما توضیح میدهیم این سایت چیست، عددهایش چطور ساخته میشوند، صفحههای مختلفش را چطور بخوانید و چطور با کمک آن مدل مناسب کار خودتان را انتخاب کنید.
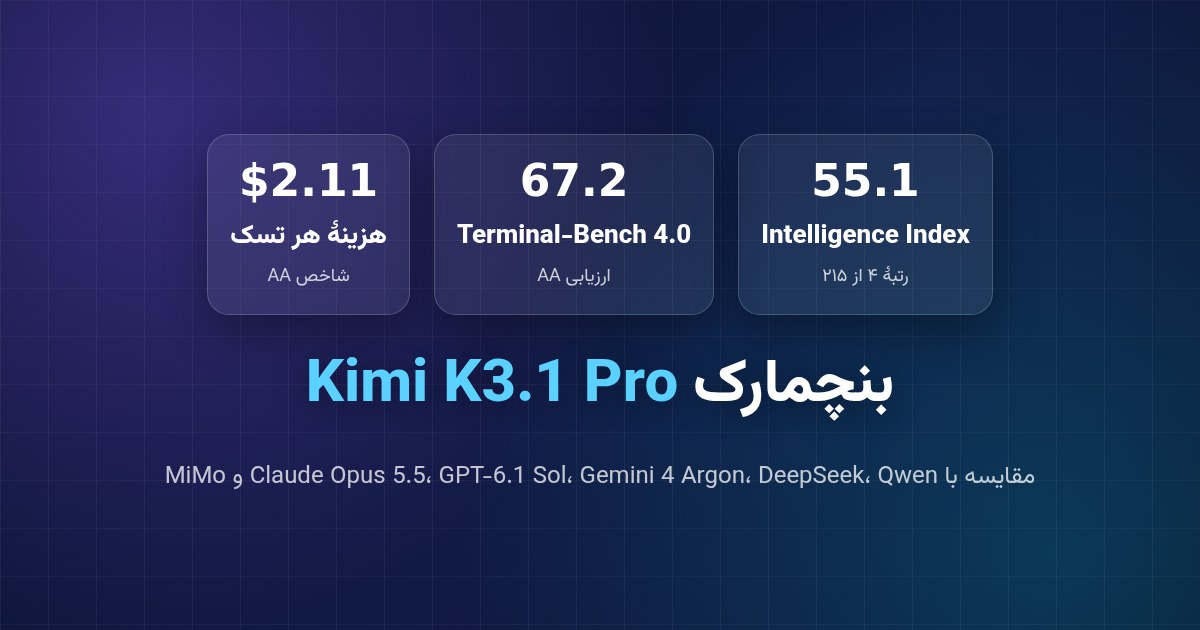
برای اینکه راهنما کاربردی باشد، همهجا مثال واقعی آوردهایم: مدل تازهٔ Kimi K3.1 Pro که ۱ آبان ۱۴۰۵ منتشر شد. تحلیل کامل عددهای آن را در مقالهٔ بنچمارک Kimi K3.1 Pro آوردهایم.
آخرین بهروزرسانی: ۲ آبان ۱۴۰۵ — همهٔ عددها و توضیحات از صفحههای رسمی artificialanalysis.ai (صفحهٔ اصلی، روششناسی، درباره، مستندات API و جدولها) برداشته شدهاند (دریافت: ۲ آبان ۱۴۰۵).
⚡ پاسخ کوتاه
Artificial Analysis یک شرکت مستقل ارزیابی هوش مصنوعی در سانفرانسیسکو است. مدلها، ارائهدهندگان API و حتی تراشهها را با یک روش ثابت آزمایش میکند. مهمترین خروجی آن «شاخص هوش» (Intelligence Index) است که در نسخهٔ ۴.۳.۲ میانگین وزنی ۱۰ ارزیابی است. کنار آن، سرعت (توکن در ثانیه)، تأخیر، قیمت و «هزینهٔ هر تسک» را هم منتشر میکند. استفاده از سایت رایگان است و یک API رایگان با سقف ۱,۰۰۰ درخواست در روز دارد. برای انتخاب مدل هر سه بُعد هوش، سرعت و هزینه را با هم ببینید، نه فقط رتبهٔ اول را.
طبق صفحهٔ درباره، Artificial Analysis خود را «شرکت مستقل بنچمارک هوش مصنوعی» معرفی میکند. این شرکت ایجنتها و مدلها، ابرهایی که آنها را سرو میکنند و تراشههایی که روی آنها اجرا میشوند را اندازه میگیرد. همبنیانگذاران آن Micah Hill-Smith (مدیرعامل) و George Cameron (مدیر محصول) هستند و هر دو در سانفرانسیسکو مستقرند. در فهرست حامیان مالی نامهایی مثل Nat Friedman، Daniel Gross، Andrew Ng، Adam D'Angelo و Clem Delangue (مدیرعامل Hugging Face) دیده میشود.
ابعاد کار این سایت طبق همان صفحه:
بیش از ۵۰۰ مدل ارزیابیشده،
بیش از ۱۰۰ ارائهدهندهٔ استنتاج (Inference provider)،
بیش از ۱,۰۰۰ اندپوینت API،
بیش از ۱ تریلیون توکن ارزیابی.
چهار حوزهٔ اصلی سنجش آن اینهاست: ایجنتها (مدل همراه با هارنس و ابزار برای کارهای چندمرحلهای)، مدلها (زبانی، تصویری، ویدیویی، گفتاری و موسیقی، چه اختصاصی و چه وزنباز)، ابر (زیرساخت سرو مدلها) و تراشهها (GPUهای NVIDIA و AMD، TPU گوگل، AWS Trainium، Cerebras و SambaNova).
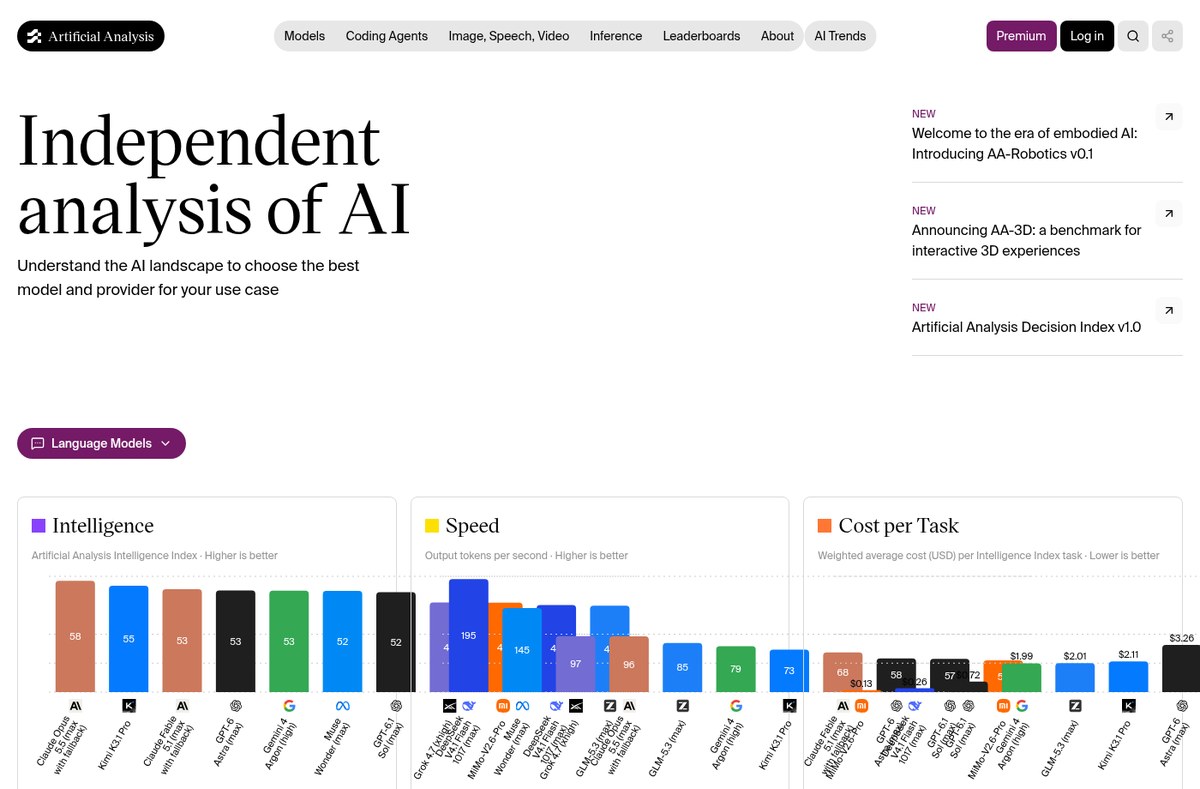
صفحهٔ اصلی Artificial Analysis با سه نمودار هوش، سرعت و هزینهٔ هر تسک (۲ آبان ۱۴۰۵). منبع تصویر: Artificial Analysis
چرا Artificial Analysis مهم شده است؟
سازندههای مدل معمولاً عددهای خودشان را با تنظیمات دلخواه منتشر میکنند. Artificial Analysis همهٔ مدلها را با پرامپتها، تنظیمات و روش امتیازدهی یکسان اجرا میکند و برای همین مقایسهاش منصفانهتر است. نتیجه این شده که آزمایشگاههای بزرگ هم خودشان به عددهای آن استناد میکنند. برای مثال، کارت مدل Kimi K3 در Hugging Face برای بخشی از نمرات مقایسهای خود به Artificial Analysis ارجاع داده است. صفحهٔ درباره هم میگوید آزمایشگاهها، رسانهها و مؤسسههای پیشرو به عددهای آن استناد میکنند. اگر با مفهوم بنچمارک تازه آشنا شدهاید، راهنمای بنچمارکهای هوش مصنوعی پیشزمینهٔ خوبی است.
شاخص هوش (Intelligence Index) چطور ساخته میشود؟
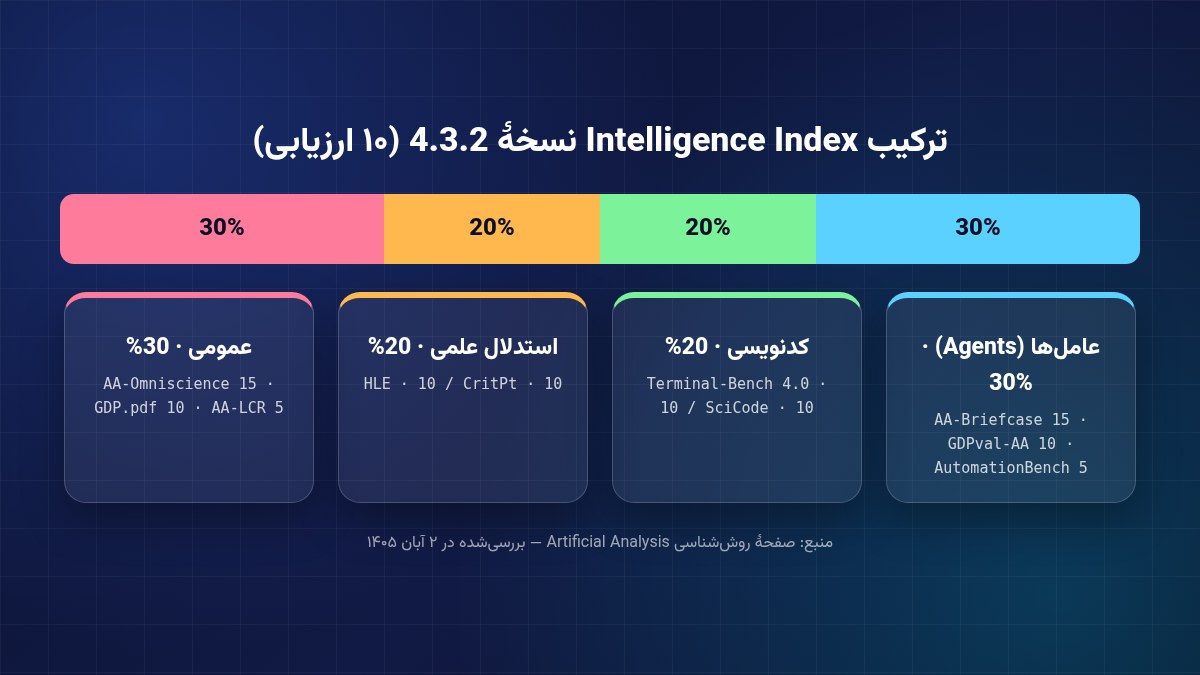
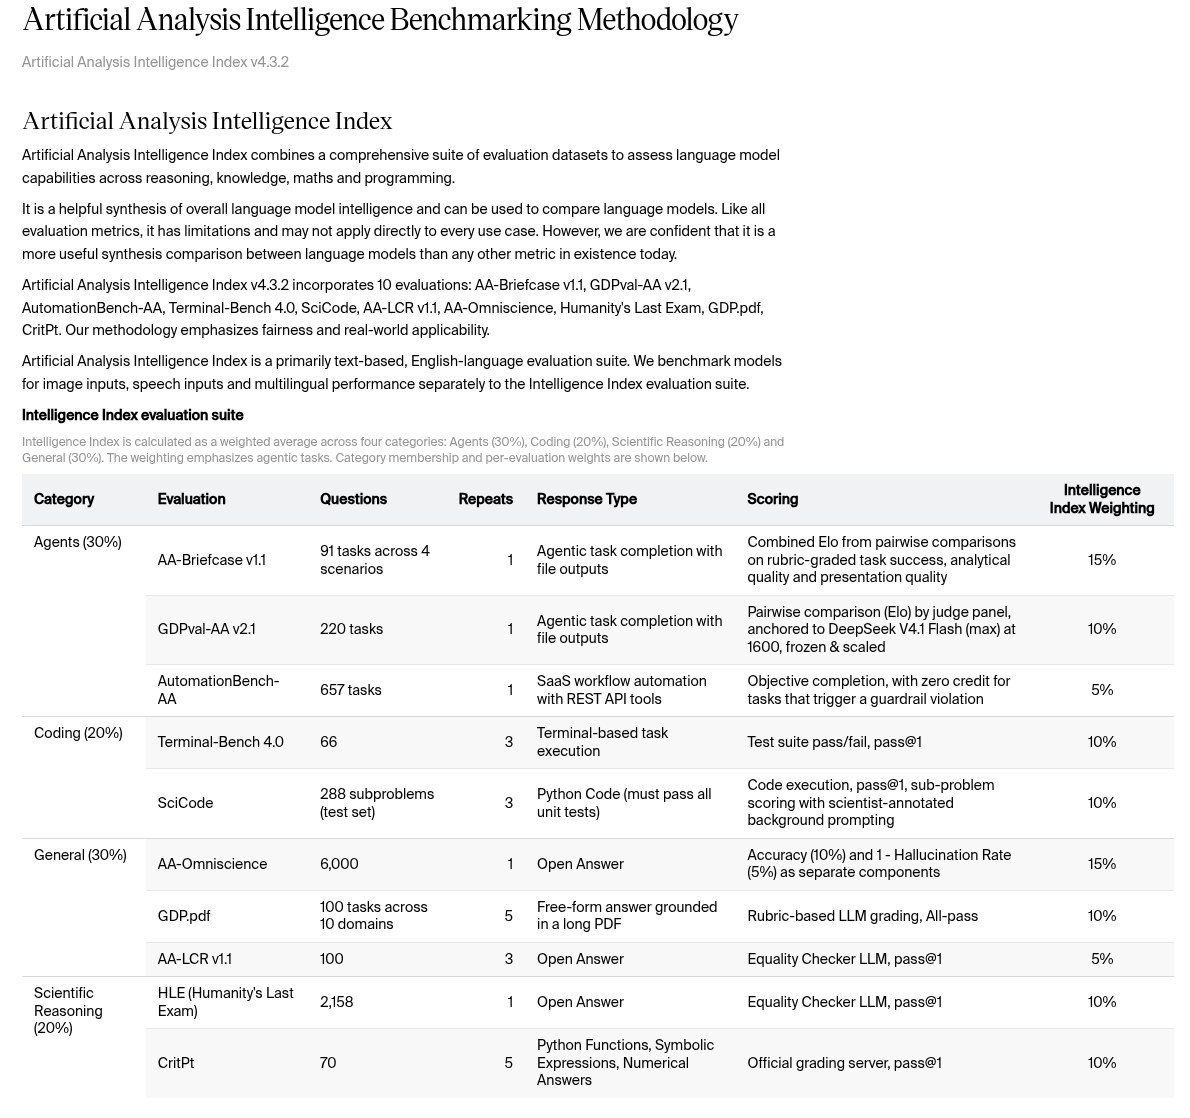
معروفترین عدد سایت شاخص هوش است. طبق صفحهٔ روششناسی، نسخهٔ ۴.۳.۲ این شاخص ۱۰ ارزیابی را در چهار دسته ترکیب میکند. وزندهی عمداً روی کارهای ایجنتی تأکید دارد:
دسته (وزن)
ارزیابی
وزن در شاخص
چه میسنجد
ایجنتها (۳۰٪)
AA-Briefcase v1.1
۱۵٪
انجام کار ایجنتی با خروجی فایل (۹۱ تسک در ۴ سناریو)
GDPval-AA v2.1
۱۰٪
۲۲۰ تسک کاری واقعی؛ مقایسهٔ زوجی Elo
AutomationBench-AA
۵٪
خودکارسازی گردشکار SaaS با ابزار REST
کدنویسی (۲۰٪)
Terminal-Bench 4.0
۱۰٪
اجرای وظایف در ترمینال
SciCode
۱۰٪
کد پایتون علمی
استدلال علمی (۲۰٪)
Humanity's Last Exam
۱۰٪
۲,۱۵۸ پرسش بسیار سخت
CritPt
۱۰٪
مسائل پژوهشی فیزیک
عمومی (۳۰٪)
AA-Omniscience
۱۵٪
دانش (۱۰٪) و نزدن توهم (۵٪)
GDP.pdf
۱۰٪
پاسخ مبتنی بر PDF طولانی
AA-LCR v1.1
۵٪
استدلال روی زمینهٔ طولانی
ترکیب شاخص هوش نسخهٔ ۴.۳.۲: چهار دسته و ۱۰ ارزیابی. منبع تصویر: تحریریه رادینو
نکتههای مهم روششناسی
امتیاز pass@1: در بیشتر ارزیابیها مدل باید در اولین تلاش درست جواب بدهد. اگر آزمون چند بار تکرار شود، میانگین تکرارها حساب میشود.
Elo برای کارهای باز: در GDPval-AA و AA-Briefcase خروجیها دوبهدو با هیئت داوران مقایسه میشوند. GDPval روی DeepSeek V4.1 Flash (max) با امتیاز ۱۶۰۰ لنگر شده است.
توکنشماری واقعی: برای محاسبهٔ هزینهٔ شاخص، Artificial Analysis تعداد توکنهایی را استفاده میکند که ارائهدهندهٔ API خودش گزارش کرده است. نرخ واقعی کش هم بهصورت زنده اندازهگیری و در هزینه لحاظ میشود.
آزمونهای قدیمی کنار گذاشته میشوند: GPQA Diamond، MMLU-Pro، AIME 2025، LiveCodeBench و MATH-500 اکنون در بخش «Legacy» هستند، یعنی ارزیابیهایی که بازنشسته یا جایگزین شدهاند و دیگر در شاخص حساب نمیشوند. GPQA Diamond از نسخهٔ ۴.۲ از شاخص حذف شد، ولی هنوز روی مدلهای جدید اجرا و جداگانه گزارش میشود.
نسخهها عوض میشوند: با هر نسخهٔ جدید شاخص، عددها تغییر میکنند. امتیاز یک مدل در v4.3.2 را نباید با نسخههای قبلی مقایسه کرد.
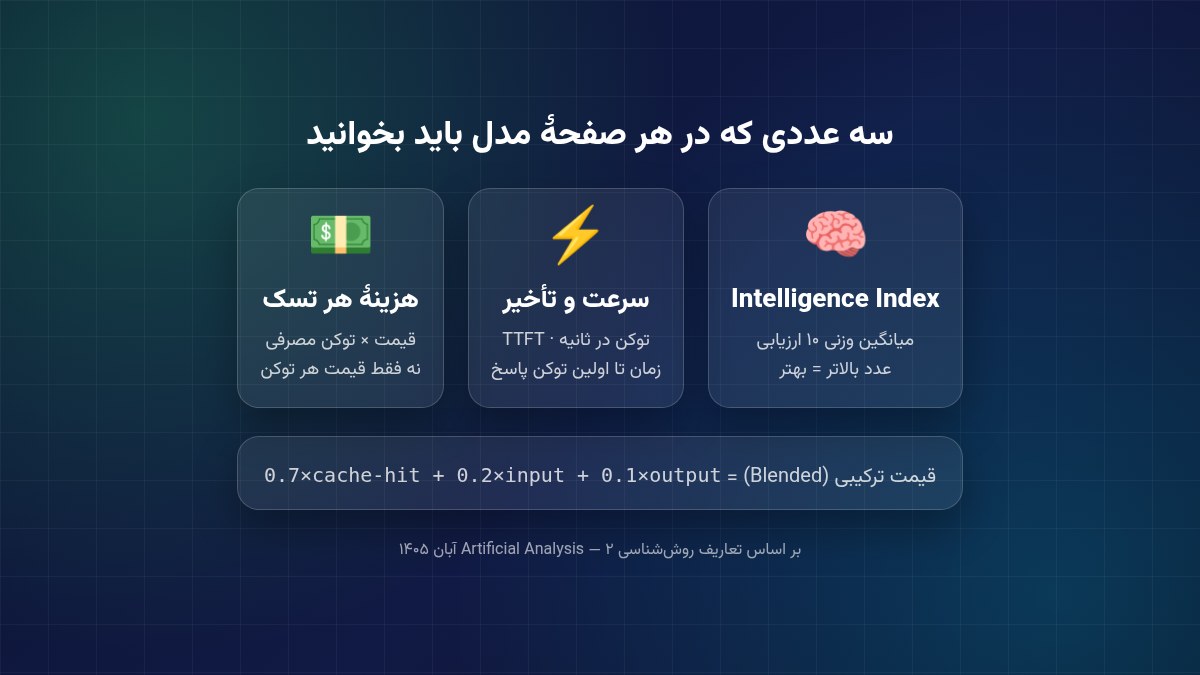
وقتی صفحهٔ یک مدل را باز میکنید، مثلاً artificialanalysis.ai/models/kimi-k3-1-pro، با دهها نمودار روبهرو میشوید. برای تصمیمگیری، این سه عدد از همه مهمترند:
سه عدد کلیدی هر صفحهٔ مدل و فرمول قیمت ترکیبی. منبع تصویر: تحریریه رادینو
۱. هوش
عدد شاخص هوش و رتبهٔ مدل بین همهٔ مدلها. برای Kimi K3.1 Pro این عدد ۵۵.۱ است که رتبهٔ ۴ را دارد. صفحهٔ مدل جزئیات هر ۱۰ ارزیابی را هم نشان میدهد. این جزئیات مهماند، چون ممکن است مدلی در امتیاز کل متوسط باشد اما دقیقاً در ارزیابی مرتبط با کار شما (مثلاً Terminal-Bench برای کدنویسی) عالی باشد.
۲. سرعت و تأخیر
طبق روششناسی سنجش عملکرد، سرعت با چند نوع بار کاری اندازهگیری میشود: ورودی ۱ هزار، ۱۰ هزار (پیشفرض سایت) و ۱۰۰ هزار توکنی، و بار کاری تصویری. آزمونهای ۱ هزار و ۱۰ هزار توکنی ۸ بار در روز (تقریباً هر ۳ ساعت) اجرا میشوند و عدد نمایشدادهشده میانهٔ (P50) ۷۲ ساعت گذشته است. آزمون ۱۰۰ هزار توکنی هفتهای یک بار اجرا میشود و میانهٔ ۱۴ روز را نشان میدهد. هر اجرا با یک پرامپت تازه و یکتا انجام میشود.
سرعت خروجی (Output Speed): توکن در ثانیه، پس از رسیدن اولین توکن.
زمان تا اولین توکن (TTFT): فاصلهٔ ارسال درخواست تا اولین توکن. در مدلهای استدلالی، این اولین توکن «فکر» است.
زمان تا اولین توکن پاسخ: برای مدلهای استدلالی، زمان رسیدن اولین توکن خود پاسخ. این عدد تجربهٔ واقعی کاربر را بهتر نشان میدهد.
مثال: Kimi K3.1 Pro سرعت ۷۳.۵ توکن در ثانیه و TTFT حدود ۲.۹۷ ثانیه دارد، اما اولین توکن پاسخ آن بهطور میانگین بعد از ۳۰.۲ ثانیه میرسد.
۳. هزینهٔ هر تسک، نه فقط قیمت هر توکن
قیمت هر میلیون توکن گمراهکننده است، چون مدلها برای یک کار یکسان تعداد توکن بسیار متفاوتی تولید میکنند. Artificial Analysis دو عدد منتشر میکند. اول قیمت ترکیبی (Blended) است که با فرمول ۰.۷ × قیمت ورودی کششده + ۰.۲ × قیمت ورودی + ۰.۱ × قیمت خروجی محاسبه میشود. دوم هزینهٔ هر تسک شاخص است که هزینهٔ واقعی اجرای یک تسک را با توکنهای واقعی مصرفشده نشان میدهد. برای مثال، Kimi K3.1 Pro و GPT-6.1 Sol هر دو قیمت ۲/۱۰ دلار دارند، اما هزینهٔ هر تسک اولی ۲.۱۱ دلار و دومی ۰.۷۲ دلار است. برای محاسبهٔ هزینه در پروژهٔ خودتان راهنمای قیمت API مدلهای هوش مصنوعی را ببینید.
بخشهای مهم سایت
جدول مدلهای زبانی (LLM Leaderboard)
صفحهٔ Leaderboards › Models همهٔ مدلها را با هوش، سرعت، تأخیر، قیمت و پنجرهٔ زمینه در یک جدول میآورد. میتوانید فیلترها را روی وزنباز یا اختصاصی، متنی یا چندوجهی، و کشور سازنده بگذارید. نمودار پیشفرض صفحهٔ اصلی ۲۷ مدل از ۷۰۸ مدل را نشان میدهد و با دکمهٔ «Add model» مدلهای دیگر را اضافه میکنید. برای خلاصهٔ فارسی این جدول، رتبهبندی مدلهای هوش مصنوعی را ببینید.
مقایسهٔ ارائهدهندگان (Providers)
یک مدل وزنباز مثل DeepSeek یا Kimi K3 را ممکن است دهها شرکت ابری سرو کنند. جدول ارائهدهندگان سرعت، تأخیر و قیمت همان مدل را روی ارائهدهندههای مختلف مقایسه میکند. این بخش برای انتخاب API ارزانتر یا سریعتر برای یک مدل مشخص بسیار مفید است.
ایجنتهای کدنویسی (Coding Agents)
در بخش Coding Agents ترکیب «ابزار + مدل» سنجیده میشود، مثل Claude Code، Codex، Kimi Code CLI و Devin. در ۲ آبان ۱۴۰۵ صدر این جدول Claude Code با Claude Opus 5.5 با امتیاز ۶۱.۷ بود. این جدول برای برنامهنویسها از شاخص هوش کاربردیتر است. برای جمعبندی ابزارهای کدنویسی بهترین هوش مصنوعی برای برنامهنویسی را بخوانید.
آرنای تصویر، ویدیو و صدا
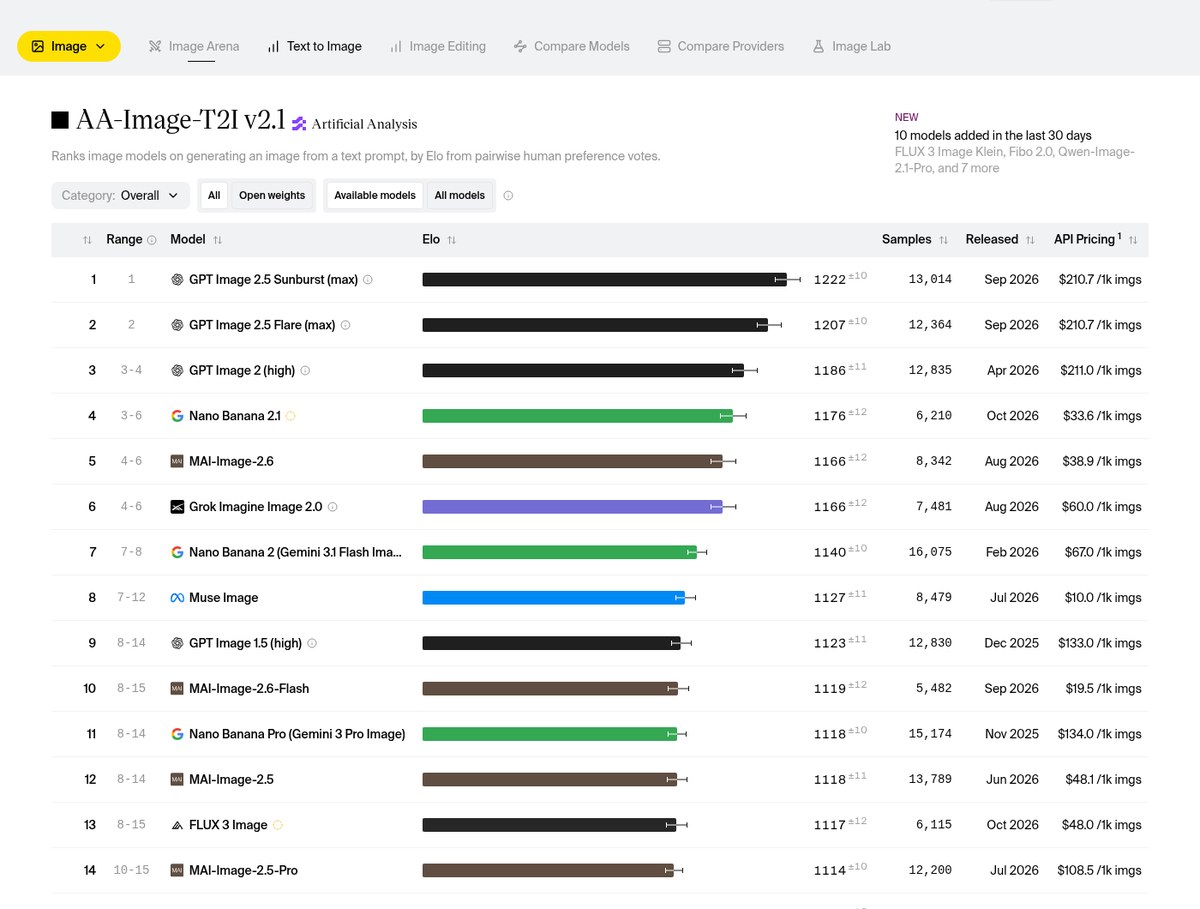
برای مدلهای تصویر و ویدیو، Artificial Analysis از رأیگیری کور دوبهدو و امتیاز Elo استفاده میکند. در جدول متن به تصویر (نسخهٔ AA-Image-T2I v2.1)، در ۲ آبان ۱۴۰۵ رتبهٔ اول GPT Image 2.5 Sunburst (max) با Elo ۱۲۲۲ بود. بعد از آن GPT Image 2.5 Flare (max) با ۱۲۰۷ و GPT Image 2 (high) با ۱۱۸۶ قرار داشتند. جدول هزینهٔ هر ۱,۰۰۰ تصویر را هم نشان میدهد، که برای GPT Image 2.5 Sunburst حدود ۲۱۰.۷ دلار و برای Nano Banana 2.1 حدود ۳۳.۶ دلار است.
جدول آرنای متن به تصویر Artificial Analysis با امتیاز Elo و قیمت هر ۱,۰۰۰ تصویر (۲ آبان ۱۴۰۵). منبع تصویر: Artificial Analysis
در جدول متن به ویدیو (AA-Video-T2V v2.1)، Wan 3.0 با Elo ۱۱۷۵ اول بود و Utopai X با ۱۱۶۷ و HeyGen Video 1 با ۱۱۶۰ بعد از آن قرار داشتند. برای هر مدل قیمت هر دقیقه ویدیو هم آمده است. بخشهای تبدیل متن به گفتار، گفتار به متن و موسیقی هم جدولهای مشابه دارند.
ابزارهای کاربردی Artificial Analysis
Model Recommender
در این ابزار اولویتهایتان را بین هوش، سرعت و هزینه مشخص میکنید و سایت بر اساس دادههای خودش چند مدل پیشنهاد میدهد. برای کسی که نمیخواهد جدولها را تکتک بخواند، نقطهٔ شروع خوبی است.
Optima: بنچمارک اختصاصی خودتان
Optima محصول جدیدتر Artificial Analysis است. با آن میتوانید روی داده و کارهای واقعی خودتان بنچمارک بسازید، مثلاً بررسی قراردادهای شرکت یا ساخت اسلاید فروش، و مدلها را از نظر کیفیت، هزینه و زمان هر تسک مقایسه کنید. طبق صفحهٔ Optima، ساخت و اجرای بنچمارک به قیمت خام توکن مدلها و بدون هزینهٔ اضافه حساب میشود. داوری روبریک با داوران استاندارد برای هر معیار و هر مدل ۰.۰۰۲ دلار است و مقایسهٔ زوجی با داوران استاندارد ۰.۰۰۶ دلار برای هر مسابقه.
Decision Index
Artificial Analysis در ۲۱ مهر ۱۴۰۵ (۱۳ اکتبر ۲۰۲۶) شاخص جدیدی برای «مدلهای تصمیم» معرفی کرد. این مدلها در یک فراخوانی، یک گزینه را از بین گزینههای ثابت با احتمال انتخاب میکنند. کاربردشان کارهایی مثل دستهبندی تیکت پشتیبانی است. نسخهٔ ۱.۰ این شاخص چهار ارزیابی دارد که هر کدام ۲۵ درصد وزن دارند: AA-Omniscience-Decision، HLE-MultiChoice، When2Call از NVIDIA و WildGuardTest از Ai2.
API رایگان داده
اگر میخواهید دادهها را در داشبورد یا ابزار خودتان استفاده کنید، Artificial Analysis یک API رایگان دارد. این API شاخصهای هوش، سرعت و قیمت را برمیگرداند. برای استفاده باید در Insights Platform حساب بسازید و کلید API بگیرید. سقف استفاده ۱,۰۰۰ درخواست در روز است و ذکر منبع (لینک به artificialanalysis.ai) برای هر استفاده الزامی است. دادههای کاملتر در API تجاری ارائه میشود.
راهنمای قدمبهقدم: انتخاب مدل با Artificial Analysis
کارتان را دقیق تعریف کنید: کدنویسی، چت پشتیبانی، تحلیل سند یا تولید تصویر؟ هر کار جدول و ارزیابی مرتبط خودش را دارد.
از ارزیابی مرتبط شروع کنید، نه شاخص کل: برای کدنویسی Terminal-Bench و Coding Agents را ببینید. برای اسناد طولانی AA-LCR و GDP.pdf، و برای دقت اطلاعات AA-Omniscience.
سه تا پنج نامزد انتخاب کنید و در نمودار «Intelligence vs. Cost per Task» جایشان را ببینید. مدلهای بالا-چپ نمودار بهصرفهترند.
سرعت را با کاربرد بسنجید: برای چت زنده، زمان تا اولین توکن پاسخ مهم است. برای پردازش دستهای، هزینه مهمتر است.
ارائهدهنده را مقایسه کنید: اگر مدل وزنباز است، در جدول Providers ارزانترین یا سریعترین API را پیدا کنید.
روی دادهٔ خودتان تست کنید: عدد بنچمارک فقط فهرست کوتاه میسازد. تصمیم نهایی را با ۲۰ تا ۵۰ نمونهٔ واقعی از کار خودتان بگیرید، یا با ابزاری مثل Optima.
زبان فارسی سنجیده نمیشود: طبق روششناسی، شاخص هوش «عمدتاً متنی و انگلیسیزبان» است. شاخص چندزبانهٔ جداگانهٔ سایت (بر پایهٔ Global-MMLU-Lite) ۱۶ زبان را پوشش میدهد، از جمله عربی، هندی و بنگالی، اما فارسی در این فهرست نیست. پس عملکرد مدلها در فارسی را باید خودتان آزمایش کنید.
به برچسبهای کنار نام دقت کنید: بعضی ردیفها برچسبهای اضافه دارند، مثل «Claude Sonnet 5.5 (Medium, Default Fallback)». این برچسبها یعنی پیکربندی آن ردیف با نسخهٔ معمولی فرق دارد. قبل از مقایسه، توضیح همان ردیف را در صفحهٔ مدل بخوانید.
سطح استدلال: یک مدل با سطوح Low، High یا Max چند ردیف جدا در جدول دارد. همیشه همان سطحی را مقایسه کنید که واقعاً استفاده میکنید.
زمانمندی: عددها مدام بهروز میشوند. مثلاً هزینهٔ هر تسک Kimi K3.1 Pro در مقالهٔ روز انتشار ۱.۹۸ دلار بود و یک روز بعد در صفحهٔ مدل ۲.۱۱ دلار شد. هنگام نقل هر عدد تاریخش را هم بنویسید.
اختصاصی یا وزنباز: عنوان مقالهٔ Artificial Analysis دربارهٔ Kimi K3.1 Pro میگوید این مدل «پس از انتشار وزنها» در صدر مدلهای وزنباز قرار خواهد گرفت. یعنی تا آن زمان در دستهٔ وزنباز حساب نمیشود. در فیلتر Open Weights همیشه وضعیت فعلی هر مدل را چک کنید.
💡 نکتهٔ عملی: اگر قرار است عددی از Artificial Analysis را در گزارش یا مقاله نقل کنید، نسخهٔ شاخص (مثلاً v4.3.2)، سطح استدلال مدل و تاریخ دریافت را کنارش بنویسید. بدون این سه، عدد قابل راستیآزمایی نیست.
سؤالات متداول
Artificial Analysis رایگان است؟
بله. همهٔ جدولها و صفحههای مدل رایگان در دسترساند. یک API رایگان با سقف ۱,۰۰۰ درخواست در روز و الزام ذکر منبع هم وجود دارد. API تجاری و ابزار Optima هزینه دارند.
شاخص هوش Artificial Analysis از چه آزمونهایی تشکیل شده است؟
نسخهٔ ۴.۳.۲ از ۱۰ ارزیابی تشکیل شده است: AA-Briefcase، GDPval-AA، AutomationBench-AA، Terminal-Bench 4.0، SciCode، Humanity's Last Exam، CritPt، AA-Omniscience، GDP.pdf و AA-LCR. وزنها اینطور است: ایجنتها ۳۰، کدنویسی ۲۰، استدلال علمی ۲۰ و عمومی ۳۰ درصد.
فرق Artificial Analysis با LMArena چیست؟
Artificial Analysis مدلها را با آزمونهای خودکار و استاندارد میسنجد و سرعت و قیمت را هم اندازه میگیرد. LMArena بر اساس رأی کاربران در مقایسههای کور دوبهدو کار میکند. البته Artificial Analysis برای تصویر و ویدیو آرنای رأیگیری خودش را هم دارد.
هزینهٔ هر تسک در Artificial Analysis یعنی چه؟
میانگین هزینهٔ دلاری اجرای یک تسک از ارزیابیهای شاخص هوش، با توکنهای واقعیای که مدل مصرف کرده است، شامل استدلال، پاسخ، ورودی و کش. این عدد از قیمت هر توکن برای مقایسهٔ هزینهٔ واقعی دقیقتر است.
سرعت مدلها در Artificial Analysis چطور اندازهگیری میشود؟
بارهای کاری ۱ هزار و ۱۰ هزار توکنی ۸ بار در روز با پرامپت یکتا اجرا میشوند و عدد نمایشدادهشده میانهٔ ۷۲ ساعت گذشته است. بار ۱۰۰ هزار توکنی هفتگی اجرا میشود.
چرا GPQA در شاخص Artificial Analysis نیست؟
GPQA Diamond (۱۹۸ پرسش) از نسخهٔ ۴.۲ از شاخص حذف و به بخش Legacy منتقل شد. MMLU-Pro، AIME 2025، MATH-500 و LiveCodeBench هم در همین بخش هستند. با این حال GPQA هنوز روی مدلهای جدید اجرا و جداگانه گزارش میشود.
جمعبندی
Artificial Analysis امروز یکی از کاملترین مرجعهای مستقل برای مقایسهٔ مدلهای هوش مصنوعی است. شاخص هوش آن تصویر کلی میدهد، ارزیابیهای جزئی نشان میدهند مدل در کار شما چقدر خوب است، و سرعت و هزینهٔ هر تسک تعیین میکنند استفاده از آن در عمل بهصرفه هست یا نه. درست خواندن این عددها یعنی هر سه بُعد را با هم ببینید، به نسخهٔ شاخص و تاریخ داده دقت کنید، و تصمیم نهایی را با آزمایش روی دادهٔ خودتان بگیرید. برای دیدن کاربرد این روش روی یک مدل واقعی، تحلیل بنچمارک Kimi K3.1 Pro و بررسی Kimi K3.1 Pro را بخوانید. اگر میخواهید هوش مصنوعی را ساختاریافته و کاربردی یاد بگیرید، دورهٔ کپسول هوش مصنوعی رادینو را ببینید.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.