وقتی دربارهٔ هوش مصنوعی حرف میزنیم، معمولاً فقط به «باهوشترین» مدل فکر میکنیم. اما اگر یک چتبات پشتیبانی، دستیار صوتی یا ابزار کدنویسی میسازید، سرعت به همان اندازه مهم است. کاربری که ۳۰ ثانیه منتظر شروع جواب بماند، احتمالاً صفحه را میبندد.
در این مقاله توضیح میدهیم سرعت مدل هوش مصنوعی را با چه معیارهایی میسنجند، سریعترین مدلها و ارائهدهندهها کداماند، چرا مدلهای استدلالی گاهی چند دقیقه طول میکشند و چطور میتوانید پاسخها را سریعتر کنید. دادهها از سنجش مستقل Artificial Analysis است.
آخرین بهروزرسانی: ۵ آبان ۱۴۰۵ — اعداد سرعت، میانهٔ ۷۲ ساعت اخیر در سنجشهای Artificial Analysis هستند و ممکن است روزبهروز کمی تغییر کنند.
⚡ پاسخ کوتاه
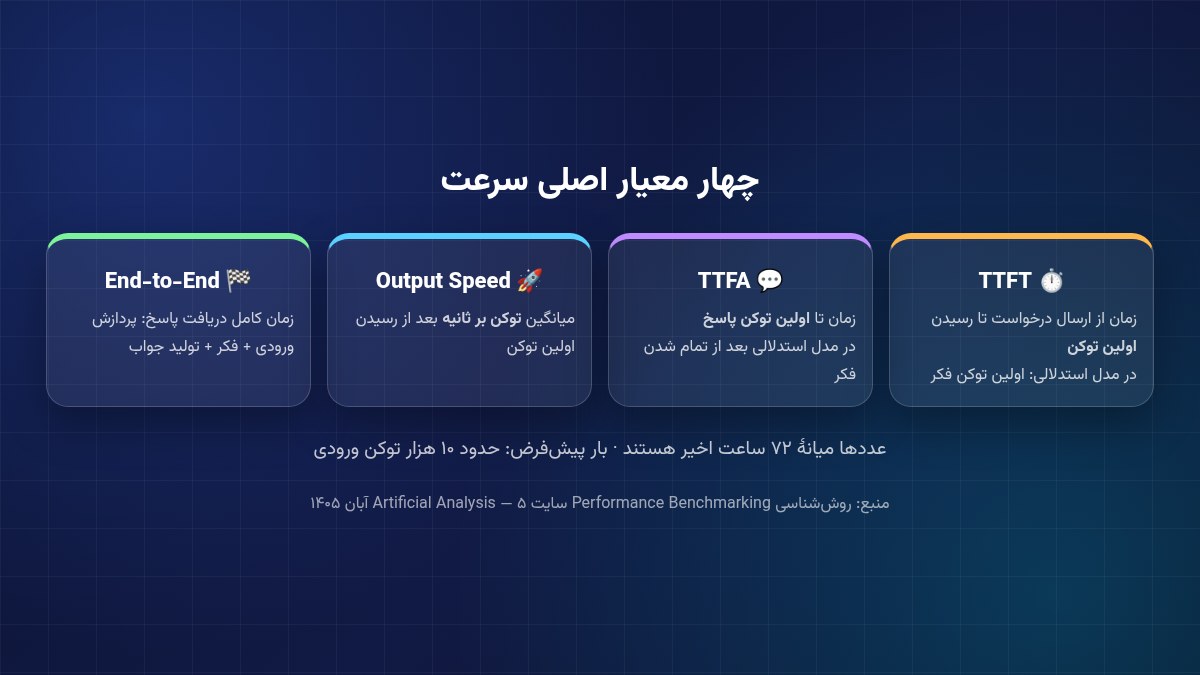
سرعت مدل هوش مصنوعی با چهار معیار سنجیده میشود: TTFT (زمان تا اولین توکن)، TTFA (زمان تا اولین توکن پاسخ، بعد از فکر کردن)، سرعت خروجی (توکن بر ثانیه) و زمان کل پاسخ. در میان مدلهای باهوش (شاخص هوش ۴۰ به بالا)، Claude Haiku 5.5 با حدود ۲۳۴ توکن بر ثانیه سریعترین است. سرعت به ارائهدهنده هم بستگی دارد: مدل وزن باز gpt-oss-120b روی Cerebras حدود ۱۸۴۲ توکن بر ثانیه و روی Scaleway حدود ۱۴۰ توکن بر ثانیه سرعت دارد. مهمترین عامل تأخیر در مدلهای استدلالی هم سطح تلاش (effort) است.
چهار معیار اصلی سرعت در روششناسی Artificial Analysis. منبع تصویر: تحریریه رادینو
Artificial Analysis در روششناسی سنجش عملکرد خود (نسخهٔ 2.2.0، مارس ۲۰۲۶) این معیارها را تعریف کرده است:
معیار
تعریف
چه زمانی مهم است؟
TTFT (Time to First Token)
زمان از ارسال درخواست تا رسیدن اولین توکن؛ در مدلهای استدلالی، اولین توکن فکر
حس پاسخگویی سریع
TTFA (Time to First Answer Token)
زمان تا اولین توکن جواب اصلی، بعد از تمام شدن فکر کردن
چتبات و دستیار صوتی
Output Speed
میانگین توکن بر ثانیه بعد از رسیدن اولین توکن
پاسخهای بلند و تولید کد
End-to-End Response Time
زمان کامل دریافت پاسخ
ایجنتها و پردازش دستهای
چند نکتهٔ روششناسی که در خواندن اعداد مهم است:
بار پیشفرض آزمون حدود ۱۰ هزار توکن ورودی است.
هر مدل روزی ۸ بار آزمایش میشود و عدد گزارششده میانهٔ ۷۲ ساعت اخیر است.
سرور آزمون در منطقهٔ us-central1-a در Google Cloud قرار دارد؛ پس TTFT شامل تأخیر شبکه هم هست.
توکنها برای همهٔ مدلها با یک توکنایزر واحد (o200k_base) شمرده میشوند تا مقایسه منصفانه باشد؛ اما توکنایزر واقعی مدلها با هم فرق دارد.
سریعترین مدلهای هوش مصنوعی
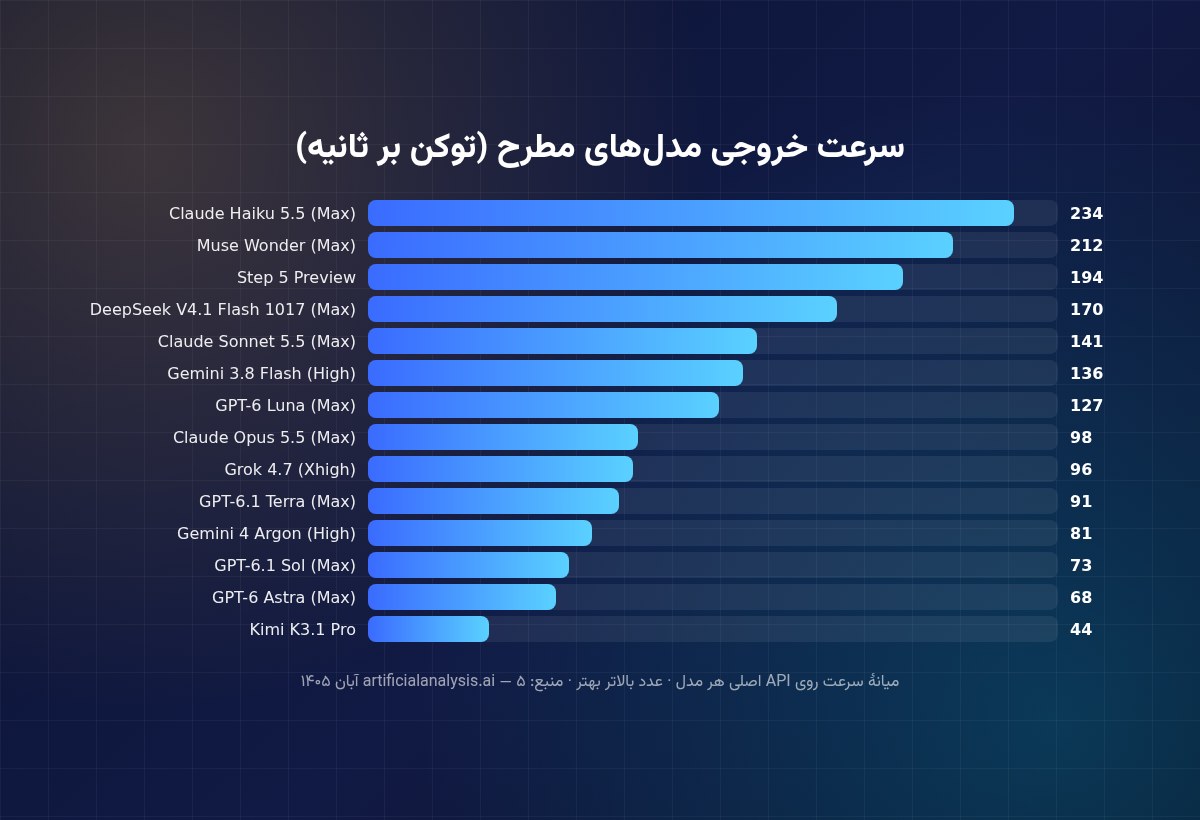
سرعت خروجی مدلهای مطرح روی API اصلی سازنده، به توکن بر ثانیه. منبع تصویر: تحریریه رادینو
اگر فقط به سرعت نگاه کنیم، مدلهایی مثل Celeris-1 با حدود ۱۵۲۱ توکن بر ثانیه در صدر هستند؛ اما شاخص هوش این مدل فقط ۶.۳ است. برای همین بهتر است سرعت را در کنار هوش ببینیم. در میان مدلهایی که شاخص هوش ۴۰ یا بیشتر دارند:
مدل
سرعت خروجی (توکن بر ثانیه)
Claude Haiku 5.5 (Max)
۲۳۴
Muse Wonder (Max)
۲۱۲
Step 5 Preview
۱۹۴
DeepSeek V4.1 Flash 1017 (Max)
۱۷۰
Claude Sonnet 5.5 (Max)
۱۴۱
Gemini 3.8 Flash (High)
۱۳۶
Claude Opus 5.5 (Max)
۹۸
Grok 4.7 (Xhigh)
۹۶
Gemini 4 Argon (High)
۸۱
GPT-6 Astra (Max)
۶۸
Kimi K3.1 Pro
۴۴
نکتهٔ جالب: مدلهای کوچکتر هر خانواده (Haiku، Flash، Luna) معمولاً چند برابر سریعتر از پرچمدارها هستند. اگر کارتان به بالاترین هوش نیاز ندارد، ارزانترین مدلهای هوش مصنوعی را ببینید؛ این مدلها اغلب سریعترینها هم هستند. برای دیدن رتبهٔ هوش همین مدلها، رتبهبندی مدلهای هوش مصنوعی را بخوانید.
کمترین زمان انتظار
برای کاربردهایی مثل چت و دستیار صوتی، زمان تا شروع جواب از سرعت خروجی مهمتر است. کمترین زمان تا اولین توکن پاسخ را مدلهایی دارند که بدون استدلال یا با تلاش کم اجرا میشوند؛ مثلاً GPT-6 Luna بدون استدلال حدود ۰.۹۱ ثانیه، Claude Sonnet 5.5 با تلاش Low حدود ۱.۱۵ ثانیه و GPT-6.1 Terra بدون استدلال حدود ۱.۲۷ ثانیه.
سطح تلاش استدلال؛ بزرگترین عامل تأخیر
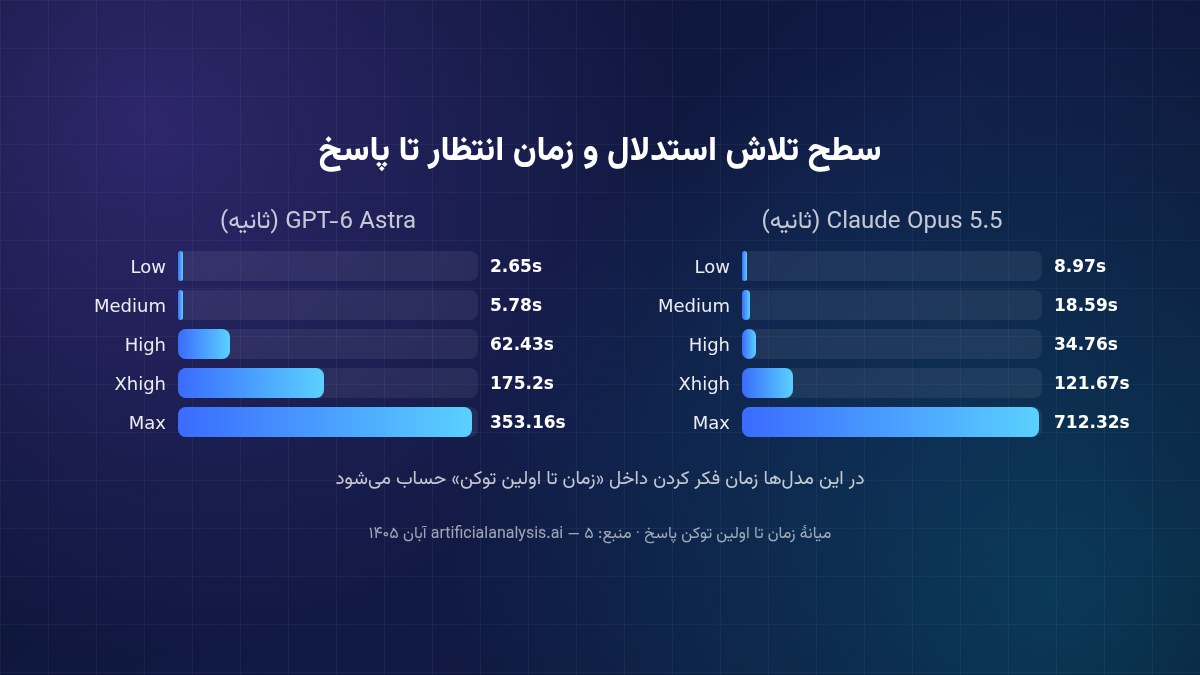
زمان تا اولین توکن پاسخ در Claude Opus 5.5 و GPT-6 Astra در سطوح مختلف تلاش. منبع تصویر: تحریریه رادینو
مدلهای استدلالی قبل از جواب «فکر» میکنند و هرچه سطح تلاش بالاتر باشد، این فکر کردن طولانیتر است. در Claude و GPT-6 فکر کردن به کاربر نشان داده نمیشود، پس زمان آن در همان زمان تا اولین توکن حساب میشود. اعداد زیر نشان میدهند این اثر چقدر بزرگ است. اگر با مفهوم سطح تلاش آشنا نیستید، راهنمای مدلهای استدلالی را بخوانید.
سطح تلاش
Claude Opus 5.5
GPT-6 Astra
Low
۹.۰ ثانیه
۲.۶۵ ثانیه
Medium
۱۸.۶ ثانیه
۵.۸ ثانیه
High
۳۴.۸ ثانیه
۶۲.۴ ثانیه
Xhigh
۱۲۱.۷ ثانیه
۱۷۵.۲ ثانیه
Max
۷۱۲ ثانیه (حدود ۱۲ دقیقه)
۳۵۳ ثانیه (حدود ۶ دقیقه)
به عبارت ساده: سطح Max برای سختترین مسائل است، نه برای چت روزمره. برای بیشتر کارها سطح Low یا Medium تعادل بهتری بین کیفیت و زمان انتظار دارد. در مدلهایی مثل DeepSeek V4.1 Flash 1017 (Max) که فکر کردن را نمایش میدهند، TTFT و TTFA از هم جدا میشوند؛ مثلاً TTFT حدود ۱.۱۳ ثانیه و TTFA حدود ۱۲.۹ ثانیه.
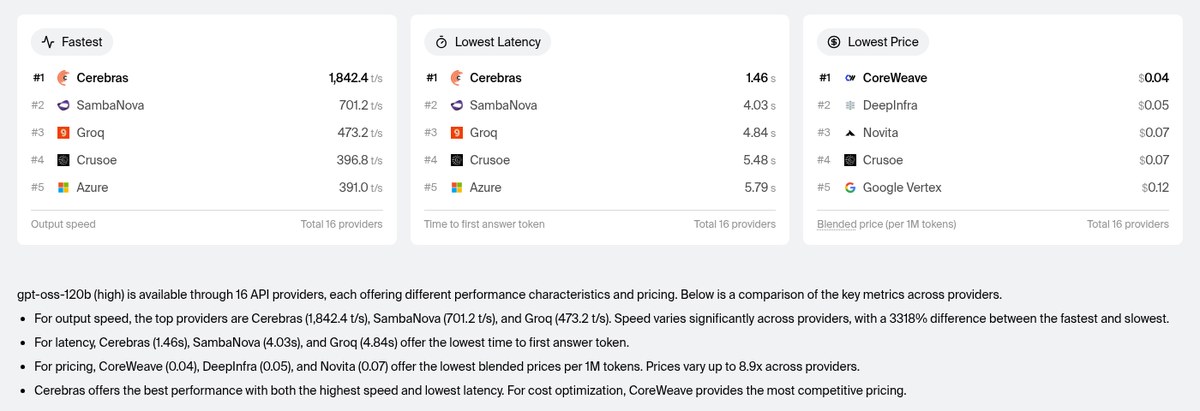
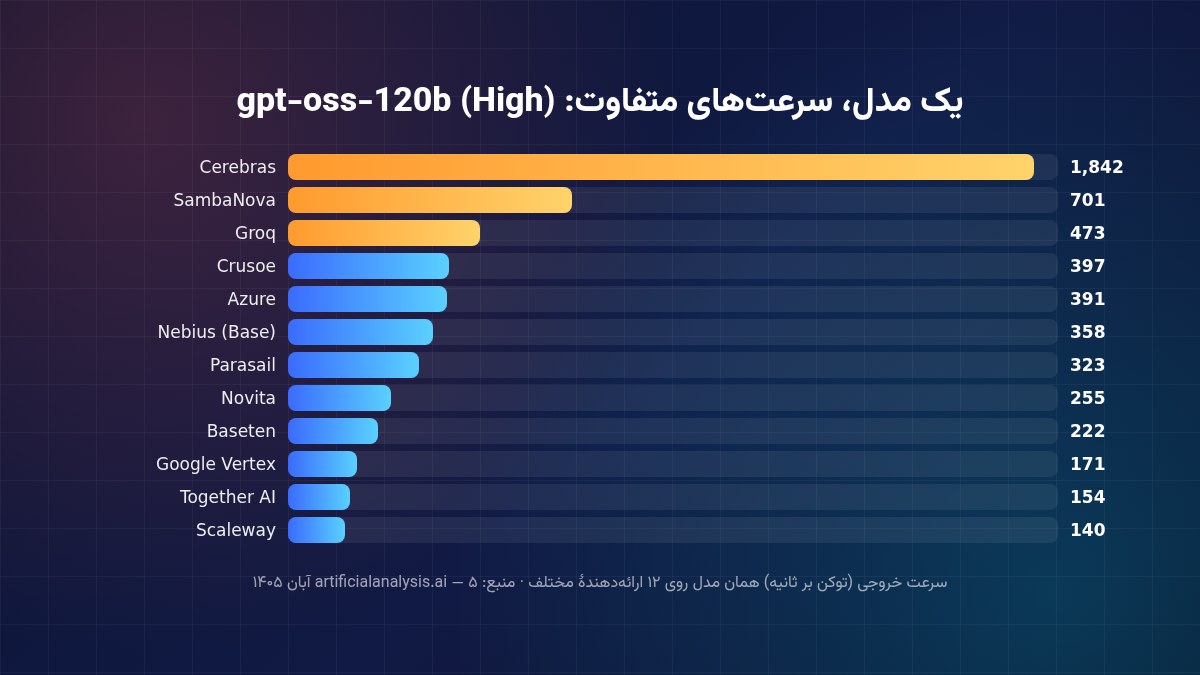
مدلهای وزن باز را شرکتهای مختلفی میزبانی میکنند و سرعت آنها بسته به سختافزار و بهینهسازی، بسیار متفاوت است. Artificial Analysis مدل gpt-oss-120b را روی ۱۶ ارائهدهنده سنجیده و اختلاف سریعترین و کندترین را ۳۳۱۸٪ گزارش کرده است.
سرعت خروجی gpt-oss-120b (High) روی ۱۲ ارائهدهنده. منبع تصویر: تحریریه رادینو
ارائهدهنده
سرعت خروجی (توکن بر ثانیه)
زمان تا اولین توکن پاسخ
Cerebras
۱۸۴۲
۱.۴۶ ثانیه
SambaNova
۷۰۱
۴.۰۳ ثانیه
Groq
۴۷۳
۴.۸۴ ثانیه
Azure
۳۹۱
—
Google Vertex
۱۷۱
—
Scaleway
۱۴۰
۱۵.۵۴ ثانیه
پس اگر از یک مدل وزن باز استفاده میکنید، انتخاب ارائهدهنده میتواند سرعت را بیش از ده برابر تغییر دهد. قیمت هم بین ارائهدهندهها فرق دارد؛ برای مقایسهٔ قیمتها راهنمای قیمت API هوش مصنوعی را ببینید. دربارهٔ استفاده از سرویسهای ابری هوش مصنوعی هم در مقالهٔ هوش مصنوعی ابری نوشتهایم.
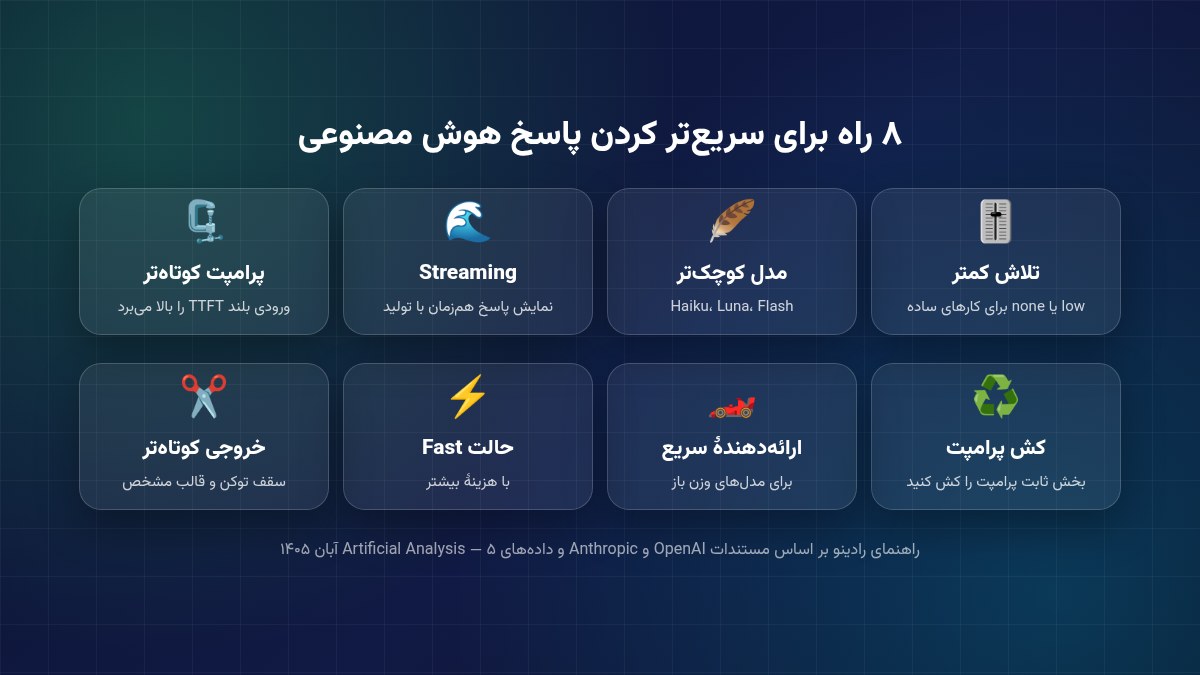
چطور پاسخ هوش مصنوعی را سریعتر کنیم؟
هشت راه عملی برای کاهش تأخیر در برنامههای مبتنی بر هوش مصنوعی. منبع تصویر: تحریریه رادینو
سطح تلاش را پایین بیاورید: برای کارهای ساده از low یا none (در مدلهایی که پشتیبانی میکنند، مثل GPT-6.1 Terra و GPT-6 Luna) استفاده کنید.
مدل کوچکتر انتخاب کنید: Haiku، Flash یا Luna برای بسیاری از کارها کافیاند.
Streaming را فعال کنید: پاسخ همزمان با تولید نمایش داده شود تا کاربر منتظر کل جواب نماند.
پرامپت را کوتاه کنید: ورودی طولانیتر یعنی زمان پردازش بیشتر قبل از اولین توکن.
از کش پرامپت استفاده کنید: بخش ثابت پرامپت (دستورالعملها، اسناد) را کش کنید؛ Anthropic گزارش کرده کش پرامپت میتواند تأخیر را بیش از ۲ برابر کم کند.
ارائهدهندهٔ سریع انتخاب کنید: برای مدلهای وزن باز، سرعت ارائهدهندهها را مقایسه کنید.
حالتهای سریع: OpenAI برای GPT-6 حالت Fast (با ۲ برابر قیمت) و برای برخی مدلها Ultrafast را ارائه میکند.
خروجی را محدود کنید: سقف توکن خروجی و قالب پاسخ مشخص، زمان کل را کم میکند.
در دادههای Artificial Analysis، در میان مدلهایی با شاخص هوش ۴۰ به بالا، Claude Haiku 5.5 (Max) با حدود ۲۳۴ توکن بر ثانیه سریعترین است. مدلهای بسیار سریعتری مثل Celeris-1 هم وجود دارند، اما هوش آنها بسیار پایینتر است.
TTFT چیست؟
TTFT یا Time to First Token زمانی است که از ارسال درخواست تا رسیدن اولین توکن پاسخ طول میکشد. در مدلهای استدلالی، Artificial Analysis اولین توکن فکر را ملاک قرار میدهد و زمان تا اولین توکن جواب را TTFA مینامد.
چرا مدلهای استدلالی کند هستند؟
چون قبل از جواب دادن فکر میکنند و توکنهای فکر تولید میکنند. مثلاً زمان تا اولین توکن پاسخ Claude Opus 5.5 در سطح Low حدود ۹ ثانیه و در سطح Max حدود ۷۱۲ ثانیه است.
آیا یک مدل روی ارائهدهندگان مختلف سرعت متفاوتی دارد؟
بله. برای مثال gpt-oss-120b روی Cerebras حدود ۱۸۴۲ توکن بر ثانیه و روی Scaleway حدود ۱۴۰ توکن بر ثانیه سرعت دارد.
توکن بر ثانیه یعنی چه؟
تعداد توکنهایی است که مدل بعد از شروع پاسخ در هر ثانیه تولید میکند. هر توکن تقریباً یک کلمه یا بخشی از کلمه است؛ عدد بالاتر یعنی پاسخ سریعتر روی صفحه ظاهر میشود.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.