«ارزانترین هوش مصنوعی کدام است؟» سؤال سادهای به نظر میرسد، اما جوابش به این بستگی دارد که «ارزان» را چطور تعریف کنید. مدلی که قیمت هر میلیون توکنش پایین است، ممکن است برای انجام یک کار آنقدر توکن مصرف کند که در نهایت از مدل گرانتر هزینهٔ بیشتری داشته باشد. در این مقاله ارزان ترین هوش مصنوعیها را با معیار درستتری مقایسه میکنیم: هزینهٔ هر تسک، در کنار شاخص هوش مستقل.
جدول کامل قیمت هر توکن همهٔ مدلها را قبلاً در راهنمای قیمت API هوش مصنوعی آوردهایم. اینجا زاویهٔ دیگری را بررسی میکنیم: کدام مدلها برای هر دلار بیشترین کیفیت را میدهند و چند غافلگیری در این جدول وجود دارد.
آخرین بهروزرسانی: ۳ آبان ۱۴۰۵ — شاخص هوش و هزینهٔ هر تسک از Artificial Analysis (Intelligence Index v4.3.2)، و قیمت توکنها از صفحههای رسمی OpenAI، Google، DeepSeek، Z.ai و Anthropic برداشته شدهاند (بررسی: ۳ آبان ۱۴۰۵).
⚡ پاسخ کوتاه
با معیار هزینهٔ هر تسک در Artificial Analysis، بهصرفهترین مدلهای باکیفیت در آبان ۱۴۰۵ اینها هستند: MiMo-V2.6-Pro شیائومی (امتیاز ۴۶.۳ با ۰.۱۳ دلار برای هر تسک)، GPT-6.1 Sol در سطح Medium (امتیاز ۴۷.۸ با ۰.۲۱ دلار)، DeepSeek V4.1 Flash (امتیاز ۴۵.۱ با ۰.۲۶ دلار) و Claude Haiku 5.5 (امتیاز ۴۳.۴ با ۰.۲۱ دلار در سطح Max). برای کارهای ساده و پرحجم، GPT-6 Luna و MiMo-V2.6-Flash با کمتر از ۰.۰۷ دلار برای هر تسک ارزانتریناند. در مقابل، Gemini 3.8 Flash با وجود قیمت توکن پایین، به دلیل مصرف زیاد توکن حدود ۰.۹۳ دلار برای هر تسک هزینه دارد.
قیمت API معمولاً به ازای هر میلیون توکن ورودی و خروجی اعلام میشود. اما هزینهٔ واقعی شما حاصلضرب قیمت در تعداد توکنی است که مدل برای انجام کار مصرف میکند. مدلهای استدلالی پیش از پاسخ هزاران توکن «فکر» تولید میکنند که با قیمت خروجی حساب میشود. دو مدل با قیمت یکسان ممکن است برای یک کار، یکی ۲ هزار و دیگری ۲۰ هزار توکن مصرف کنند.
Artificial Analysis برای حل این مشکل معیاری به نام Cost per Task منتشر میکند: میانگین هزینهٔ اجرای هر تسک از مجموعه آزمونهای شاخص هوش، با قیمت رسمی هر مدل. این عدد هم قیمت توکن و هم «پرحرفی» مدل را در نظر میگیرد. توضیح بیشتر این معیار را در راهنمای قیمت API و دربارهٔ اثر سطح استدلال بر آن را در مدلهای استدلالی چیست؟ آوردهایم.
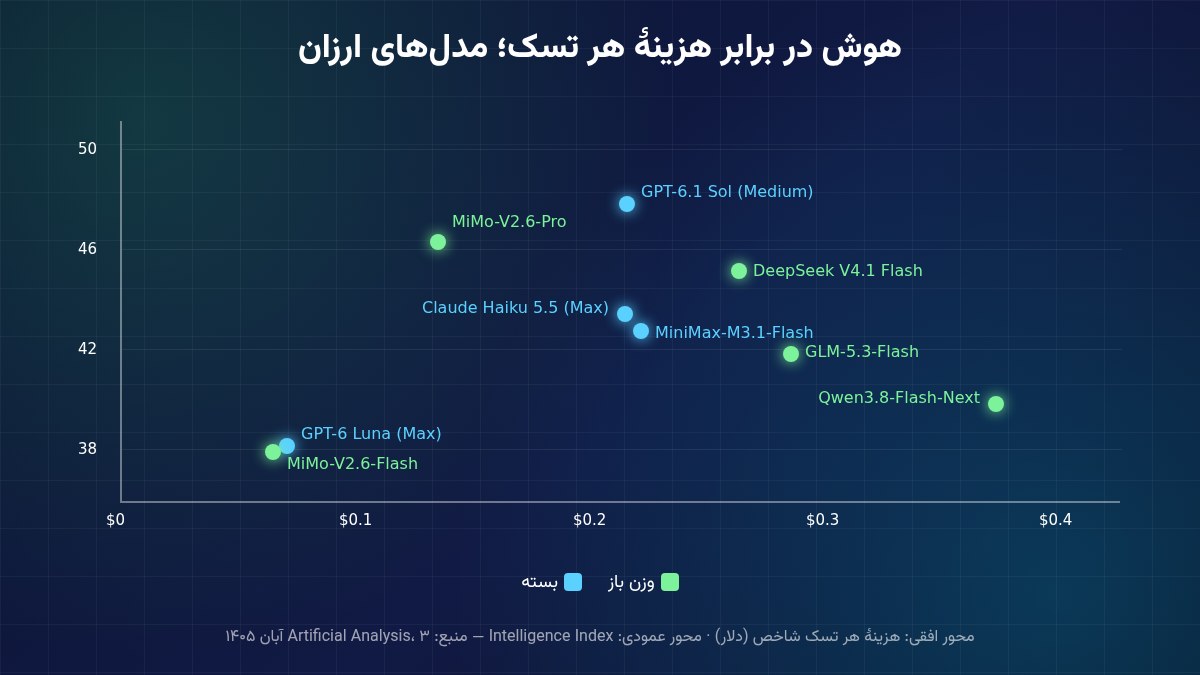
شاخص هوش در برابر هزینهٔ هر تسک؛ مدلهای بالا و سمت چپ نمودار بهصرفهتریناند. منبع تصویر: تحریریه رادینو
سه غافلگیری جدول
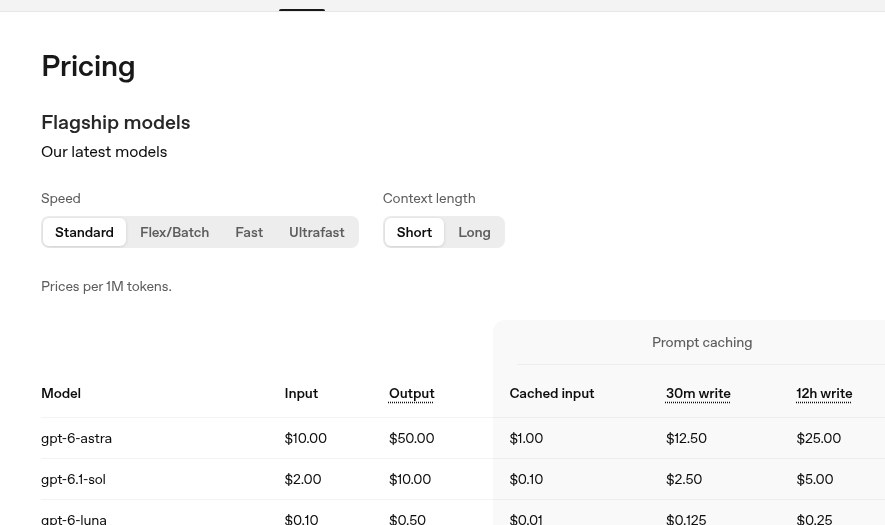
GPT-6.1 Sol در سطح Medium: قیمت هر توکن این مدل (۲ دلار ورودی و ۱۰ دلار خروجی) ۲۰ برابر GPT-6 Luna است، اما هزینهٔ هر تسکش فقط ۰.۲۱ دلار است. علتش مصرف بهینهٔ توکن است. با امتیاز ۴۷.۸، از همهٔ مدلهای وزنباز فعلی باهوشتر است.
Gemini 3.8 Flash گرانتر از ظاهرش: با ۰.۷۵ دلار ورودی و ۳.۷۵ دلار خروجی، روی کاغذ ارزان است. اما در سطح Medium برای هر تسک ۰.۹۳ دلار هزینه دارد، یعنی بیش از چهار برابر GPT-6.1 Sol Medium، با امتیاز پایینتر (۳۹.۸). البته سهمیهٔ رایگان آن برای نمونهسازی ارزشمند است.
Qwen3.8 Max: با قیمت ۲/۶ دلار، روی کاغذ از GPT-6.1 Sol ارزانتر است. اما با ۵.۴۱ دلار برای هر تسک، یکی از پرهزینهترین مدلهای جدول است.
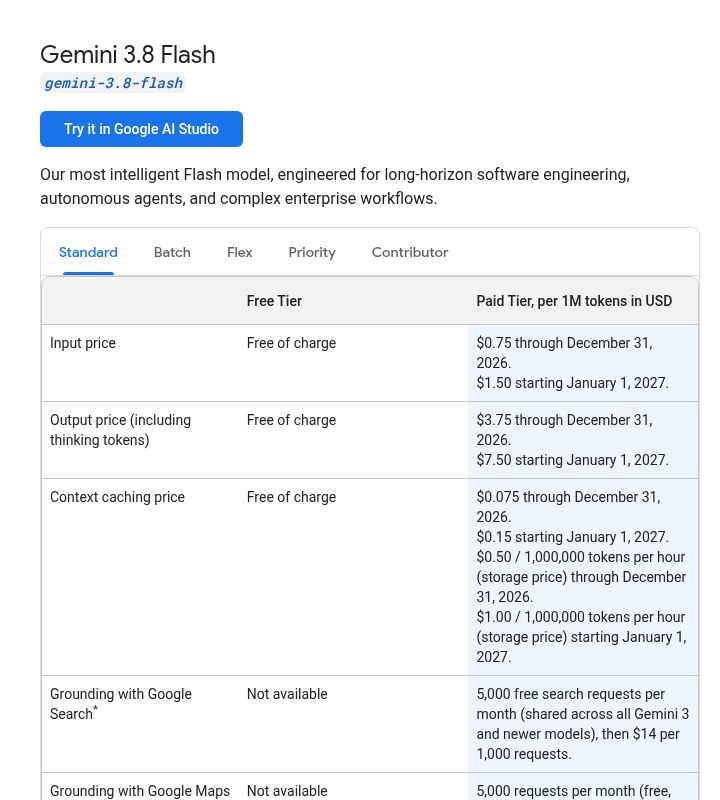
📅 تغییر قیمت پیش رو: طبق صفحهٔ قیمت گوگل، قیمت Gemini 3.8 Flash تا ۱۰ دی ۱۴۰۵ (۳۱ دسامبر ۲۰۲۶) ۰.۷۵ دلار ورودی و ۳.۷۵ دلار خروجی است. از ۱۱ دی ۱۴۰۵ (۱ ژانویهٔ ۲۰۲۷) به ۱.۵۰ و ۷.۵۰ دلار، یعنی دو برابر، میرسد.
جدول قیمت Gemini 3.8 Flash در صفحهٔ رسمی گوگل؛ سطح رایگان و قیمت پولی قبل و بعد از ۱ ژانویهٔ ۲۰۲۷. منبع تصویر: Google AI for Developers
۱۰ مدل ارزان و قوی
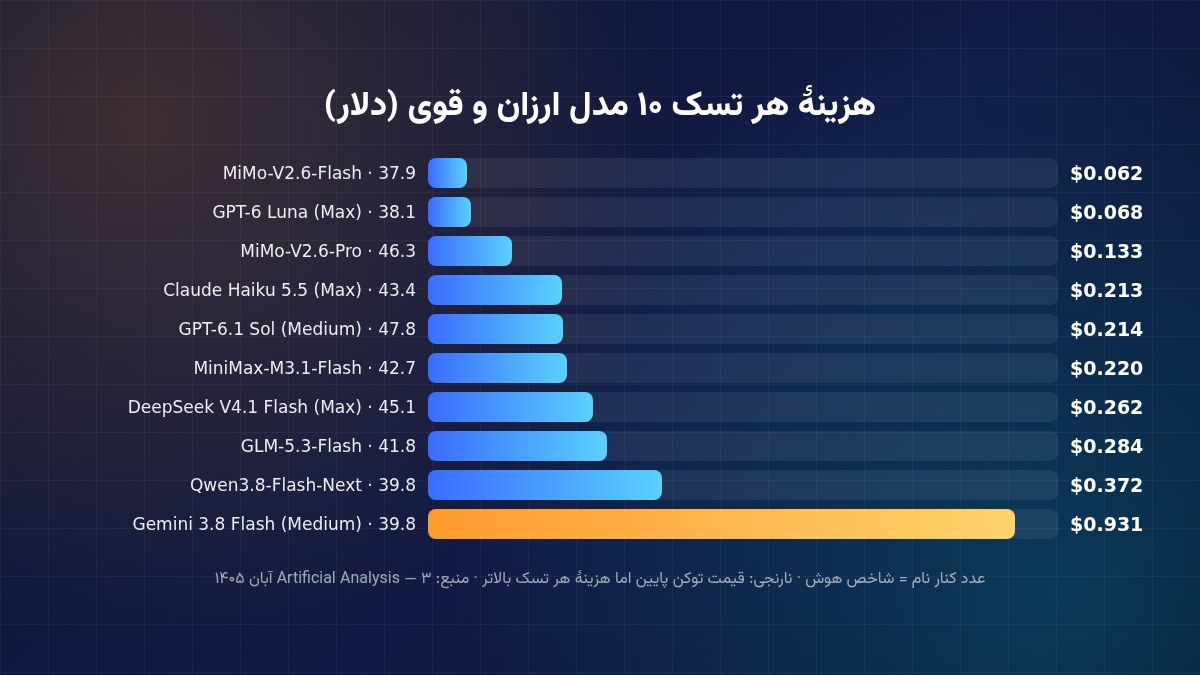
این فهرست ۱۰ مدل با کمترین هزینهٔ هر تسک را نشان میدهد که شاخص هوششان حدود ۳۸ یا بالاتر است. برای مقایسه، قویترین مدل فعلی، Claude Opus 5.5 (Max)، امتیاز ۵۷.۶ و هزینهٔ ۵.۹۸ دلار برای هر تسک دارد.
#
مدل
سازنده
شاخص هوش
هزینهٔ هر تسک
قیمت توکن (ورودی/خروجی)
وزن باز
۱
MiMo-V2.6-Flash
Xiaomi
۳۷.۹
۰.۰۶۲ دلار
۰.۱۴ / ۰.۲۸
✅ MIT
۲
GPT-6 Luna (Max)
OpenAI
۳۸.۱
۰.۰۶۸ دلار
۰.۱۰ / ۰.۵۰
❌
۳
MiMo-V2.6-Pro
Xiaomi
۴۶.۳
۰.۱۳۳ دلار
۰.۴۴ / ۰.۸۷
✅ MIT
۴
Claude Haiku 5.5 (Max)
Anthropic
۴۳.۴
۰.۲۱۳ دلار
۰.۱۰ / ۰.۵۰*
❌
۵
GPT-6.1 Sol (Medium)
OpenAI
۴۷.۸
۰.۲۱۴ دلار
۲ / ۱۰
❌
۶
MiniMax-M3.1-Flash
MiniMax
۴۲.۷
۰.۲۲ دلار
۰.۱۵ / ۰.۶۰
❌
۷
DeepSeek V4.1 Flash (Max)
DeepSeek
۴۵.۱
۰.۲۶۲ دلار
۰.۳۰ / ۱.۲۰
✅ MIT
۸
GLM-5.3-Flash
Z.ai
۴۱.۸
۰.۲۸۴ دلار
۰.۱۵ / ۰.۵۰
✅ MIT
۹
Qwen3.8-Flash-Next
Alibaba
۳۹.۸
۰.۳۷۲ دلار
۰.۱۵ / ۰.۴۷
✅
۱۰
Gemini 3.8 Flash (Medium)
Google
۳۹.۸
۰.۹۳۱ دلار
۰.۷۵ / ۳.۷۵
❌
قیمتها به دلار و برای هر میلیون توکن است. * قیمت Haiku 5.5 برای پرامپتهای تا ۱۰۰ هزار توکن است و بالاتر از آن پنج برابر میشود. قیمت DeepSeek مربوط به ساعت اوج است و در ساعتهای خلوت نصف میشود.
۱۰ مدل با کمترین هزینهٔ هر تسک و شاخص هوش آنها. Gemini 3.8 Flash نمونهٔ مدلی با قیمت توکن پایین اما هزینهٔ هر تسک بالاست. منبع تصویر: تحریریه رادینو
نکتههایی دربارهٔ چند مدل
MiMo-V2.6-Pro بهترین تعادل را دارد: باهوشترین مدل وزنباز جهان با هزینهای در حد مدلهای سبک. اگر فقط یک انتخاب دارید، از این شروع کنید.
GPT-6.1 Sol بسته به سطح استدلال، از ۰.۱۳ دلار (Low با امتیاز ۴۲.۱) تا ۰.۳۹ دلار (Xhigh با امتیاز ۵۱.۰) برای هر تسک هزینه دارد. یعنی با یک مدل، چند نقطهٔ قیمت در اختیار دارید.
Claude Haiku 5.5 هم بسیار انعطافپذیر است. هزینهٔ هر تسک آن در سطح Low فقط ۰.۰۲۴ دلار و در Medium ۰.۰۴۷ دلار است، برای چتباتها و کارهای پرحجم.
GPT-6 Luna در سطح Medium با ۰.۰۱۷ دلار برای هر تسک (امتیاز ۲۹.۹) ارزانترین گزینهٔ کارهای خیلی ساده است. قیمت ورودی کششدهٔ آن فقط ۰.۰۱ دلار است.
MiniMax-M3.1-Flash با حدود ۹۶ توکن در ثانیه سرعت خوبی دارد و برای کاربردهای تعاملی ارزان مناسب است.
مدلهای ارزان در برابر پرچمدارها
برای اینکه بفهمید با انتخاب مدل ارزان چه چیزی را از دست میدهید، این جدول را ببینید:
مدل
شاخص هوش
هزینهٔ هر تسک
نسبت هزینه به MiMo-V2.6-Pro
Claude Opus 5.5 (Max)
۵۷.۶
۵.۹۸ دلار
حدود ۴۵ برابر
Kimi K3.1 Pro
۵۵.۱
۲.۱۱ دلار
حدود ۱۶ برابر
GPT-6.1 Sol (Xhigh)
۵۱.۰
۰.۳۹ دلار
حدود ۳ برابر
Grok 4.7 (Xhigh)
۴۶.۴
۳.۷۴ دلار
حدود ۲۸ برابر
Qwen3.8 Max (0902)
۴۵.۴
۵.۴۱ دلار
حدود ۴۱ برابر
MiMo-V2.6-Pro
۴۶.۳
۰.۱۳ دلار
۱ (مبنا)
یعنی Grok 4.7 و Qwen3.8 Max تقریباً همامتیاز MiMo-V2.6-Pro هستند، اما ۲۸ تا ۴۱ برابر گرانترند. فاصلهٔ واقعی کیفیت فقط با Opus 5.5 و Kimi K3.1 Pro (حدود ۹ تا ۱۱ امتیاز) دیده میشود. این فاصله در کارهای پیچیدهٔ ایجنتی و استدلال چندمرحلهای محسوس است، اما در بیشتر کارهای روزمره نه.
جدول رسمی قیمت مدلهای GPT-6 در صفحهٔ OpenAI. منبع تصویر: OpenAI API Docs
مدلهای متنباز ارزان
شش مدل از ۱۰ مدل جدول بالا وزن باز دارند و همه چینیاند. این تصادفی نیست: آزمایشگاههای چینی با انتشار وزنها و قیمت پایین رقابت میکنند. تحلیل کامل این آزمایشگاهها را در مدلهای هوش مصنوعی چینی و فهرست کامل مدلهای باز را در بهترین مدلهای هوش مصنوعی متنباز ببینید.
آیا مدل متنباز همیشه ارزانتر است؟
نه لزوماً. «وزن باز» یعنی میتوانید مدل را دانلود و روی سرور خودتان اجرا کنید، اما اجرای مدلی با صدها میلیارد پارامتر به چندین GPU گرانقیمت نیاز دارد. برای حجم کم و متوسط، خرید API از سازنده یا ارائهدهندههای واسط تقریباً همیشه ارزانتر از راهاندازی سرور شخصی است. میزبانی شخصی فقط در این حالتها منطقی است:
حجم درخواستها آنقدر زیاد است که سختافزار اختصاصی بهصرفه میشود.
دادهها حساساند و نباید از زیرساخت شما خارج شوند.
میخواهید مدل را با دادههای خودتان تنظیم دقیق (Fine-tune) کنید.
مزیت دیگر مدلهای باز، رقابت ارائهدهندهها است. همان مدل را چند شرکت با قیمت و سرعت متفاوت عرضه میکنند و اگر یکی گران شد، میتوانید سراغ دیگری بروید. مجوز MIT در DeepSeek V4.1 Flash، MiMo-V2.6 و GLM-5.3-Flash هم استفادهٔ تجاری را بدون محدودیت خاص ممکن میکند.
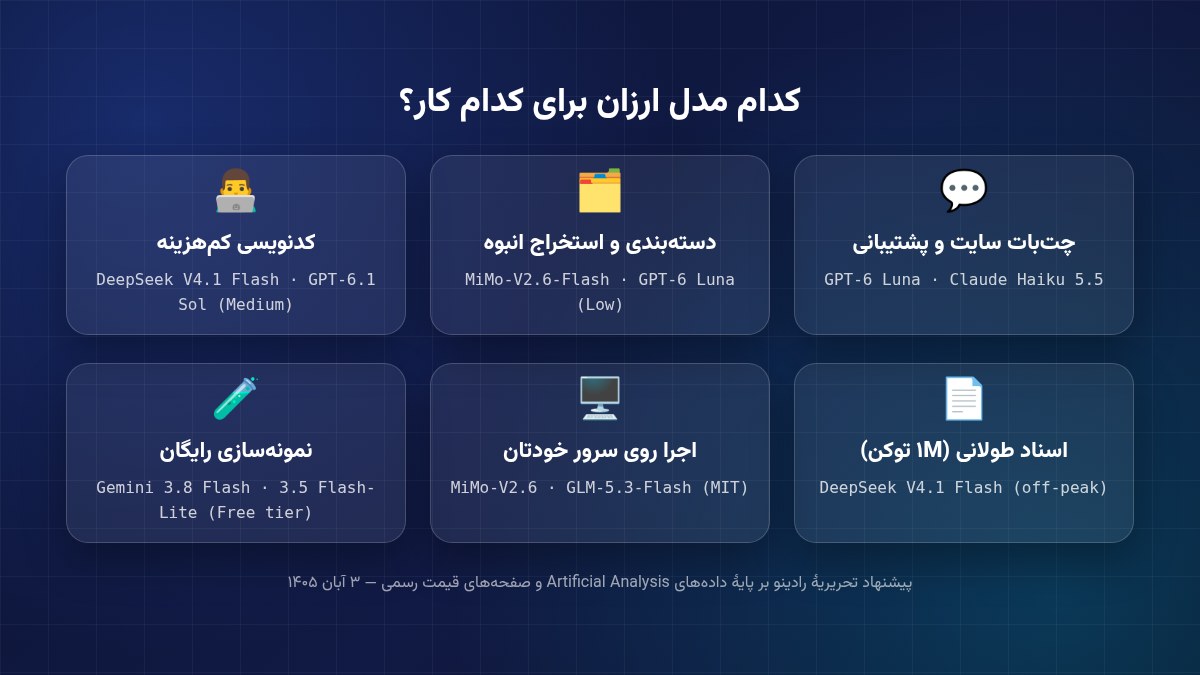
کاربردهای مناسب هر مدل ارزان
پیشنهاد مدل ارزان برای هر کاربرد. منبع تصویر: تحریریه رادینو
کش پرامپت: بخش ثابت پرامپت، مثل دستورالعمل سیستمی و اطلاعات محصول، با کش شدن تا ده برابر ارزانتر حساب میشود. در DeepSeek V4.1 Flash قیمت ورودی کششده در ساعت اوج فقط ۰.۰۰۶ دلار است.
ساعت خلوت و پردازش دستهای: DeepSeek در ساعتهای خلوت نصف قیمت میگیرد. OpenAI و Anthropic هم برای کارهایی که فوری نیستند، حالت Batch ارزانتر دارند.
سطح استدلال پایینتر: برای کارهای ساده، سطح low یا حتی خاموش کردن تفکر هزینه را چند برابر کم میکند، بدون اینکه کیفیت محسوس افت کند.
جزئیات بیشتر این ترفندها را در بخش «ترفندهای کاهش هزینه API» در راهنمای قیمت API آوردهایم.
مثال: هزینهٔ یک چتبات فروشگاهی
فرض کنید چتبات سایت شما روزانه ۱,۰۰۰ گفتوگو دارد و هر گفتوگو بهطور میانگین ۳,۰۰۰ توکن ورودی (دستورالعمل و اطلاعات محصول) و ۵۰۰ توکن خروجی مصرف میکند. با GPT-6 Luna، هزینهٔ روزانه تقریباً ۰.۳ دلار برای ورودی (۳ میلیون توکن × ۰.۱۰ دلار) و ۰.۲۵ دلار برای خروجی (۰.۵ میلیون توکن × ۰.۵۰ دلار) است، یعنی حدود ۱۷ دلار در ماه. اگر دستورالعمل ثابت کش شود، هزینهٔ ورودی تا ده برابر کمتر هم میشود. همین حجم با Claude Opus 5.5 (۴ دلار ورودی و ۲۰ دلار خروجی) حدود ۶۶۰ دلار در ماه هزینه دارد.
این محاسبه تقریبی است و توکنهای استدلال را در نظر نمیگیرد. متن فارسی هم معمولاً توکن بیشتری از متن انگلیسی هماندازه مصرف میکند.
اگر میخواهید چنین چتباتی را روی سایتتان راه بیندازید، تیم رادینو در خدمات طراحی و توسعهٔ وبسایت اتصال سایت به API هوش مصنوعی را هم انجام میدهد.
جمعبندی
ارزانترین هوش مصنوعی لزوماً مدلی نیست که کمترین قیمت توکن را دارد. معیار درست، هزینهٔ هر تسک در کنار کیفیت است. با این معیار، MiMo-V2.6-Pro، GPT-6.1 Sol در سطح Medium، DeepSeek V4.1 Flash و Claude Haiku 5.5 بهترین نسبت قیمت به عملکرد را دارند و GPT-6 Luna و MiMo-V2.6-Flash برای کارهای ساده و پرحجم بیرقیباند. مهمترین توصیه این است که برای هر بخش از محصولتان مدل مناسب همان بخش را انتخاب کنید: مدل ارزان برای کارهای روزمره و مدل قویتر فقط برای کارهای دشوار. رتبهٔ کلی همهٔ مدلها را در رتبهبندی مدلهای هوش مصنوعی ببینید.
سؤالات متداول
ارزانترین API هوش مصنوعی با کیفیت بالا کدام است؟
با معیار هزینهٔ هر تسک در Artificial Analysis، MiMo-V2.6-Pro شیائومی با امتیاز ۴۶.۳ و ۰.۱۳ دلار برای هر تسک بهترین نسبت کیفیت به قیمت را دارد. بعد از آن GPT-6.1 Sol در سطح Medium (۴۷.۸ امتیاز با ۰.۲۱ دلار) و DeepSeek V4.1 Flash (۴۵.۱ امتیاز با ۰.۲۶ دلار) قرار دارند.
هزینهٔ هر تسک با قیمت هر توکن چه فرقی دارد؟
قیمت توکن فقط نرخ است. هزینهٔ هر تسک، هزینهٔ واقعی انجام یک کار را نشان میدهد و به تعداد توکن مصرفی، از جمله توکنهای استدلال، بستگی دارد. برای مثال Gemini 3.8 Flash قیمت توکن پایینی دارد، اما هزینهٔ هر تسکش (۰.۹۳ دلار) بیش از چهار برابر GPT-6.1 Sol Medium است.
برای چتبات سایت کدام مدل ارزان مناسب است؟
GPT-6 Luna (۰.۱۰ دلار ورودی و ۰.۵۰ دلار خروجی) یا Claude Haiku 5.5 در سطح Low یا Medium. هر دو سریعاند و هزینهٔ هر گفتوگو کسری از یک سنت است. با کش کردن دستورالعمل ثابت، هزینه باز هم کمتر میشود.
آیا مدلهای متنباز ارزانترند؟
در API معمولاً بله. شش مدل از ۱۰ مدل بهصرفهٔ جدول، از جمله MiMo-V2.6 و DeepSeek V4.1 Flash، وزن باز دارند. اما اجرای آنها روی سرور شخصی به سختافزار گران نیاز دارد و فقط در حجم بسیار بالا یا برای دادههای حساس بهصرفه است.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.