اگر جدولهای رتبهبندی هوش مصنوعی را دیده باشید، احتمالاً به نامهایی مثل «Claude Opus 5.5 (Max)» یا «GPT-6.1 Sol (Medium)» برخوردهاید. این برچسبها نام نسخه نیستند. آنها «سطح استدلال» را نشان میدهند، یعنی اینکه مدل قبل از جواب دادن چقدر فکر کرده است. مدل استدلالی هوش مصنوعی (Reasoning Model) مدلی است که پیش از پاسخ نهایی، زنجیرهای از فکرهای درونی تولید میکند و شما میتوانید تعیین کنید این فکر کردن چقدر طول بکشد.
در این مقاله توضیح میدهیم استدلال در مدلهای زبانی یعنی چه، سطحهای Low تا Max در OpenAI، Anthropic و سازندههای دیگر چه فرقی دارند، و هر سطح چه اثری بر دقت، سرعت و هزینه میگذارد. همهٔ عددها از مستندات رسمی و اندازهگیریهای مستقل Artificial Analysis آمدهاند.
آخرین بهروزرسانی: ۳ آبان ۱۴۰۵ — توضیحات فنی از مستندات رسمی OpenAI و Anthropic، و عددهای امتیاز، هزینه و زمان از Artificial Analysis (Intelligence Index v4.3.2) برداشته شدهاند (بررسی: ۳ آبان ۱۴۰۵).
⚡ پاسخ کوتاه
مدل استدلالی پیش از پاسخ، «توکنهای استدلال» تولید میکند. این توکنها به کاربر نشان داده نمیشوند، اما جای پنجرهٔ زمینه را میگیرند و با قیمت توکن خروجی حساب میشوند. با پارامتری به نام effort (در OpenAI با reasoning.effort و در Claude با output_config.effort) تعیین میکنید مدل چقدر فکر کند: از low و medium تا high، xhigh و max. طبق دادههای Artificial Analysis، Claude Opus 5.5 از سطح Low به Max حدود ۱۵ امتیاز باهوشتر میشود (از ۴۲.۳ به ۵۷.۶)، اما هزینهٔ هر تسکش حدود ۱۱ برابر و زمان پاسخش بیش از ۴۰ برابر میشود. برای بیشتر کارها، سطح متوسط بهترین نقطهٔ تعادل است.
مدلهای زبانی معمولی پاسخ را کلمهبهکلمه و بلافاصله تولید میکنند. اگر از آنها یک مسئلهٔ ریاضی چندمرحلهای بپرسید، باید جواب را «یکنفس» بنویسند. مدل استدلالی اما اول برای خودش یادداشت برمیدارد: مسئله را میشکند، چند راهحل را امتحان میکند، اشتباههایش را پیدا میکند و بعد پاسخ نهایی را مینویسد.
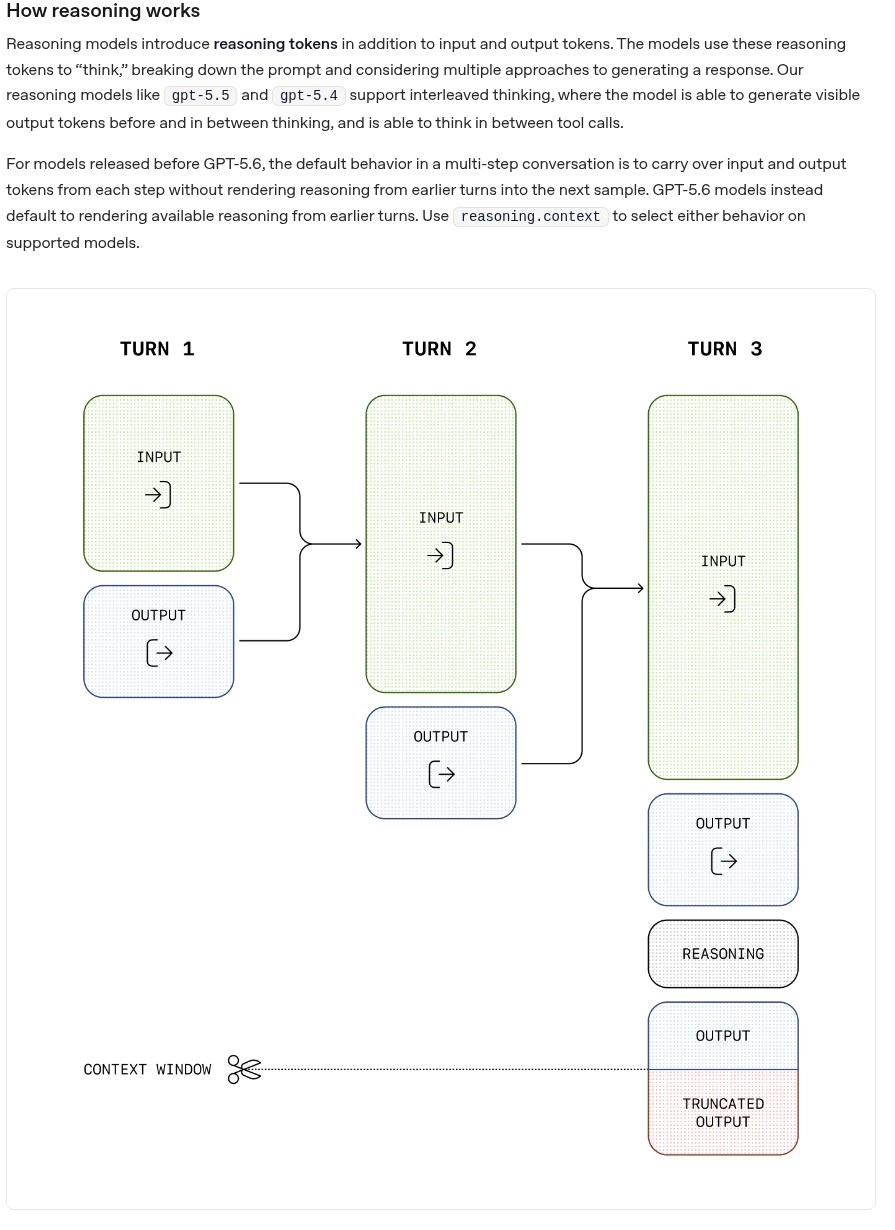
مستندات OpenAI این فرایند را چنین توضیح میدهد: مدلهای استدلالی علاوه بر توکنهای ورودی و خروجی، «توکنهای استدلال» دارند که با آنها «فکر میکنند»، پرامپت را تجزیه میکنند و رویکردهای مختلف را میسنجند. به گفتهٔ همین مستندات، این مدلها برای حل مسئلههای پیچیده، کدنویسی، استدلال علمی و جریانهای کاری ایجنتی چندمرحلهای بهترین عملکرد را دارند.
توکنهای استدلال در هر نوبت گفتوگو جای پنجرهٔ زمینه را میگیرند (نمودار مستندات OpenAI). منبع تصویر: OpenAI API Docs
توکنهای استدلال کجا میروند؟
دیده نمیشوند: OpenAI متن خام استدلال را برنمیگرداند و فقط در صورت درخواست، خلاصهای از آن (Reasoning Summary) میدهد. Claude هم بلوکهای تفکر را بهصورت خلاصه نشان میدهد.
شمرده میشوند: تعداد دقیق توکنهای استدلال در پاسخ API، در فیلد reasoning_tokens (OpenAI) یا thinking_tokens (Claude)، گزارش میشود.
پول دارند: هر سه سازندهٔ بزرگ صریحاً گفتهاند توکنهای تفکر با نرخ خروجی محاسبه میشوند. در صفحهٔ قیمت گوگل هم قیمت خروجی Gemini «شامل توکنهای تفکر» ذکر شده است.
جا میگیرند: OpenAI توصیه میکند وقتی تازه کار با این مدلها را شروع میکنید، دستکم ۲۵ هزار توکن برای استدلال و خروجی کنار بگذارید. اگر سقف max_output_tokens پر شود، ممکن است پاسخ با وضعیت incomplete برگردد، حتی پیش از آنکه یک کلمه پاسخ قابلمشاهده تولید شده باشد. در این حالت هزینهٔ استدلال را پرداختهاید و جوابی نگرفتهاید.
استدلال تطبیقی
مدلهای جدید فقط با یک دکمهٔ روشن و خاموش کار نمیکنند. هم OpenAI و هم Anthropic میگویند مدلهایشان بهصورت تطبیقی فکر میکنند: برای سؤال ساده توکن کمتری مصرف میکنند و برای مسئلهٔ سخت بیشتر. Claude در حالت «Adaptive Thinking» حتی ممکن است در سطحهای پایین، روی ورودیهای ساده اصلاً فکر نکند. روش قدیمی تعیین بودجهٔ ثابت تفکر (budget_tokens) در مدلهای Claude 4.7 به بعد پشتیبانی نمیشود و جایش را پارامتر effort گرفته است.
سطوح استدلال (Effort) در مدلهای مختلف
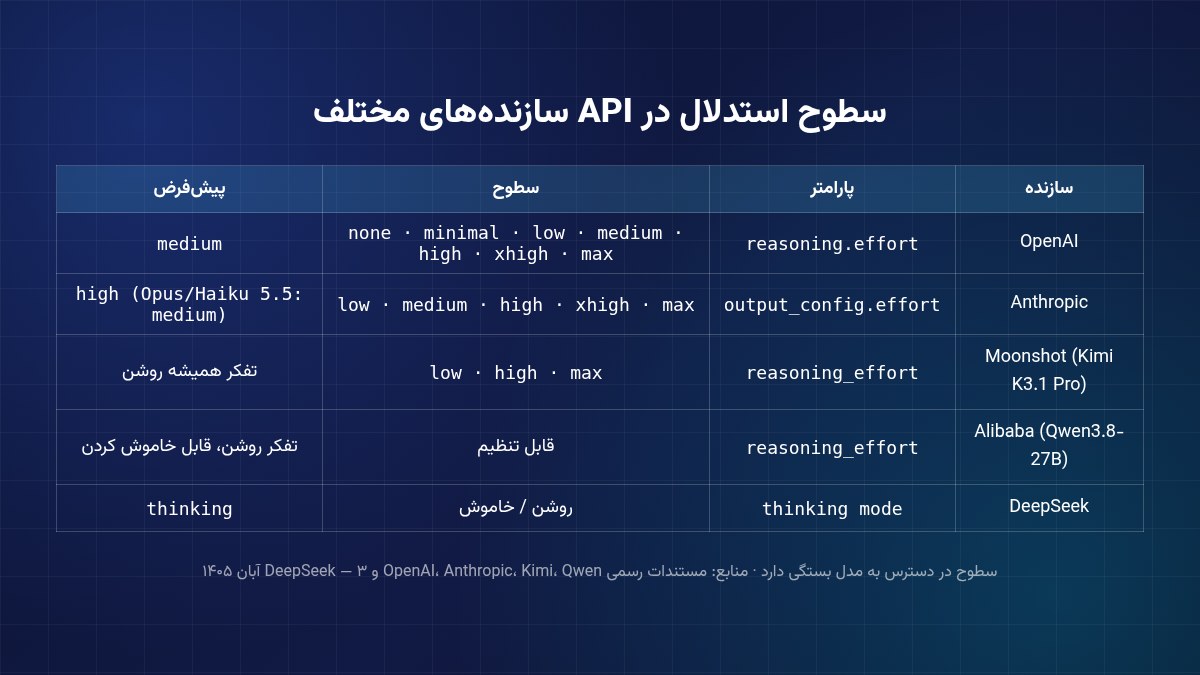
هر سازنده نام و تعداد سطحهای متفاوتی دارد، اما منطق همه یکی است: سطح پایینتر یعنی سرعت بیشتر و هزینهٔ کمتر، و سطح بالاتر یعنی فکر کاملتر و کیفیت بالاتر.
پارامتر و سطحهای استدلال در API سازندههای مختلف. منبع تصویر: تحریریه رادینو
سازنده
پارامتر
سطحها
پیشفرض
OpenAI
reasoning.effort
none، minimal، low، medium، high، xhigh، max (بسته به مدل)
medium برای GPT-6.1 Sol، GPT-6 Sol و GPT-6 Luna
Anthropic
output_config.effort
low، medium، high، xhigh، max
high؛ برای Opus 5.5 و Haiku 5.5: medium
Moonshot (Kimi K3.1 Pro)
reasoning_effort
low، high، max
تفکر همیشه روشن
DeepSeek
حالت thinking
روشن یا خاموش
حالت تفکر
OpenAI
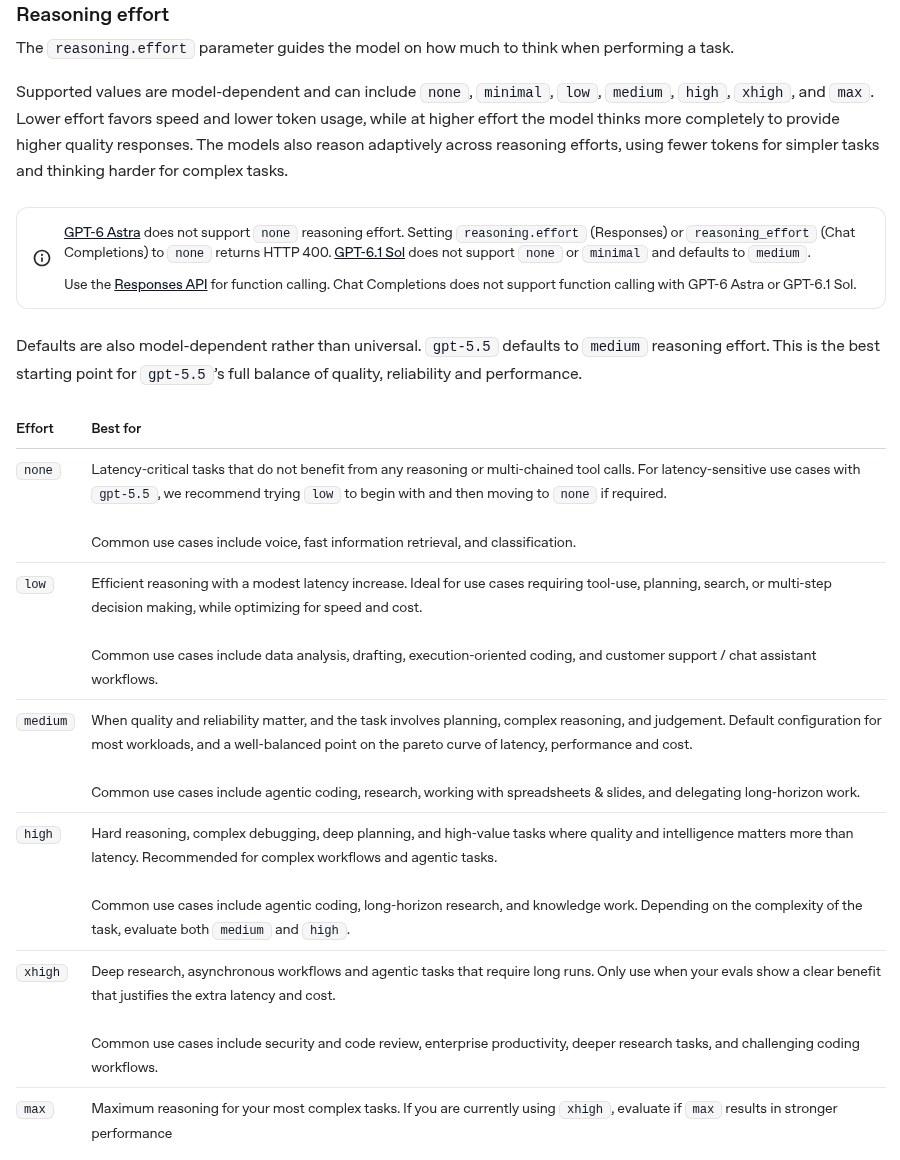
در API شرکت OpenAI مقدارهای ممکن «وابسته به مدل» است. مثلاً GPT-6 Astra مقدار none را نمیپذیرد و GPT-6.1 Sol هم none و minimal را پشتیبانی نمیکند. علاوه بر effort، مدلهای GPT-5.6 و GPT-6 یک «حالت» (reasoning.mode) هم دارند: standard یا pro. حالت pro برای کارهای دشوار کار بیشتری انجام میدهد و توکن بیشتری مصرف میکند. این دو تنظیم از هم مستقلاند.
جدول رسمی OpenAI: هر سطح effort برای چه کاری مناسب است. منبع تصویر: OpenAI API Docs
Anthropic (Claude)
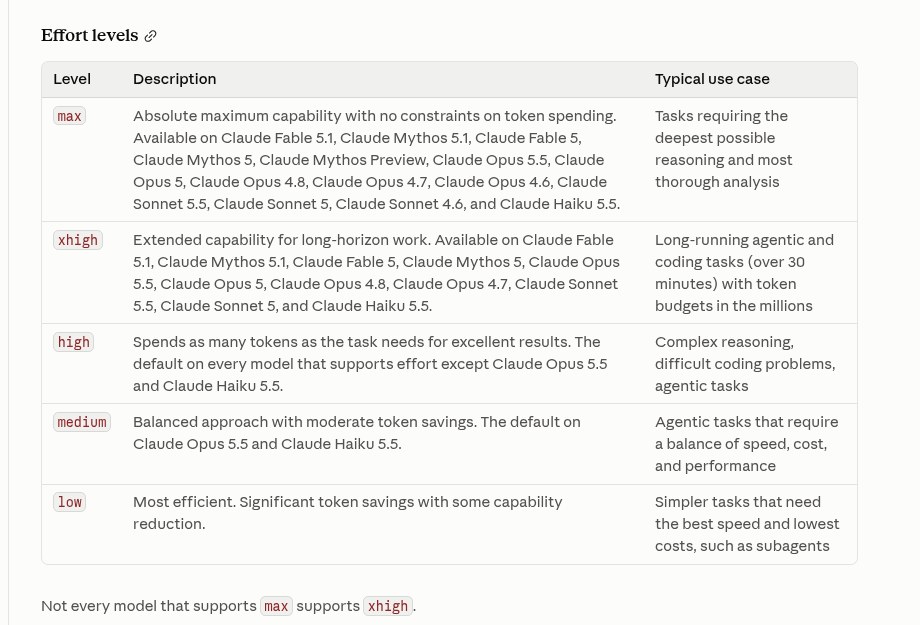
در Claude، پارامتر effort روی همهٔ توکنهای خروجی اثر میگذارد، نه فقط روی تفکر. یعنی طول توضیحها، تعداد فراخوانی ابزارها و جزئیات پاسخ هم با آن تغییر میکند. طبق مستندات Anthropic، سطح max روی مدلهایی مثل Claude Opus 5.5، Sonnet 5.5، Haiku 5.5 و Fable 5.1 در دسترس است. سطح xhigh برای «کارهای طولانی ایجنتی و کدنویسی بیش از ۳۰ دقیقه» توصیه شده است. در Opus 5.5 تفکر تطبیقی همیشه روشن است و نمیشود خاموشش کرد، پس effort عملاً تنها اهرم کنترل هزینه است.
جدول سطحهای effort در مستندات رسمی Claude. منبع تصویر: Claude Docs
مدلهای دیگر
Kimi K3.1 Pro سه سطح low، high و max دارد و تفکرش همیشه روشن است (جزئیات در بررسی Kimi K3.1 Pro). DeepSeek V4.1 Flash دو حالت تفکر و بدون تفکر دارد. در Artificial Analysis هم Gemini 3.8 Flash با دو نسخهٔ Medium و High اندازهگیری شده است. برای همین است که یک مدل ممکن است چند بار، با برچسبهای مختلف، در یک جدول بیاید.
اثر سطح استدلال بر دقت
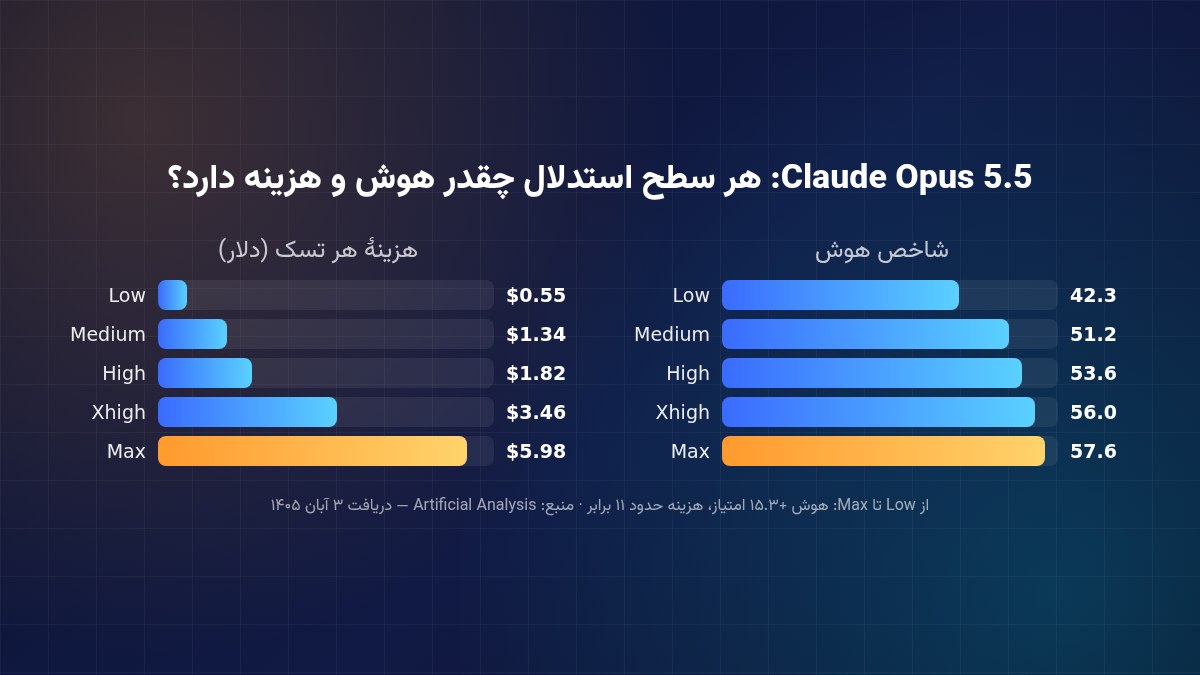
Artificial Analysis برای بسیاری از مدلها همهٔ سطحها را جداگانه اندازه میگیرد. دادههای Claude Opus 5.5 تصویر روشنی میدهد:
سطح Opus 5.5
شاخص هوش
هزینهٔ هر تسک
زمان پاسخ کامل (ثانیه)
Low
۴۲.۳
۰.۵۵ دلار
۱۲.۲
Medium (پیشفرض)
۵۱.۲
۱.۳۴ دلار
۱۶.۴
High
۵۳.۶
۱.۸۲ دلار
۲۷.۷
Xhigh
۵۶.۰
۳.۴۶ دلار
۱۰۳.۸
Max
۵۷.۶
۵.۹۸ دلار
۵۶۷.۷
شاخص هوش و هزینهٔ هر تسک Claude Opus 5.5 در پنج سطح effort (دادهٔ Artificial Analysis). منبع تصویر: تحریریه رادینو
سه نکته از این جدول:
بزرگترین جهش اول راه است: رفتن از Low به Medium حدود ۹ امتیاز اضافه میکند، اما از High به Max فقط ۴ امتیاز.
بازده نزولی: هر امتیاز اضافه در سطحهای بالا گرانتر تمام میشود. از Xhigh به Max، ۱.۶ امتیاز به قیمت ۲.۵ دلار بیشتر برای هر تسک به دست میآید.
سطح پایین مدل قوی در برابر سطح بالای مدل ضعیف: Opus 5.5 در سطح Low (۴۲.۳) تقریباً همامتیاز GPT-6.1 Sol در سطح Low (۴۲.۱) است، اما Sol در سطح Medium به ۴۷.۸ میرسد.
همین الگو در GPT-6.1 Sol هم دیده میشود: Low با ۴۲.۱، Medium با ۴۷.۸، High با ۵۰.۲، Xhigh با ۵۱.۰ و Max با ۵۱.۸. یعنی بیشترین سود در گام اول است. برای فهم اینکه این شاخص دقیقاً چه چیزی را میسنجد، راهنمای بنچمارکهای هوش مصنوعی و هوش هوش مصنوعی را بخوانید.
⚠️ استدلال بیشتر همیشه بهتر نیست. مستندات Claude دربارهٔ Opus 4.7 هشدار میدهد که سطح max «در بیشتر کارها هزینهٔ قابلتوجهی برای بهبود کیفیت نسبتاً کم اضافه میکند» و در کارهای با خروجی ساختاریافته یا کارهایی که به هوش زیادی نیاز ندارند، ممکن است به «فکر کردن بیش از حد» (overthinking) منجر شود. OpenAI هم توصیه میکند xhigh را فقط وقتی به کار ببرید که ارزیابیهایتان سود روشنی نشان دهد.
اثر استدلال بر هزینه و زمان
چون توکنهای تفکر با قیمت خروجی حساب میشوند و قیمت خروجی معمولاً چند برابر ورودی است (مثلاً ۵ برابر در GPT-6.1 Sol و Claude Opus 5.5)، سطح استدلال مستقیم روی صورتحساب اثر میگذارد. به همین دلیل قیمت هر میلیون توکن معیار کافی برای مقایسه نیست و باید به هزینهٔ هر تسک نگاه کرد. این مفهوم را در بخش «هزینه هر تسک» در راهنمای قیمت API هوش مصنوعی توضیح دادهایم.
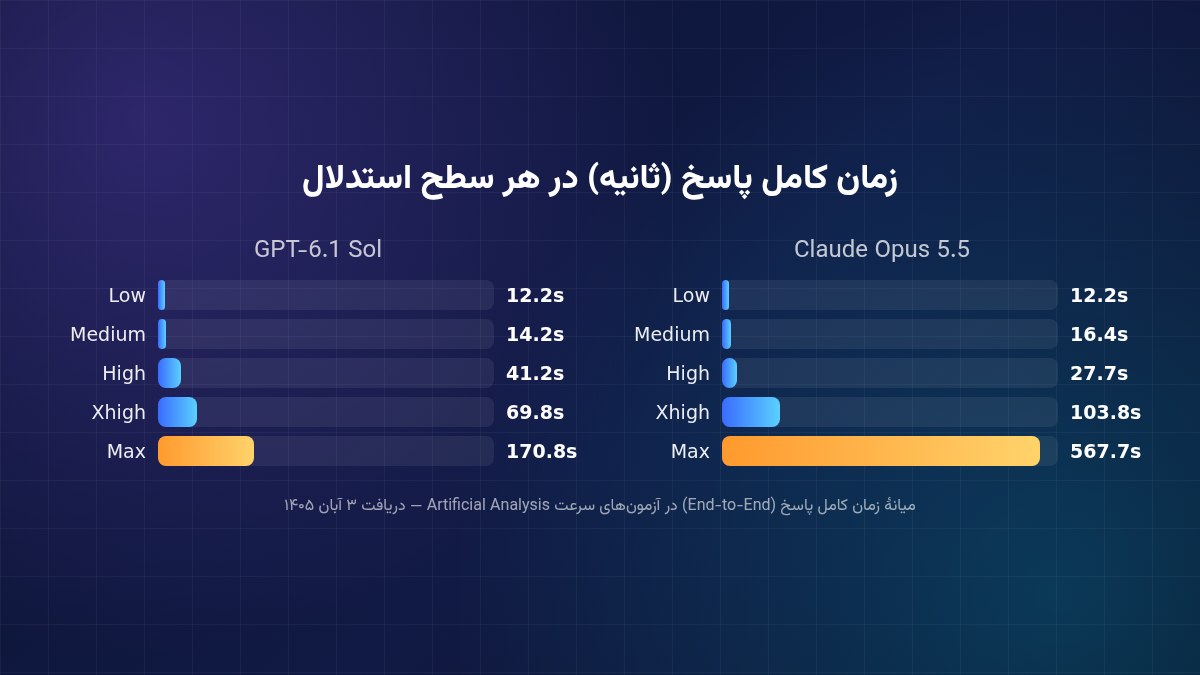
زمان پاسخ کامل (به ثانیه) در سطحهای مختلف استدلال؛ دادهٔ Artificial Analysis. منبع تصویر: تحریریه رادینو
زمان، شاید از هزینه هم مهمتر باشد. طبق اندازهگیری Artificial Analysis، پاسخ کامل Opus 5.5 در سطح Low حدود ۱۲ ثانیه طول میکشد، اما در سطح Max نزدیک ۹.۵ دقیقه (۵۶۷.۷ ثانیه). GPT-6.1 Sol در سطح Max حدود ۱۷۱ ثانیه زمان میبرد. برای یک چتبات پشتیبانی، چنین تأخیری قابلقبول نیست. اما برای یک تحلیل امنیتی که شب اجرا میشود، اهمیتی ندارد.
مدل و سطح
شاخص هوش
هزینهٔ هر تسک
Claude Haiku 5.5 (Low)
—
۰.۰۲۴ دلار
Claude Haiku 5.5 (Xhigh)
۴۱.۲
۰.۱۲۴ دلار
GPT-6.1 Sol (Low)
۴۲.۱
۰.۱۳۱ دلار
GPT-6.1 Sol (Medium)
۴۷.۸
۰.۲۱۴ دلار
GPT-6.1 Sol (Xhigh)
۵۱.۰
۰.۳۹۳ دلار
Claude Opus 5.5 (Medium)
۵۱.۲
۱.۳۴ دلار
Claude Opus 5.5 (Max)
۵۷.۶
۵.۹۸ دلار
این جدول نشان میدهد GPT-6.1 Sol در سطح Medium با ۰.۲۱ دلار برای هر تسک، تقریباً همان کیفیتی را میدهد که مدلهای چند برابر گرانتر. دربارهٔ این «غافلگیری» در ارزانترین مدلهای هوش مصنوعی با کیفیت بالا بیشتر نوشتهایم.
کدام سطح استدلال برای کدام کار؟
جمعبندی توصیههای رسمی OpenAI و Anthropic، بهعلاوهٔ دادههای بالا:
نوع کار
سطح پیشنهادی
دلیل
چتبات پشتیبانی، دستیار صوتی، طبقهبندی
none / low
تأخیر کم مهمتر از عمق فکر است
خلاصهسازی، پیشنویس، تحلیل داده ساده
low
استدلال مختصر کافی است و هزینه پایین میماند
کدنویسی ایجنتی، پژوهش، کار با اسناد
medium
نقطهٔ تعادل پیشفرض بیشتر سازندهها
دیباگ پیچیده، برنامهریزی عمیق، کار با ارزش بالا
high
وقتی کیفیت از سرعت مهمتر است
کارهای طولانی ایجنتی، بازبینی امنیتی، پژوهش عمیق
xhigh
فقط اگر ارزیابی سود روشن نشان دهد
دشوارترین مسئلهها (ریاضی و علمی مرزی)
max
فقط وقتی هزینه و زمان مهم نیست
چند توصیهٔ عملی
از پیشفرض شروع کنید و فقط اگر کیفیت کافی نبود، سطح را بالا ببرید. OpenAI میگوید effort را «پیچ تنظیم» ببینید، نه راه اصلی بهبود کیفیت. پرامپت خوب، معیار روشن «تمام شدن» و دستورالعمل دقیق اثر بیشتری دارند.
سطح را پویا تنظیم کنید: هر دو سازنده امکان تغییر سطح در میانهٔ گفتوگو را بدون از دست رفتن کش پرامپت فراهم کردهاند (configuration_update در OpenAI و effort در سطح پیام در Claude).
سقف خروجی را بزرگ بگیرید: در سطحهای high به بالا، max_tokens را بزرگ تنظیم کنید. Anthropic برای xhigh و max شروع از حدود ۶۴ هزار توکن را پیشنهاد میکند.
روی کار خودتان آزمایش کنید: تفاوت سطحها از کاری به کار دیگر فرق میکند. چند نمونهٔ واقعی را با دو یا سه سطح اجرا کنید و کیفیت، زمان و هزینه را مقایسه کنید.
اگر میخواهید بدانید کدام مدل در کدام سطح در جدول کلی قرار میگیرد، رتبهبندی مدلهای هوش مصنوعی را ببینید. برچسبهای High و Max در رتبهبندیهای مبتنی بر رأی کاربران هم دیده میشوند؛ توضیح آن را در LMArena و امتیاز Elo آوردهایم.
سؤالات متداول
فرق مدل استدلالی با مدل معمولی چیست؟
مدل معمولی پاسخ را بلافاصله تولید میکند. مدل استدلالی پیش از پاسخ، توکنهای استدلال درونی تولید میکند: مسئله را تجزیه میکند، راهحلها را میسنجد و خطاها را اصلاح میکند. نتیجه، دقت بیشتر در ریاضی، کدنویسی و کارهای چندمرحلهای است، به قیمت زمان و هزینهٔ بیشتر.
حالت thinking هزینه را چقدر بالا میبرد؟
بستگی به سطح دارد. توکنهای تفکر با قیمت خروجی حساب میشوند. طبق دادههای Artificial Analysis، هزینهٔ هر تسک Claude Opus 5.5 از ۰.۵۵ دلار در سطح Low به ۵.۹۸ دلار در سطح Max میرسد، یعنی حدود ۱۱ برابر. برای GPT-6.1 Sol این عدد از ۰.۱۳ دلار در Low به ۰.۳۹ دلار در Xhigh میرسد.
کی از سطح low و کی از max استفاده کنم؟
برای چت، طبقهبندی، خلاصهسازی و کارهای حساس به سرعت از low استفاده کنید. برای بیشتر کارهای جدی، مثل کدنویسی و تحلیل، medium یا high کافی است. max را فقط برای دشوارترین مسئلهها نگه دارید، جایی که چند دقیقه انتظار و هزینهٔ چندبرابری ارزشش را دارد.
آیا استدلال بیشتر همیشه یعنی پاسخ درستتر؟
نه. بیشترین بهبود در گامهای اول است و در سطحهای بالا بازده نزولی است. مستندات Claude هشدار میدهد سطح max در بعضی کارها، مثل خروجیهای ساختاریافته یا کارهای ساده، ممکن است به فکر کردن بیش از حد منجر شود. برای کارهای ساده، سطح بالا فقط زمان و هزینه را زیاد میکند.
جمعبندی
مدلهای استدلالی به ما یک اهرم تازه دادهاند: میتوانیم برای هر کار تعیین کنیم مدل چقدر فکر کند. سطحهای پایین سریع و ارزاناند، سطحهای بالا دقیقتر اما کند و گران. دادهها نشان میدهند بیشترین سود در رفتن از Low به Medium است و از آنجا به بعد هر امتیاز اضافه گرانتر میشود. پس قاعدهٔ طلایی این است: با سطح پیشفرض شروع کنید، روی نمونههای واقعی کار خودتان آزمایش کنید و فقط جایی سطح را بالا ببرید که ارزیابی شما سود روشنی نشان دهد.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.