list comprehension پایتون وقتی مفید است که بخواهید اعضای یک ورودی را به خروجی تازه تبدیل یا فیلتر کنید. این راهنما از نحو پایه تا دیکشنری، ست، مولد و خوانایی پیش میرود و یک آزمایش واقعی و محدود سرعت هم دارد؛ هدف کد روشنتر است، نه کوتاه کردن اجباری هر حلقه.
آخرین بهروزرسانی: ۱۷ آبان ۱۴۰۵ — منابع بررسیشده در این روز: مستندات رسمی پایتون، پیشنهادهای ۲۰۲ و ۲۷۴ و ۲۸۹ و راهنمای timeit.
⚡ پاسخ کوتاه
برای تبدیل و شرط ساده از لیست کامپریهنشن استفاده کنید؛ برای چند مرحله، مدیریت خطا و اثر جانبی، حلقه معمولی روشنتر است. کروشه لیست را همان ابتدا میسازد؛ پرانتز میتواند مولد یکبارمصرف بدهد. درباره سرعت فقط پس از آزمون همان ورودی و نسخه مفسر قضاوت کنید.
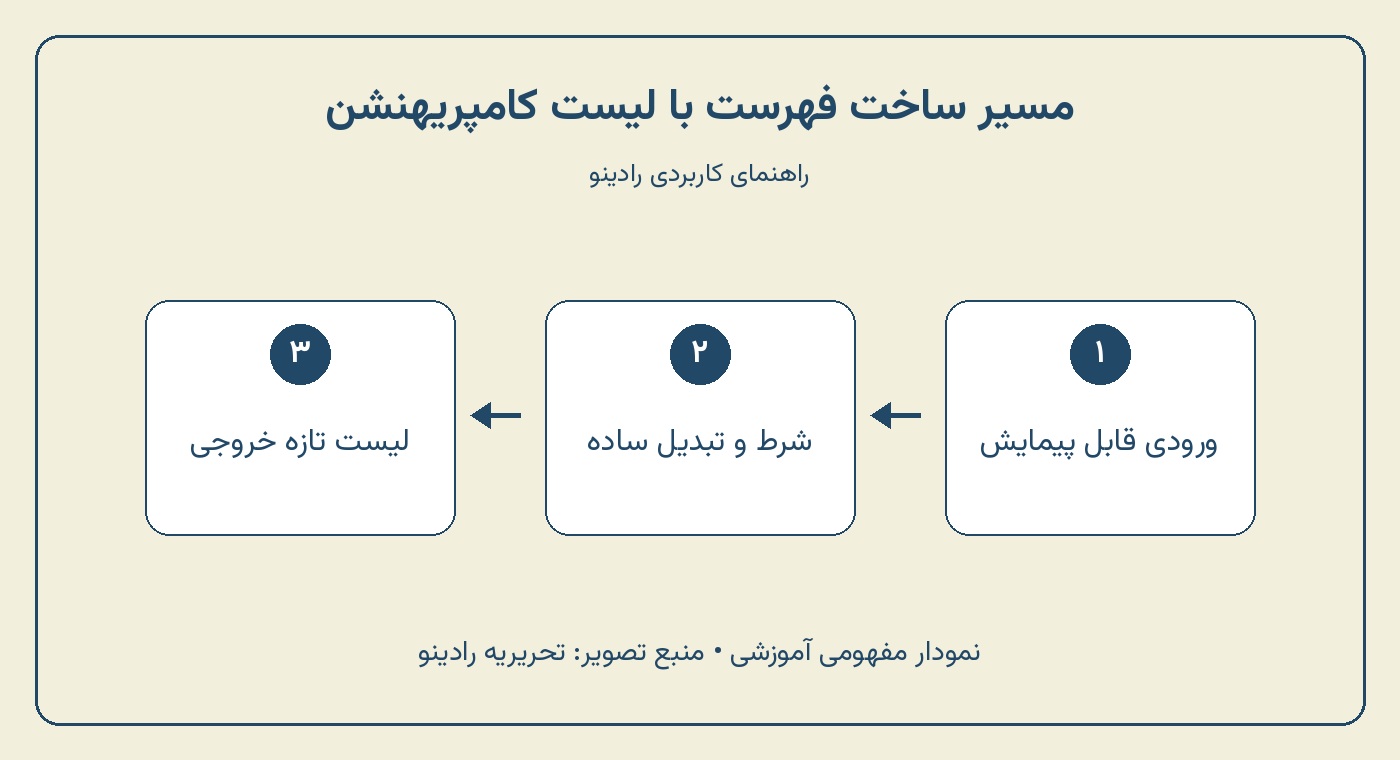
لیست کامپریهنشن راهی برای ساخت یک لیست تازه از یک پیمایش است: روی ورودی حرکت میکنید، برای هر عضو عبارتی محاسبه میکنید و نتیجه را در فهرست خروجی قرار میدهید. تفاوت اصلی با حلقه معمولی، بیان فشرده همین الگوی مشخص است؛ نه اینکه هر حلقهای را بتوان یا لازم باشد به یک خط تبدیل کرد. وقتی مسئله شما «تبدیل اعضا به یک مجموعه خروجی» است، این ساختار اغلب خوانا میشود.
شکل پایه را از چپ به راست به این صورت بخوانید: عبارت خروجی، سپس پیمایش ورودی. برای فهم جریان اجرا، ابتدا بخش پیمایش را در ذهن اجرا کنید و بعد ببینید عبارت اول برای عضو جاری چه میسازد. در نمونه زیر ورودی تغییر نمیکند و لیست تازهای از مربع اعداد ساخته میشود. مقادیر اعداد صرفاً داده آموزشیاند، نه نتیجه اندازهگیری عملکرد.
numbers = [1, 2, 3, 4]
squares = [number * number for number in numbers]
assert squares == [1, 4, 9, 16]
assert numbers == [1, 2, 3, 4]
اگر حلقه را بهتر میشناسید، ابتدا نسخه چندخطی را بنویسید و سپس آن را مقایسه کنید. حذف متغیر کمکی و فراخوانی افزودن، قصد شما را آشکارتر میکند؛ اما تنها وقتی محاسبه داخل عبارت ساده باشد. نامگذاری معنادار مثل number یا item از کوتاه کردن همه متغیرها به یک حرف مهمتر است، بهخصوص وقتی کد را همکار تازهای خواهد خواند.
squares = []
for number in numbers:
    squares.append(number * number)
خروجی یک لیست واقعی است، نه نمای زنده ورودی
ساختار داخل کروشه نتیجه را همان موقع میسازد. اگر بعداً به لیست ورودی عضو اضافه کنید، خروجی قبلی خودبهخود بهروز نمیشود. این ویژگی برای گرفتن یک نتیجه مستقل مفید است، اما به معنی کپی عمیق اشیای داخلی نیست. اگر عبارت خروجی خود همان شیء تغییرپذیر را برگرداند، ممکن است مرجع مشترک در هر دو لیست باقی بماند؛ کپی ظرف را با تکثیر همه اشیای داخل آن یکی نگیرید.
متغیر پیمایش در کامپریهنشن پایتون ۳ به حوزه بیرونی نشت نمیکند. بااینحال، نامهای بیرونی قابل خواندناند و اگر تابعی بسازید که بعداً آن نام را بخواند، بحث زمان ارزیابی جدا میشود. برای شروع لازم نیست این ظرافتها را در هر خط وارد کنید؛ کافی است از کامپریهنشن برای ساخت داده ساده استفاده کنید و رفتار غیرآشکار را به تابع نامدار منتقل کنید.
مسیر ساخت فهرست با لیست کامپریهنشن؛ نمودار آموزشی، نه نتیجه بنچمارک. منبع تصویر: تحریریه رادینو
شرط در comprehension؛ فیلتر یا انتخاب مقدار؟
دو کاربرد متفاوت شرط را جدا کنید. شرط انتهای عبارت تصمیم میگیرد عضو وارد خروجی بشود یا نه. شرط داخل عبارت خروجی تصمیم میگیرد چه مقداری برای همان عضو ساخته شود. جابهجا کردن این دو شکل، فقط سلیقه نگارشی نیست؛ میتواند تعداد اعضای خروجی و معنای داده را عوض کند. پیش از کدنویسی بپرسید «حذف میکنم یا جایگزین؟».
numbers = [-2, -1, 0, 1, 2]
positives = [n for n in numbers if n > 0]
labels = ["positive" if n > 0 else "other" for n in numbers]
assert positives == [1, 2]
assert len(labels) == len(numbers)
در فیلتر، عضوهایی که شرط را ندارند اصلاً وارد خروجی نمیشوند؛ در حالت انتخاب مقدار، برای هر عضو یک خروجی وجود دارد. اگر نیاز دارید چند وضعیت را تفکیک کنید، زنجیره بلند شرطهای تودرتو معمولاً سختخوان است. تابع کوچکی بنویسید که نامش قاعده را توضیح دهد و آن را در عبارت خروجی صدا بزنید؛ کوتاه بودن خط نباید علت تصمیم را پنهان کند.
چند شرط و محاسبه تکراری
برای دو شرط ساده میتوانید از ترکیب منطقی استفاده کنید. اگر ترتیب شرطها از خطا جلوگیری میکند، همان ترتیب بخشی از منطق برنامه است؛ مثلاً پیش از دسترسی به یک ویژگی، باید وجود مقدار مناسب روشن باشد. از کامپریهنشن برای پوشاندن اعتبارسنجی ناقص استفاده نکنید. ورودی نامطمئن بهتر است پیش از تبدیل، قرارداد و پیام خطای مشخص داشته باشد.
words = ["  apple ", " ", "banana"]
cleaned = [word.strip() for word in words if word.strip()]
assert cleaned == ["apple", "banana"]
در این مثال پاکسازی برای بعضی اعضا دوبار محاسبه میشود. برای رشته کوتاه ممکن است اهمیتی نداشته باشد، اما اگر بهجای آن یک درخواست شبکه یا پردازش سنگین باشد، مسئله جدی است. راهحل لزوماً فشردهتر کردن عبارت با ویژگیهای پیشرفته نیست؛ حلقه واضح با یک متغیر میانی میتواند بهترین انتخاب باشد. هزینه محاسبه را قبل از زیباسازی ظاهری تشخیص دهید.
Dict و Set Comprehension؛ ظرف خروجی را متناسب انتخاب کنید
در دیکشنری، برای هر عضو یک کلید و مقدار میسازید. اگر کلید تکرار شود، مقدار بعدی میتواند مقدار قبلی همان کلید را جایگزین کند؛ پس تعداد ورودیها الزاماً برابر تعداد کلیدهای نهایی نیست. این رفتار برای بعضی نگاشتها عمدی است، اما در داده مشتری یا کد محصول ممکن است خطای پنهان ایجاد کند. اول یکتا بودن کلید را بررسی کنید.
names = ["Ada", "Grace", "Linus"]
length_by_name = {name: len(name) for name in names}
unique_lengths = {len(name) for name in names}
assert length_by_name["Ada"] == 3
assert unique_lengths == {3, 5}
ست برای نگهداری مقدارهای یکتا مناسب است؛ ترتیب چاپ یا پیمایش آن را مبنای نمایش ثابت به کاربر نگذارید. اعضای ست و کلیدهای دیکشنری باید قابلیت هش شدن داشته باشند. اگر خروجی تابع شما لیست باشد، نمیتوانید آن را بیفکر در ست قرار دهید. نوع داده موردنیاز را از مسئله استخراج کنید، نه از اینکه کدام نشانه کوتاهتر نوشته میشود.
ساخت گزینهها از enum
برای یک مجموعه وضعیت مشخص، پیمایش اعضای شمارشی میتواند مبنای ساخت گزینههای نمایش باشد. کاربرد enum در پایتون جزئیات تعریف و پیمایش را توضیح میدهد. اینجا فقط الگوی تبدیل را ببینید: هر عضو یک داده ساختاریافته است و شما تصمیم میگیرید نام، مقدار یا ترکیبی از آنها در خروجی باشد. معنی دامنه را با تبدیل بیقاعده به رشته از دست ندهید.
from enum import Enum

class State(Enum):
    DRAFT = "draft"
    PUBLISHED = "published"

choices = [(state.value, state.name) for state in State]
assert choices[0] == ("draft", "DRAFT")
مقایسه کوتاه با map و حلقه for
اگر یک تابع آماده را روی ورودی اعمال میکنید، map میتواند بیان مناسبی باشد؛ اگر تبدیل و شرط ساده کنار هم دارید، کامپریهنشن معمولاً مستقیمتر خوانده میشود. برای آموزش کامل تابع، به راهنمای map در پایتون بروید. اینجا قصد نداریم جزئیات آن مقاله را تکرار کنیم؛ نکته مهم این است که در پایتون ۳، map خودش یک لیست از پیش ساختهشده نیست.
حلقه معمولی وقتی چند مرحله، ثبت خطا، شاخههای متفاوت یا توقف زودهنگام دارید انتخاب خوبی است. هیچ امتیازی برای تبدیل هر حلقه به یک عبارت تکخطی وجود ندارد. اگر لازم است برای فهم یک خط، چند بار ترتیب شرط و تبدیل را بازسازی کنید، خوانایی را از دست دادهاید؛ حتی اگر تعداد خطوط کمتر شده باشد. معیار بهتر، فهم قصد و امکان تغییر امن است.
Generator Expression؛ وقتی لیست کامل لازم ندارید
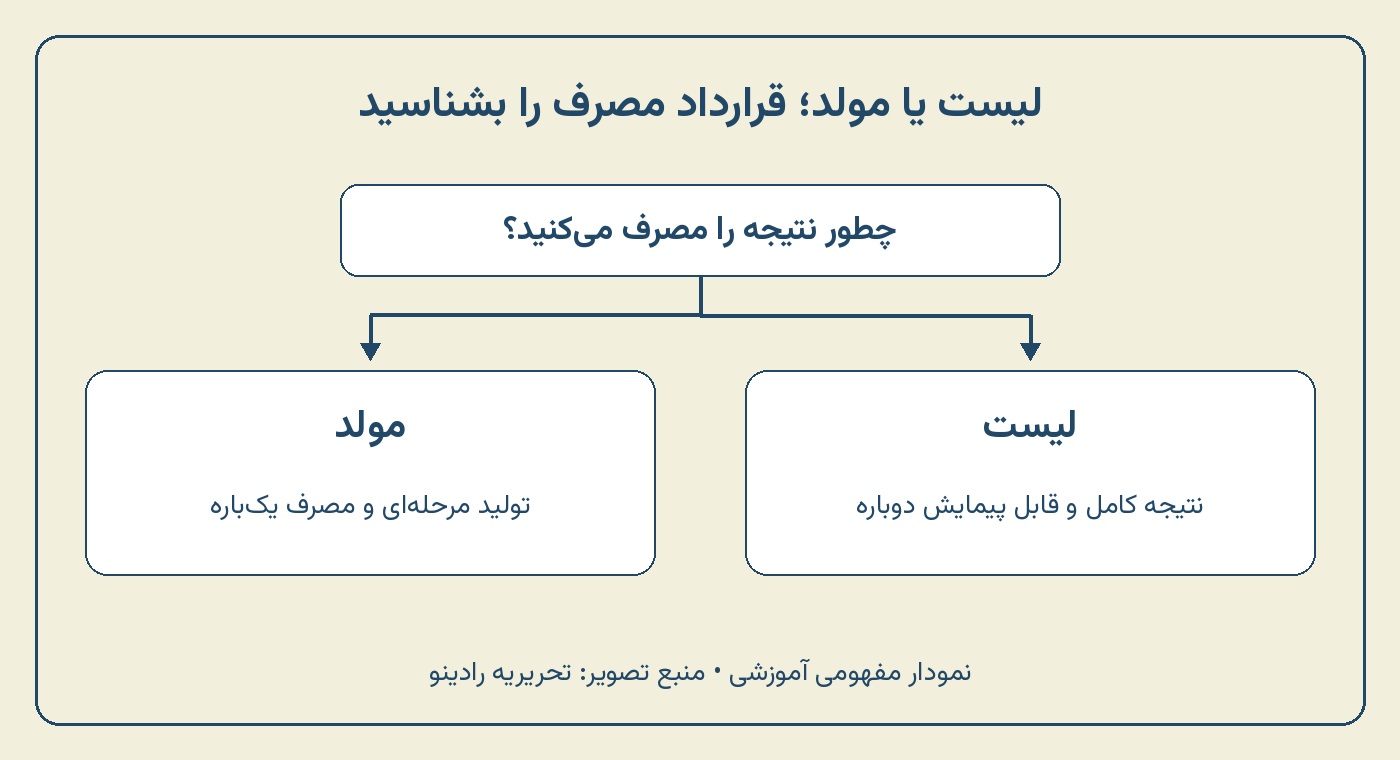
با پرانتز بهجای کروشه، عبارت مولد میسازید که مقدارها را هنگام مصرف تولید میکند. اگر تنها جمع یا بیشینه میخواهید، لازم نیست همه نتیجههای میانی را در لیستی جدا نگه دارید. این تفاوت میتواند فشار حافظه را کم کند، اما ادعای «بدون حافظه» درست نیست؛ خود مولد و منبع داده هم وضعیت و هزینه دارند. اگر منبع از قبل لیست عظیم باشد، آن لیست همچنان وجود دارد.
total = sum(n * n for n in range(1000))
stream = (n * n for n in range(3))
assert list(stream) == [0, 1, 4]
assert list(stream) == []
مولد مصرفشده را نباید مثل لیستی که بارها قابل پیمایش است در نظر بگیرید. همچنین خطای داخل محاسبه ممکن است هنگام مصرف رخ دهد، نه زمان تعریف عبارت. در طراحی خروجی تابع روشن کنید که مصرفکننده یک لیست دریافت میکند یا یک جریان یکبارمصرف؛ این قرارداد بر آزمون، مدیریت خطا و زمان دسترسی به منابع اثر دارد.
لیست یا مولد؛ قرارداد مصرف را بشناسید؛ نمودار آموزشی، نه نتیجه بنچمارک. منبع تصویر: تحریریه رادینو
کامپریهنشن تودرتو؛ ترتیب حلقهها مهم است
برای صاف کردن یک ماتریس کوچک، ترتیب بخشهای پیمایش همان ترتیب حلقههای عادی است: حلقه بیرونی اول و حلقه داخلی بعد. عبارت نتیجه در ابتدای نوشتار قرار میگیرد، اما این جایگاه ظاهری ترتیب پیمایش را عوض نمیکند. با یک داده کوچک و خروجی مشخص تمرین کنید؛ سپس اگر نیاز واقعی دارید آن را روی ساختار بزرگتر به کار ببرید.
matrix = [[1, 2], [3, 4]]
flat = [value for row in matrix for value in row]
assert flat == [1, 2, 3, 4]
grid = [[0 for _ in range(3)] for _ in range(2)]
grid[0][0] = 9
assert grid[1][0] == 0
در ساخت جدول تغییرپذیر، استقلال سطرها اهمیت دارد. تکرار یک مرجع مشترک با ضرب لیست با ساختن هر سطر تازه یکی نیست. نمونه بالا هر سطر را جدا میسازد تا تغییر یک سطر، سطر دیگر را عوض نکند. همین اصل را برای اشیای پیچیدهتر هم در نظر بگیرید؛ وجود کامپریهنشن بهتنهایی تضمین استقلال نیست و به عبارت خروجی بستگی دارد.
اگر سه سطح حلقه، چند شرط و فراخوانی پیچیده دارید، حلقه نامدار یا تابع کمکی غالباً بهتر است. کامپریهنشن برای خواننده باید الگو را آشکار کند؛ نباید به جدول رمز تبدیل شود. در بازبینی کد از همکار بپرسید خروجی و ترتیب پیمایش را بدون اجرا توضیح دهد. اگر پاسخ سخت شد، ساختار را ساده کنید؛ این آزمون فهم از سلیقه شخصی کاربردیتر است.
آزمایش واقعی سرعت با timeit
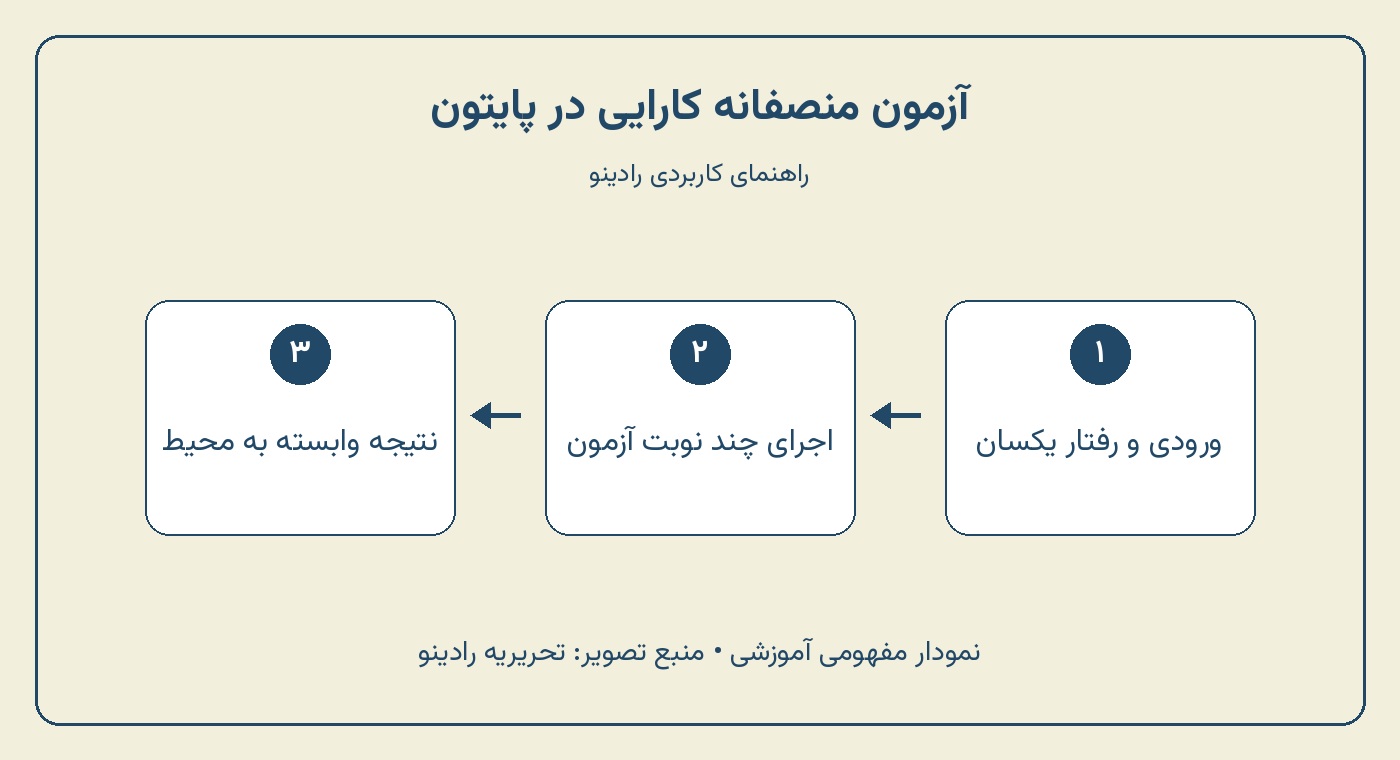
در ۱۷ آبان ۱۴۰۵ یک آزمون محلی روی سیپایتون ۳٫۱۳٫۵ در لینوکس انجام دادیم. ورودی، لیستی از دههزار عدد بود و هر دو روش مربع عددهای زوج را به لیست تازه تبدیل میکردند. برای هر روش پنج نوبت، هر نوبت هزار اجرا انجام شد؛ زمان ساخت ورودی در setup قرار گرفت. بنابراین نتیجه فقط مربوط به همین تبدیل و محیط است، نه رتبهبندی کلی زبان یا همه کامپریهنشنها.
کمترین زمان هر اجرا برای حلقه معمولی حدود ۲۸۲٫۹ میکروثانیه و برای کامپریهنشن حدود ۲۷۳٫۴ میکروثانیه بود. فاصله در این آزمون کوچک است و دامنه بعضی نوبتها همپوشانی داشت. از این دو عدد نتیجه نمیگیریم که کامپریهنشن همیشه سریعتر است؛ نوع تابع، نسخه مفسر، شکل داده و محیط اجرا میتوانند نتیجه را تغییر دهند. داده خام و روش آزمون برای تحریریه نگهداری شده است.
import platform
import timeit

setup = "data = list(range(10000))"
loop = """out = []
for x in data:
    if x % 2 == 0:
        out.append(x * x)
"""
comp = "out = [x*x for x in data if x % 2 == 0]"
print(platform.python_version())
for label, statement in [("for", loop), ("comprehension", comp)]:
    runs = timeit.repeat(statement, setup=setup, number=1000, repeat=5)
    print(label, min(runs) / 1000 * 1_000_000)
کامپریهنشن بهخودیخود کار را چندنخی یا موازی نمیکند. قفل مفسر سراسری پایتون موضوع جداگانهای است و نباید صرف کوتاه شدن کد را عبور از محدودیتهای همزمانی بدانید. اگر هزینه اصلی درخواست شبکه یا کوئری پایگاه داده است، تغییر شکل حلقه احتمالاً مهمترین بهینهسازی شما نیست. ابتدا گلوگاه واقعی را اندازه بگیرید.
آزمون منصفانه کارایی در پایتون؛ نمودار آموزشی، نه نتیجه بنچمارک. منبع تصویر: تحریریه رادینو
چه زمانی استفاده نکنیم؟
اگر هدف فقط انجام اثر جانبی مثل ارسال پیام، ذخیره سفارش یا چاپ است و لیست خروجی استفاده نمیشود، حلقه معمولی روشنتر است. ساخت یک لیست از نتیجه فراخوانیها صرفاً برای اجرای آنها، هزینه و ابهام اضافه میکند. در عملیات حساس، نیاز به توقف، گزارش خطا و تلاش مجدد دارید؛ پنهان کردن اینها در عبارت کوتاه، کنترل برنامه را سختتر میکند.
در پروژه جنگو، پیمایش نتیجه پایگاه داده را هم با ساخت کوئری اشتباه نگیرید. ممکن است یک خط کوتاه بهازای هر عضو، دسترسی تازهای به رابطه ایجاد کند و مشکل کارایی بسازد. پیش از تمرین روی داده واقعی، ساخت اپلیکیشن جنگو را مرور کنید و مرز دریافت داده و تبدیل در حافظه را بشناسید. کوتاه بودن کد، تعداد رفتوبرگشت پایگاه داده را نشان نمیدهد.
برای بازنویسی با دستیار هوش مصنوعی، از پرامپتهای کدنویسی الهام بگیرید ولی الزام کنید رفتار، ترتیب و مدیریت خطا حفظ شود. از ابزار فقط نسخه کوتاهتر نخواهید؛ نسخه خواناتر و آزمون مقایسهای بخواهید. برای زمینه تاریخی این قابلیت نیز تاریخچه پایتون و پیشنهاد رسمی معرفی لیست کامپریهنشن را بخوانید. هدف شناخت ابزار است، نه مسابقه کمترین نویسه.
جمعبندی و تمرین عملی
یک لیست کوچک از داده خام بردارید، خروجی مورد انتظار را بنویسید و ابتدا حلقه ساده بسازید. سپس فقط بخش تبدیل و فیلتر را به کامپریهنشن تبدیل کنید. حالت ورودی خالی، مقدار نامعتبر، عضو تکراری و ترتیب خروجی را آزمایش کنید. برای داده بزرگ هم بپرسید آیا واقعاً لیست لازم دارید یا مصرف مرحلهای کافی است؛ پاسخ این سؤال از انتخاب کروشه و پرانتز شروع میشود.
در پروژه تیمی، قرارداد خوانایی را مستند کنید: عبارت ساده، نام روشن، اثر جانبی نداشتن و محدود بودن تودرتویی. اگر به ساخت یا بازطراحی یک محصول پایتونی نیاز دارید، خدمات طراحی و توسعه وبسایت رادینو را بررسی کنید. تصمیم فنی خوب از نیاز و آزمون میآید؛ نه از تبدیل اجباری همه حلقهها به یک شکل محبوب.
سؤالات متداول
آیا List Comprehension سریعتر از حلقه for است؟
همیشه نه. آزمون این مقاله فقط یک تبدیل مشخص را روی نسخه مشخص مفسر اندازه گرفته است. نتیجه را به تابع سنگین یا ورودی متفاوت تعمیم ندهید؛ خوانایی، هزینه محاسبه و اندازه داده را با هم بسنجید.
فرق آن با map و filter چیست؟
کامپریهنشن میتواند تبدیل و شرط را در یک بیان جمع کند و لیست بسازد. توابع map و filter در پایتون ۳ خروجی پیمایشی دارند. برای جزئیات، مقاله اختصاصی map را بخوانید و رفتار مصرف را در قرارداد تابع روشن کنید.
شرط if و else را کجا بنویسیم؟
برای انتخاب مقدار، شرط و شاخه جایگزین داخل عبارت خروجی میآید؛ برای حذف عضو، شرط پس از پیمایش میآید. اولی معمولاً تعداد اعضا را حفظ میکند و دومی ممکن است خروجی کوتاهتری بسازد.
Generator Expression چه تفاوتی دارد؟
مولد مقدارها را هنگام مصرف میسازد و پس از مصرف تمام میشود؛ لیست از ابتدا ساخته شده و دوباره قابل پیمایش است. مولد برای جمعزدن یا پردازش جریانی مفید است، اما معنای خطا و عمر منابع را تغییر میدهد.
تودرتویی کی خوانایی را خراب میکند؟
وقتی ترتیب حلقه و شرط بدون مکث قابل توضیح نیست یا خطاها باید جدا مدیریت شوند. در آن وضعیت، تابع کمکی و حلقه چندخطی بهترند؛ هیچ الزام فنی برای تکخطی نوشتن وجود ندارد.
چطور خطاهای ورودی را بدون پیچیده کردن comprehension مدیریت کنیم؟
اگر داده ممکن است خراب باشد و برای هر ردیف باید گزارش خطا، تلاش دوباره یا تصمیم مستقل بگیرید، حلقه معمولی انتخاب روشنتری است. تلاش برای پنهان کردن همه استثناها در یک عبارت، عیبیابی را دشوار میکند. میتوانید ابتدا مرحله اعتبارسنجی بنویسید، داده پذیرفتهشده را جدا کنید و بعد تبدیل ساده را با comprehension انجام دهید. این تفکیک هم پیام خطا را قابل فهم نگه میدارد و هم قرارداد ورودی مرحله بعد را روشن میکند.
آیا ساختن فهرست تازه یعنی داده داخل آن مستقل شده است؟
نه همیشه. ظرف خروجی تازه است، اما اگر اعضا خودشان اشیای قابل تغییر باشند و همان مرجع را عبور دهید، ممکن است میان ورودی و خروجی مشترک بمانند. اگر استقلال لازم دارید، قرارداد کپی را دقیق تعیین کنید؛ کپی سطحی و عمیق یک معنا ندارند. برای نمونه جدولی، آزمایشی بنویسید که تغییر یک سلول آیا روی ردیف دیگر اثر میگذارد یا نه. ظاهر کوتاه یک عبارت، ضمانت استقلال حافظه نیست.
برای بازبینی کد تیمی چه معیاری پیشنهاد میشود؟
از بازبین بخواهید بدون اجرای کد، نوع خروجی، شرط پذیرش و ترتیب پیمایش را توضیح دهد. اگر توضیحش با نویسنده فرق دارد، نامگذاری یا ساختار نیاز به اصلاح دارد. یک ورودی خالی، یک عضو مرزی و یک داده تکراری را هم آزمایش کنید. قواعد تیم بهتر است بر خوانایی قابل سنجش تکیه کنند؛ ممنوع کردن همه comprehensionها یا تبدیل همه حلقهها به آنها، هر دو تصمیمی افراطی و کمفایدهاند.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.