هر هفته یک مدل جدید میآید و ادعا میکند «باهوشترین» است. اما این ادعا را با چه چیزی میسنجند؟ جواب کوتاه: بنچمارک هوش مصنوعی. بنچمارکها همان آزمونهای استانداردی هستند که مدلها را روی سؤالها و کارهای یکسان امتحان میکنند تا بشود آنها را منصفانه کنار هم گذاشت. در این راهنما با هم یاد میگیریم بنچمارکها دقیقاً چه چیزی را میسنجند، لیدربوردهای معتبر کداماند، یک جدول رتبهبندی را چطور بخوانیم و از همه مهمتر، چطور با این اطلاعات مدل مناسب کار خودمان را انتخاب کنیم.
آخرین بهروزرسانی: ۲۷ مهر ۱۴۰۵ — اعداد این مقاله از لیدربوردهای Artificial Analysis (دادههای ۲۷ مهر ۱۴۰۵) و LMArena (دادههای ۲۳ مهر ۱۴۰۵) برداشته شدهاند و چون این جدولها مدام بهروز میشوند، ممکن است وقتی شما این متن را میخوانید کمی جابهجا شده باشند.
بنچمارک هوش مصنوعی یک مجموعه آزمون از پیش تعریفشده است: تعدادی سؤال، مسئله یا کار واقعی، به همراه یک روش مشخص برای نمرهدادن. همه مدلها همان آزمون را با همان شرایط میدهند و در پایان یک عدد قابلمقایسه به دست میآید؛ مثلاً درصد سؤالهایی که درست جواب دادهاند یا درصد باگهایی که واقعاً رفع کردهاند.
چرا این موضوع مهم است؟ چون بدون بنچمارک هوش مصنوعی، مقایسه مدلها فقط به تبلیغات شرکتها و تجربههای پراکنده کاربران محدود میشود. اگر برنامهنویس هستید، صاحب یک فروشگاه آنلایناید یا فقط دنبال ابزاری برای تولید محتوا هستید، بنچمارکها نقطه شروع خوبیاند؛ البته فقط نقطه شروع. اگر دوست دارید بحث فلسفیتر «هوشمندی» مدلها را هم دنبال کنید، مقاله آیا هوش مصنوعی واقعاً باهوش است؟ را از دست ندهید.
بنچمارک، لیدربورد و شاخص؛ فرقشان چیست؟
این سه واژه زیاد کنار هم میآیند، پس بیایید یک بار برای همیشه تفکیکشان کنیم:
بنچمارک هوش مصنوعی (Benchmark): خود آزمون؛ مثلاً GPQA یا SWE-bench.
لیدربورد (Leaderboard): جدولی که نتیجه مدلهای مختلف را روی یک یا چند بنچمارک کنار هم نشان میدهد و آنها را رتبهبندی میکند.
شاخص (Index): عددی ترکیبی که از میانگین وزندار چند بنچمارک ساخته میشود تا یک تصویر کلی بدهد؛ مثل Artificial Analysis Intelligence Index.
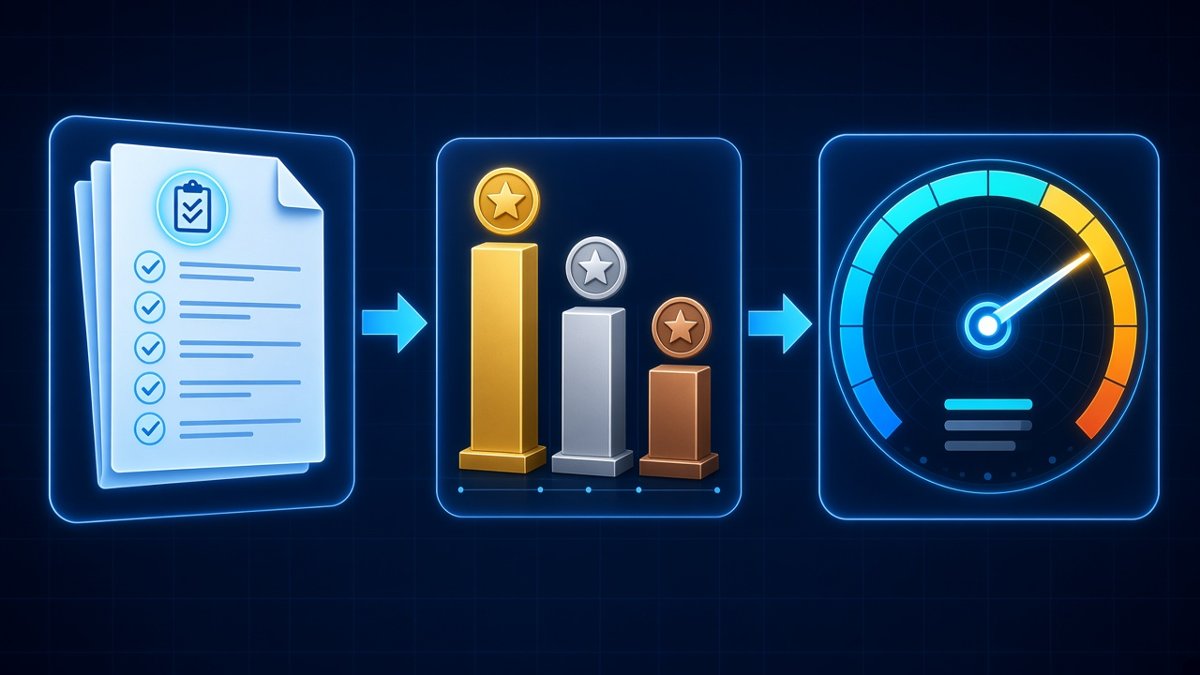
از آزمون تا عدد نهایی: بنچمارک سؤالها را میدهد، لیدربورد نتایج را مرتب میکند و شاخص آنها را در یک عدد خلاصه میکند.
انواع بنچمارک هوش مصنوعی: دانش، استدلال، کدنویسی و ایجنتی
هیچ بنچمارک هوش مصنوعی بهتنهایی همه تواناییهای یک مدل را نمیسنجد. به همین دلیل آزمونها را معمولاً در چند دسته اصلی میشناسیم. در ادامه مهمترین و پراستنادترین آزمونهای هر دسته را مرور میکنیم.
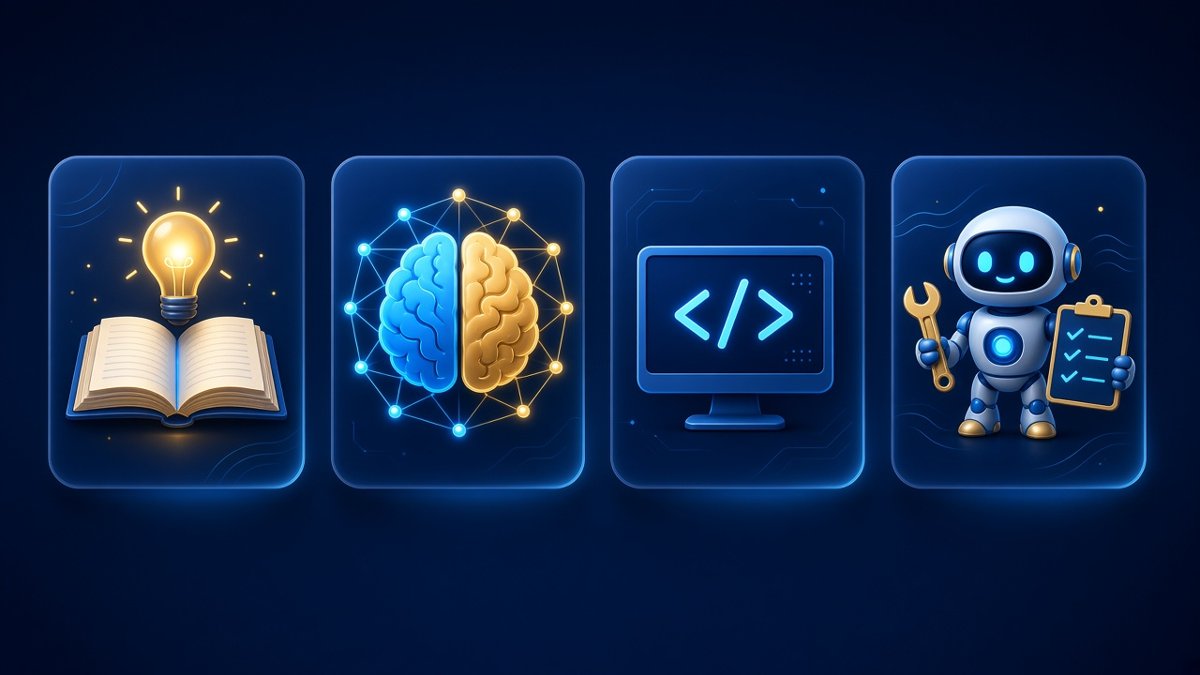
چهار دسته اصلی بنچمارکها: دانش، استدلال، کدنویسی و کارهای ایجنتی.
دانش و استدلال عمومی: MMLU-Pro و GPQA
MMLU-Pro نسخه سختتر آزمون معروف MMLU است. طبق مقاله سازندگانش، این آزمون ۱۲٬۰۳۲ سؤال در ۱۴ حوزه (از ریاضی و فیزیک تا حقوق و روانشناسی) دارد و تعداد گزینهها را از ۴ به ۱۰ رسانده تا شانس درستزدن تصادفی کم شود. مدلهای پیشرفته روی MMLU اصلی به سقف رسیده بودند و در آزمایشهای همان مقاله، دقت مدلها در MMLU-Pro بین ۱۶ تا ۳۳ درصد پایینتر از MMLU بود.
GPQA یک بنچمارک هوش مصنوعی «ضدگوگل» است: ۴۴۸ سؤال چندگزینهای در زیستشناسی، فیزیک و شیمی که متخصصان دارای (یا در حال گذراندن) دکترا نوشتهاند. طبق مقاله اصلی، خود متخصصان حدود ۶۵ درصد (و با کنار گذاشتن اشتباههای آشکارشان ۷۴ درصد) دقت داشتند، اما غیرمتخصصهای باهوش حتی با دسترسی آزاد به وب فقط به ۳۴ درصد رسیدند. زیرمجموعه سختترش، GPQA Diamond، ۱۹۸ سؤال دارد و در گزارشها زیاد میبینیدش.
آزمونهای مرزی: Humanity's Last Exam
Humanity's Last Exam (HLE) را مرکز ایمنی هوش مصنوعی (CAIS) ساخته و جزو سختترین آزمونهای دانشگاهی امروز است. Artificial Analysis از ۲٬۱۵۸ سؤالِ فقطمتنیِ آن (از مجموع ۲٬۵۰۰ سؤال نسخه مه ۲۰۲۵) استفاده میکند.
ریاضی: AIME
AIME در اصل یک آزمون رقابتی ریاضی برای دانشآموزان مستعد در آمریکاست و سؤالهای چندمرحلهای و دقیقی دارد. این آزمون نشان میدهد مدل در استدلال ریاضی گامبهگام چقدر قوی است. چون سؤالهای هر سال جدید است، نسخههای تازهتر کمتر در دادههای آموزشی مدلها دیده شدهاند.
کدنویسی: LiveCodeBench و SWE-bench
LiveCodeBench مسئلههای برنامهنویسی را بهطور مداوم از مسابقههای LeetCode، AtCoder و CodeForces جمع میکند و به هر مسئله تاریخ انتشار میزند. به این ترتیب میشود مدل را فقط روی مسئلههای منتشرشده بعد از پایان دادههای آموزشیاش سنجید و جلوی آلودگی داده (Contamination) را گرفت.
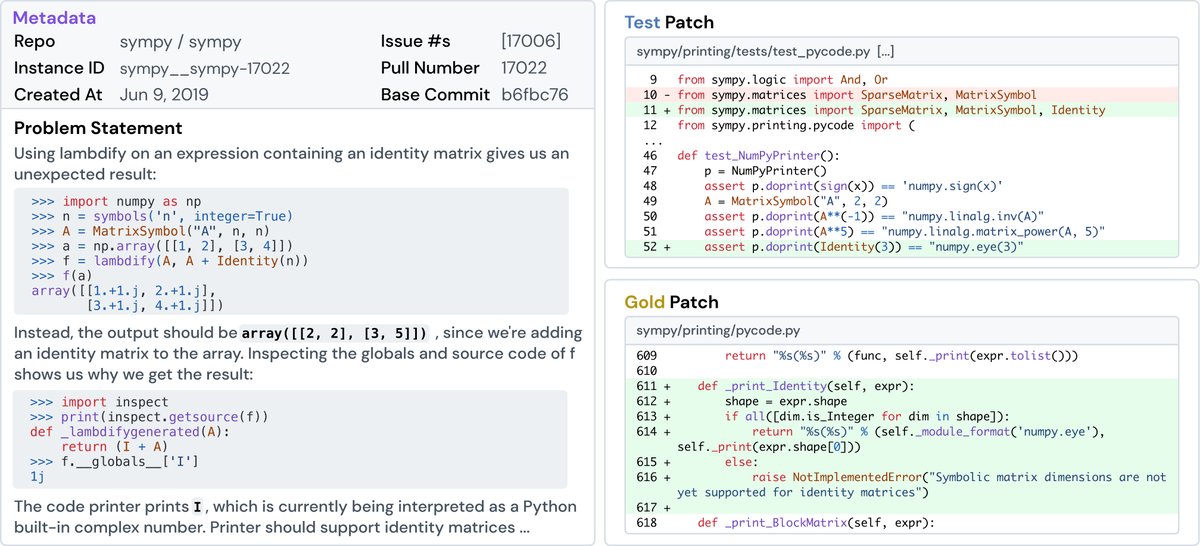
SWE-bench بنچمارک هوش مصنوعیای است که یک قدم به دنیای واقعی نزدیکتر است: مدل یک Issue واقعی از گیتهاب و کل کدبیس پروژه را میگیرد و باید پچی بنویسد که تستهای واقعی آن پروژه را پاس کند. نسخه اصلی ۲٬۲۹۴ مسئله از ۱۲ مخزن محبوب پایتون دارد. نسخه Verified (۵۰۰ مسئله که انسانها پالایششان کردهاند) معروفترین نسخه است و نسخههای Lite (۳۰۰ مسئله) و Multilingual (۳۰۰ مسئله از ۹ زبان برنامهنویسی) هم وجود دارند.
یک نمونه واقعی از SWE-bench: شرح Issue گیتهاب در سمت چپ و پچ تست و پچ مرجع (Gold Patch) در سمت راست. منبع تصویر: arXiv — مقاله SWE-bench
بنچمارکهای ایجنتی: Terminal-Bench و GDPval
نسل جدید بنچمارک هوش مصنوعی دیگر فقط سؤالوجواب نیستند؛ مدل باید مثل یک ایجنت هوش مصنوعی (AI Agent) در یک محیط واقعی یا شبیهسازیشده چند مرحله کار انجام دهد: دستور ترمینال اجرا کند، فایل بسازد، با APIها کار کند و خروجی نهایی تحویل دهد. نمونههایش Terminal-Bench (اجرای کار در ترمینال)، GDPval-AA (کارهای حرفهای و دانشی) و AutomationBench-AA (خودکارسازی گردشکار در اپلیکیشنهای SaaS) هستند. اهمیت این دسته آنقدر زیاد شده که در شاخص هوش Artificial Analysis جزو پروزنترین دستههاست.
بنچمارک
چه چیزی را میسنجد؟
نوع پاسخ
نکته کلیدی
MMLU-Pro
دانش و استدلال در ۱۴ حوزه
چندگزینهای (۱۰ گزینه)
۱۲٬۰۳۲ سؤال؛ نسخه سختتر MMLU
GPQA (Diamond)
استدلال علمی سطح تحصیلات تکمیلی
چندگزینهای (۴ گزینه)
۴۴۸ سؤال (Diamond: ۱۹۸)؛ با جستجوی گوگل حل نمیشود
Humanity's Last Exam
دانش و استدلال مرزی دانشگاهی
پاسخ باز
۲٬۱۵۸ سؤال متنی در اجرای Artificial Analysis
AIME
استدلال ریاضی چندمرحلهای
پاسخ عددی
سؤالهای سالانه مسابقه ریاضی آمریکا
LiveCodeBench
حل مسئله برنامهنویسی
کد قابل اجرا
مسئلههای تاریخدار برای جلوگیری از آلودگی داده
SWE-bench Verified
رفع Issue واقعی در کدبیس
پچ کد + اجرای تست
۵۰۰ مسئله پالایششده توسط انسان
Terminal-Bench / GDPval-AA
کار ایجنتی چندمرحلهای
انجام کار و تحویل فایل
محور اصلی شاخصهای جدید
لیدربوردهای مرجع برای رتبهبندی LLM: Artificial Analysis و LMArena
برای دیدن نتایج بنچمارک هوش مصنوعی لیدربوردهای زیادی وجود دارد، اما دو مرجع بیش از همه استناد میشوند و خوشبختانه دو نگاه متفاوت به ارزیابی مدل هوش مصنوعی دارند.
Artificial Analysis: شاخص هوش، قیمت و سرعت مدلها
Artificial Analysis یک مرجع مستقل است که بیش از ۲۵۰ مدل زبانی را از نظر هوش، قیمت، سرعت، تأخیر و اندازه کانتکست مقایسه میکند. قلب آن Artificial Analysis Intelligence Index است که در نسخه فعلی (v4.3.2) از ۱۰ ارزیابی ساخته شده و وزن دستههایش اینطور است: ایجنتها ۳۰٪، کدنویسی ۲۰٪، استدلال علمی ۲۰٪ و عمومی ۳۰٪. نکته جالب اینکه بنچمارکهای کلاسیکی مثل MMLU-Pro و AIME دیگر جزو این ده ارزیابی نیستند و جایشان را آزمونهای ایجنتی و سختتری مثل HLE، Terminal-Bench 4.0 و SciCode گرفتهاند؛ نشانهای از اینکه بنچمارکها هم پیر میشوند. جزئیات کامل وزنها و نحوه محاسبه را میتوانید در صفحه روششناسی شاخص هوش Artificial Analysis ببینید.
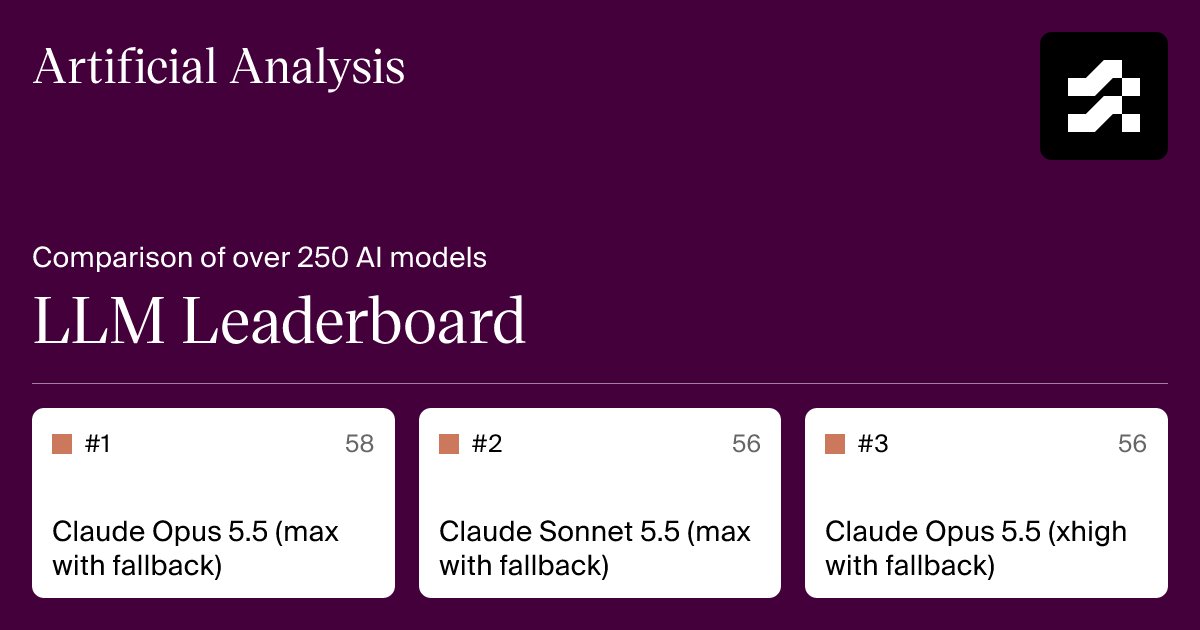
طبق لیدربورد این سایت در ۲۷ مهر ۱۴۰۵، Claude Opus 5.5 (در حالت استدلال max) با امتیاز ۵۸ در صدر است و بعد از آن چند مدل با امتیاز ۵۶ قرار دارند؛ از جمله Claude Sonnet 5.5 (max)، نسخه xhigh همین Opus و Muse Wonder Full (max) از Meta. بهترین مدل متنباز (Open Weights) هم MiMo-V2.6-Pro با امتیاز ۴۶ است.
تصویر معرفی لیدربورد Artificial Analysis با سه رتبه اول شاخص هوش در زمان نگارش (۲۷ مهر ۱۴۰۵). منبع تصویر: Artificial Analysis
LMArena: رتبهبندی بر اساس رأی کاربران واقعی
LMArena رویکرد کاملاً متفاوتی دارد: بهجای یک بنچمارک هوش مصنوعی از پیش نوشتهشده، کاربران واقعی یک سؤال میپرسند، جواب دو مدل ناشناس را میبینند و به بهتری رأی میدهند. از جمع این رأیها امتیازی شبیه Elo شطرنج ساخته میشود. در بهروزرسانی ۲۳ مهر ۱۴۰۵ بخش متنی این لیدربورد، بیش از ۸٫۸ میلیون رأی برای ۴۱۶ مدل ثبت شده و Gemini 4 Argon (High) با امتیاز ۱۵۲۴ (هنوز با برچسب «مقدماتی») رتبه اول را دارد.
حالا ببینید وقتی این دو لیدربورد را کنار هم میگذاریم چه میشود:
مدل
شاخص هوش AA
هزینه اجرای شاخص (دلار)
سرعت خروجی (توکن/ثانیه)
امتیاز LMArena متنی (رتبه)
Claude Opus 5.5
۵۸ (max)
۵٫۹۸
۹۵
۱۵۰۸ (۳) — نسخه High
Gemini 4 Argon (High)
۵۳
۱٫۹۹
ثبت نشده
۱۵۲۴ (۱) — مقدماتی
GPT-6 Astra (max)
۵۳
۳٫۲۶
۶۸
۱۴۷۷ (۳۰)
MiMo-V2.6-Pro (متنباز)
۴۶
۰٫۱۳
۵۱
۱۴۷۹ (۲۷)
منبع: Artificial Analysis (۲۷ مهر ۱۴۰۵) و LMArena Text Arena (۲۳ مهر ۱۴۰۵). نسخهها و سطح استدلال مدلها در دو سایت همیشه یکسان نیست.
درس اصلی این جدول ساده است: مدلی که در آزمونهای سخت و ایجنتی اول است، لزوماً در سلیقه کاربران اول نیست و برعکس. GPT-6 Astra در شاخص هوش همامتیاز Gemini 4 Argon است، اما در رأی کاربران حدود ۴۷ امتیاز پایینتر قرار دارد. برای مقایسه کاربردیترِ خود اپلیکیشنها هم سری به مقایسه کامل ChatGPT، Claude، Gemini و Copilot بزنید.
چطور جدول لیدربورد مدلهای هوش مصنوعی را بخوانیم؟
جدول لیدربورد در نگاه اول پر از عدد است، اما وقتی بدانید هر ستون کدام بنچمارک هوش مصنوعی یا کدام معیار را نشان میدهد، خواندنش ساده میشود:
اول معیار اصلی را پیدا کنید. ستون شاخص هوش (یا امتیاز Elo) جمعبندی کلی است، نه حکم نهایی.
به هزینه نگاه کنید. Artificial Analysis ستونی به نام Cost per Task دارد؛ یعنی هزینه واقعی اجرای کل آزمونهای شاخص با آن مدل. مثلاً GPT-6.1 Sol (max) با امتیاز ۵۲ حدود ۰٫۷۲ دلار هزینه داشته، در حالی که Claude Opus 5.5 (max) با امتیاز ۵۸ حدود ۵٫۹۸ دلار؛ یعنی شش امتیاز بیشتر با هزینهای حدوداً هشت برابر.
سرعت و تأخیر را جدا بخوانید. «سرعت خروجی» تعداد توکنی است که مدل بعد از شروع پاسخ در هر ثانیه تولید میکند و «تأخیر» (TTFT) زمانی است که تا رسیدن اولین بخش پاسخ منتظر میمانید. در مدلهای استدلالی، این تأخیر زمان «فکرکردن» را هم شامل میشود.
کانتکست را چک کنید. Context Window برای کار با اسناد طولانی حیاتی است.
چهار ستونی که در هر ردیف لیدربورد باید با هم ببینید: هوش، هزینه، سرعت و تأخیر.
سطح استدلال مدل (low تا max) را جدی بگیرید
در لیدربوردهای امروزی یک مدل چند بار تکرار میشود: مثلاً Claude Opus 5.5 با حالتهای max، xhigh، high، medium و low. اینها مقدار «فکرکردن» مدل قبل از جوابدادن است. طبق دادههای Artificial Analysis، همین مدل در حالت max امتیاز ۵۸ میگیرد و در حالت low امتیاز ۴۲؛ البته تأخیر اولین پاسخ در حالت max حدود ۵۶۳ ثانیه است و حالتهای پایینتر خیلی سریعتر جواب میدهند. پس وقتی کسی میگوید «مدل X امتیاز Y دارد»، همیشه بپرسید: در کدام حالت؟
چرا سریعترین مدل لزوماً بهترین نیست؟
سریعترین مدل جدول Artificial Analysis، Celeris-1 با حدود ۱٬۴۸۵ توکن بر ثانیه است، اما شاخص هوشش فقط ۶ است. در مقابل، DeepSeek V4.1 Flash 1017 (max) با شاخص ۴۵ هم حدود ۲۲۷ توکن بر ثانیه سرعت دارد و هم هزینه اجرای شاخصش حدود ۰٫۲۶ دلار است. یعنی نقطه تعادل خوب گاهی جایی غیر از صدر جدول است.
بازه اطمینان و رتبههای نزدیک به هم
کنار امتیازهای LMArena عددی مثل «±۹» میبینید. این یعنی امتیاز واقعی میتواند در همین حدود بالا و پایین برود. وقتی فاصله دو مدل از این بازه کمتر است، عملاً همسطحاند؛ به همین دلیل LMArena برای هر مدل یک «بازه رتبه» هم نشان میدهد. اختلاف یکی دو امتیاز دلیل خوبی برای عوضکردن ابزار نیست.
محدودیتهای بنچمارک هوش مصنوعی و خطاهای رایج در تفسیر نتایج
هر بنچمارک هوش مصنوعی، هرچقدر هم دقیق، چند دام مهم دارد که باید بشناسید:
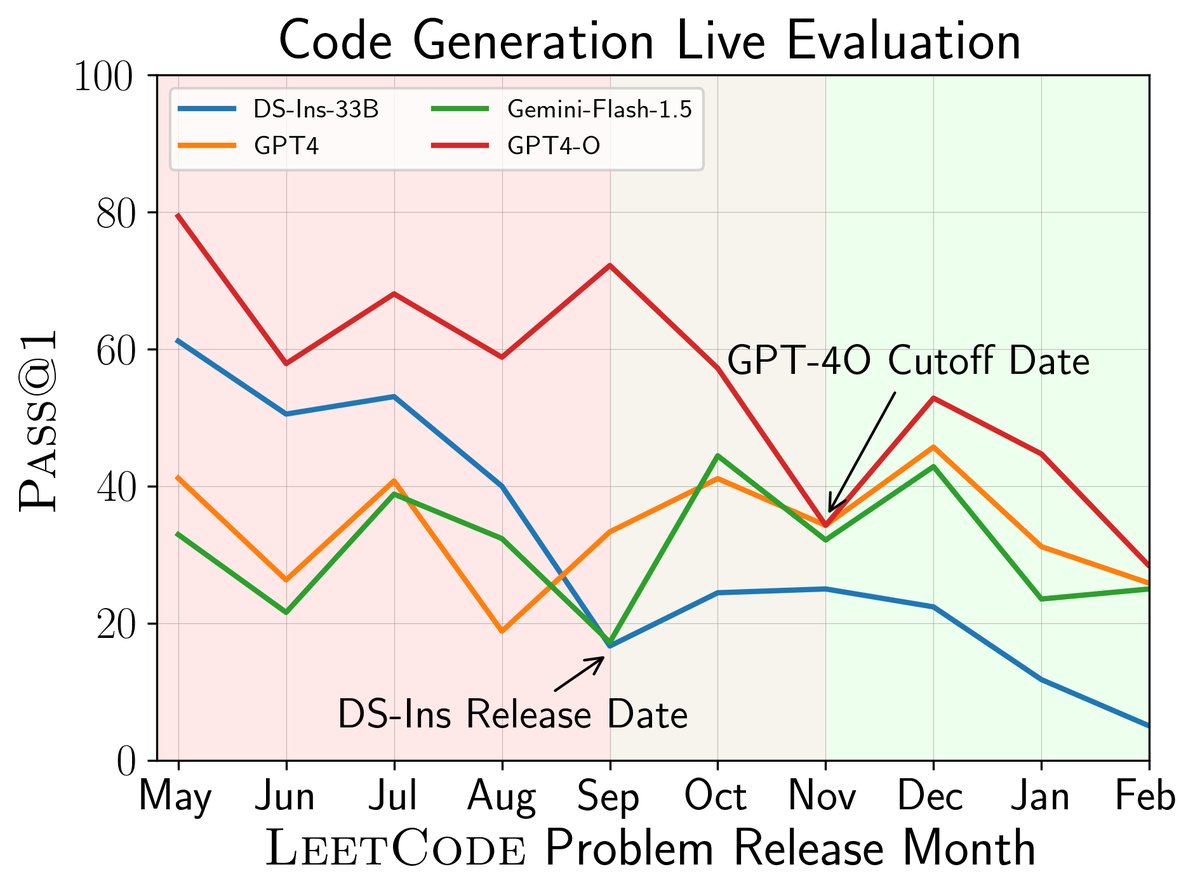
آلودگی داده: اگر سؤالهای یک آزمون در دادههای آموزشی مدل بوده باشد، نمره بالا به معنی فهم واقعی نیست. پژوهشگران LiveCodeBench نشان دادند عملکرد برخی مدلها روی مسئلههای منتشرشده بعد از تاریخ آموزششان بهطور محسوسی افت میکند.
اشباع (Saturation): وقتی همه مدلهای برتر به سقف یک آزمون میرسند، آن آزمون دیگر تفاوتی نشان نمیدهد. همین اتفاق برای MMLU افتاد و دلیل ساخت MMLU-Pro شد.
حساسیت به پرامپت و تنظیمات: طبق مقاله MMLU-Pro، تغییر سبک پرامپت در MMLU نمره را ۴ تا ۵ درصد جابهجا میکرد. پس مقایسه نمرههایی که سایتهای مختلف با روشهای متفاوت گرفتهاند، خطرناک است.
تمرکز روی انگلیسی: Artificial Analysis صریحاً میگوید شاخص هوشش عمدتاً متنی و انگلیسی است. شاخص چندزبانهاش هم ۱۶ زبان را پوشش میدهد، اما فارسی جزو آنها نیست. پس عملکرد فارسی را باید جداگانه بسنجید. اگر دغدغه زبان برایتان آشناست، مقاله برنامهنویسی بدون دانستن زبان انگلیسی را هم بخوانید.
قیمت توکنی گولزننده است: مدلها توکنایزرهای متفاوتی دارند و یک متن یکسان در آنها تعداد توکن متفاوتی میشود؛ خود Artificial Analysis هم میگوید قیمتها همیشه مستقیماً قابلمقایسه نیستند. ستون Cost per Task تصویر واقعیتری میدهد.
شرایط اندازهگیری سرعت: Artificial Analysis سرعت را بهطور پیشفرض با پرامپتهای حدود ۱۰ هزار توکنی و از سروری در مرکز آمریکا میسنجد و میانه ۷۲ ساعت اخیر را گزارش میکند؛ تجربه شما از ایران ممکن است فرق کند.
نمره بالا یعنی بیخطا نیست: حتی بهترین مدلها هم دچار توهم (Hallucination) میشوند. برای همین شاخص فعلی Artificial Analysis بخشی از امتیاز را به «کمتوهمبودن» اختصاص داده است. پیامدهای این مسئله را پیشتر در مقاله بررسی چهار خطر بزرگ هوش مصنوعی مرور کردهایم.
نمونهای از اثر آلودگی داده در LiveCodeBench: عملکرد برخی مدلها روی مسئلههای LeetCode منتشرشده بعد از تاریخ پایان آموزششان افت میکند. منبع تصویر: arXiv — مقاله LiveCodeBench
انتخاب بهترین مدل هوش مصنوعی بر اساس نیاز شما
حالا که خواندن نتایج بنچمارک هوش مصنوعی را بلدیم، وقت استفاده عملی است. بهجای پرسیدن «بهترین مدل کدام است؟» بپرسید «بهترین مدل برای کار من کدام است؟». چند سناریوی رایج:
بهترین مدل همان است که با کار، بودجه و انتظار شما از سرعت جور باشد.
برنامهنویسی و کار با کدبیس: به نمرههای SWE-bench، Terminal-Bench و بخش کدنویسی شاخصها نگاه کنید و حالتهای استدلالی بالاتر را امتحان کنید. تأخیر بیشتر در این کارها معمولاً ارزشش را دارد.
چتبات سایت یا پشتیبانی مشتری: اینجا تأخیر کم و هزینه پایین مهمتر از چند امتیاز هوش بیشتر است. مدلهای سریع و ارزان با شاخص متوسط، یا همان مدلهای قوی در حالت low، انتخابهای منطقیاند. اگر میخواهید مدل را به سایتتان وصل کنید، مقاله اتصال سرویسهای وبسایت با API کمکتان میکند.
تولید محتوا و نوشتن: رأی کاربران در LMArena برای کیفیت متن و لحن نشانه خوبی است، اما حتماً خروجی فارسی را خودتان تست کنید و به اصول محتوای مفید و قابلاعتماد پایبند بمانید.
بودجه محدود یا اجرای روی سرور خودتان: فیلتر Open Weights را بزنید. مدلهایی مثل MiMo-V2.6-Pro و DeepSeek V4.1 Flash نشان میدهند که فاصله مدلهای متنباز با صدر جدول آنقدرها هم زیاد نیست.
در نهایت، یک بنچمارک هوش مصنوعی شخصی، یعنی تست کوچکی روی دادههای واقعی خودتان، مثلاً ۲۰ نمونه سؤال یا متن از کسبوکارتان، از هر جدول رتبهبندی LLM ارزشمندتر است. لیدربورد فهرست کاندیداها را کوتاه میکند و تست شخصی تصمیم نهایی را میگیرد. برای دیدن رتبهبندی ماهانه مدلها هم جدول رتبهبندی مدلهای هوش مصنوعی رادینو را دنبال کنید.
سوالات متداول درباره بنچمارکها و لیدربوردهای AI
بنچمارک به زبان ساده یعنی چه؟
بنچمارک هوش مصنوعی یک آزمون استاندارد است که همه مدلها با سؤالها و شرایط یکسان آن را میدهند تا نمرههایشان قابلمقایسه باشد؛ مثل کنکوری مشترک برای مدلهای زبانی.
معتبرترین لیدربورد مدلهای زبانی کدام است؟
دو مرجع پراستناد Artificial Analysis (ترکیب چند بنچمارک سخت بههمراه قیمت و سرعت) و LMArena (رأی کاربران واقعی در مقایسههای دوبهدو) هستند. بهتر است هر دو را با هم ببینید، چون نتایجشان همیشه یکی نیست.
امتیاز Elo در LMArena چه معنایی دارد؟
امتیازی نسبی است که از برد و باخت مدلها در رأیگیریهای دوبهدو ساخته میشود. عدد بالاتر یعنی کاربران معمولاً پاسخ آن مدل را ترجیح دادهاند. به بازه اطمینان کنار امتیاز هم دقت کنید.
آیا مدلی که در بنچمارک اول است، برای فارسی هم بهترین است؟
نه لزوماً. بیشتر بنچمارکهای هوش مصنوعی انگلیسیاند؛ شاخص هوش Artificial Analysis عمدتاً انگلیسی است و شاخص چندزبانهاش هم فارسی را پوشش نمیدهد. برای کارهای فارسی، چند مدل برتر را روی متنهای فارسی خودتان امتحان کنید.
چرا یک مدل چند بار با برچسبهای low، high و max در جدول آمده است؟
این برچسبها سطح استدلال یا مقدار «فکرکردن» مدل را نشان میدهند. سطح بالاتر معمولاً امتیاز بیشتر، اما هزینه و زمان انتظار بیشتری هم دارد.
جمعبندی: از خواندن لیدربورد تا انتخاب هوشمندانه مدل
بنچمارک هوش مصنوعی قطبنمای ما در دنیای شلوغ مدلهای زبانی است: به ما میگوید هر مدل در دانش، استدلال، کدنویسی و کارهای ایجنتی کجا ایستاده و با چه هزینه و سرعتی. اما قطبنما نقشه نیست. لیدربوردها را با دقت بخوانید، به سطح استدلال و هزینه هر کار توجه کنید، آلودگی داده و تمرکز انگلیسی آزمونها را در نظر بگیرید و در نهایت مدل را روی کار واقعی خودتان محک بزنید.
اگر میخواهید استفاده حرفهای از ابزارهای هوش مصنوعی را قدمبهقدم و به زبان ساده یاد بگیرید، دوره کپسول هوش مصنوعی رادینو برای شما طراحی شده است. و اگر میخواهید هوش مصنوعی را در سایت یا کسبوکارتان به کار بگیرید، تیم رادینو در طراحی و توسعه وبسایت کنارتان است.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.