تا دو سال پیش، «مدل هوش مصنوعی متن باز» معمولاً یعنی مدلی که چند پله پایینتر از ChatGPT و Claude بود و بیشتر به درد آزمایش و پژوهش میخورد. امروز این تصویر عوض شده است. مدلهای وزنباز (Open Weights) چینی و آمریکایی حالا در بسیاری از کارها به مدلهای بسته نزدیک شدهاند و برخیشان با کسری از قیمت، همان کار را انجام میدهند.
در این مقاله بهترین مدلهای متنباز سال ۲۰۲۶ را بر اساس سه معیار رتبهبندی میکنیم: هوش (امتیاز مستقل Artificial Analysis)، اندازه (و اینکه روی چه سختافزاری اجرا میشوند) و مجوز استفاده. اگر دنبال تصویر کلی همهٔ مدلها، چه باز و چه بسته، هستید، رتبهبندی ماهانهٔ مدلهای هوش مصنوعی را هم ببینید.
آخرین بهروزرسانی: ۳ آبان ۱۴۰۵ — امتیازها از Artificial Analysis (Intelligence Index v4.3.2) و مشخصات و مجوزها از کارت رسمی مدلها در Hugging Face برداشته شدهاند (دریافت: ۳ آبان ۱۴۰۵).
⚡ پاسخ کوتاه
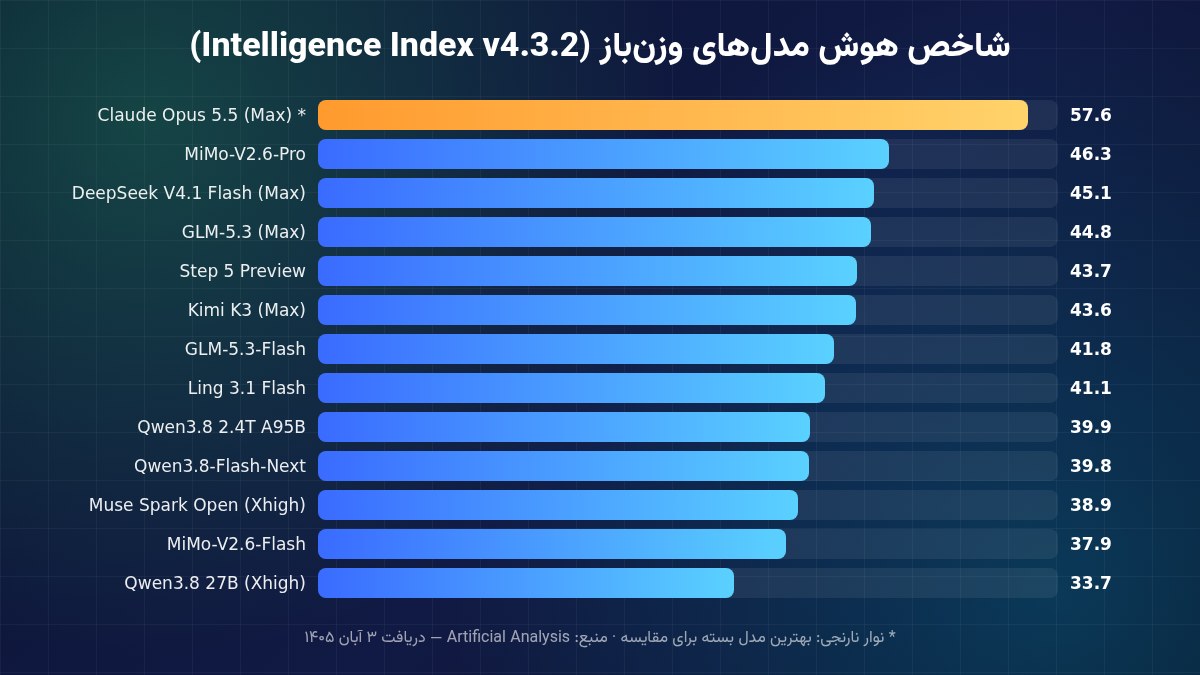
در آبان ۱۴۰۵، قویترین مدل وزنباز طبق Artificial Analysis مدل MiMo-V2.6-Pro شیائومی با شاخص هوش ۴۶.۳ است. بعد از آن DeepSeek V4.1 Flash (۴۵.۱)، GLM-5.3 (۴۴.۸)، Step 5 Preview (۴۳.۷) و Kimi K3 (۴۳.۶) قرار دارند. بهترین مدل بسته (Claude Opus 5.5 با ۵۷.۶) هنوز حدود ۱۱ امتیاز جلوتر است. برای استفادهٔ تجاری بیدردسر، مدلهای با مجوز MIT یا Apache 2.0 مثل DeepSeek V4.1 Flash، MiMo-V2.6-Pro، GLM-5.3-Flash و Qwen3.8-27B امنترین انتخاباند. برای اجرا روی یک کارت گرافیک یا لپتاپ قوی، مدلهای کوچکی مثل Qwen3.8-27B و Gemma 4 مناسبترند.
مدل متنباز یا دقیقتر «وزنباز» مدلی است که فایل وزنهایش منتشر شده و میتوانید آن را دانلود کنید، روی سرور خودتان اجرا کنید، با دادهٔ خودتان آموزش تکمیلی (Fine-tune) بدهید یا از هر ارائهدهندهٔ ابری که خواستید API آن را بخرید. این آزادی چند مزیت مهم دارد:
حریم خصوصی و کنترل داده: وقتی مدل روی سرور خودتان اجرا شود، هیچ متنی از سازمان شما به شرکت سازنده نمیرسد. این برای بانکها، بیمارستانها و شرکتهای حقوقی اهمیت زیادی دارد.
هزینهٔ کمتر: رقابت ارائهدهندههای مختلف روی یک مدل باز قیمت را پایین میآورد. مثلاً MiMo-V2.6-Pro طبق Artificial Analysis هزینهٔ هر تسک ۰.۱۳ دلار دارد، در حالی که این عدد برای Claude Opus 5.5 در حالت Max حدود ۵.۹۸ دلار است.
بینیازی از یک شرکت خاص: اگر سازنده قیمت را بالا ببرد، سرویس را قطع کند یا دسترسی از ایران را ببندد، نسخهٔ دانلودشده همچنان در اختیار شماست.
شخصیسازی: میتوانید مدل را برای زبان، لحن یا حوزهٔ تخصصی خودتان بهینه کنید، کاری که با مدلهای بسته یا ممکن نیست یا گران است.
Open Weights با Open Source یکی نیست
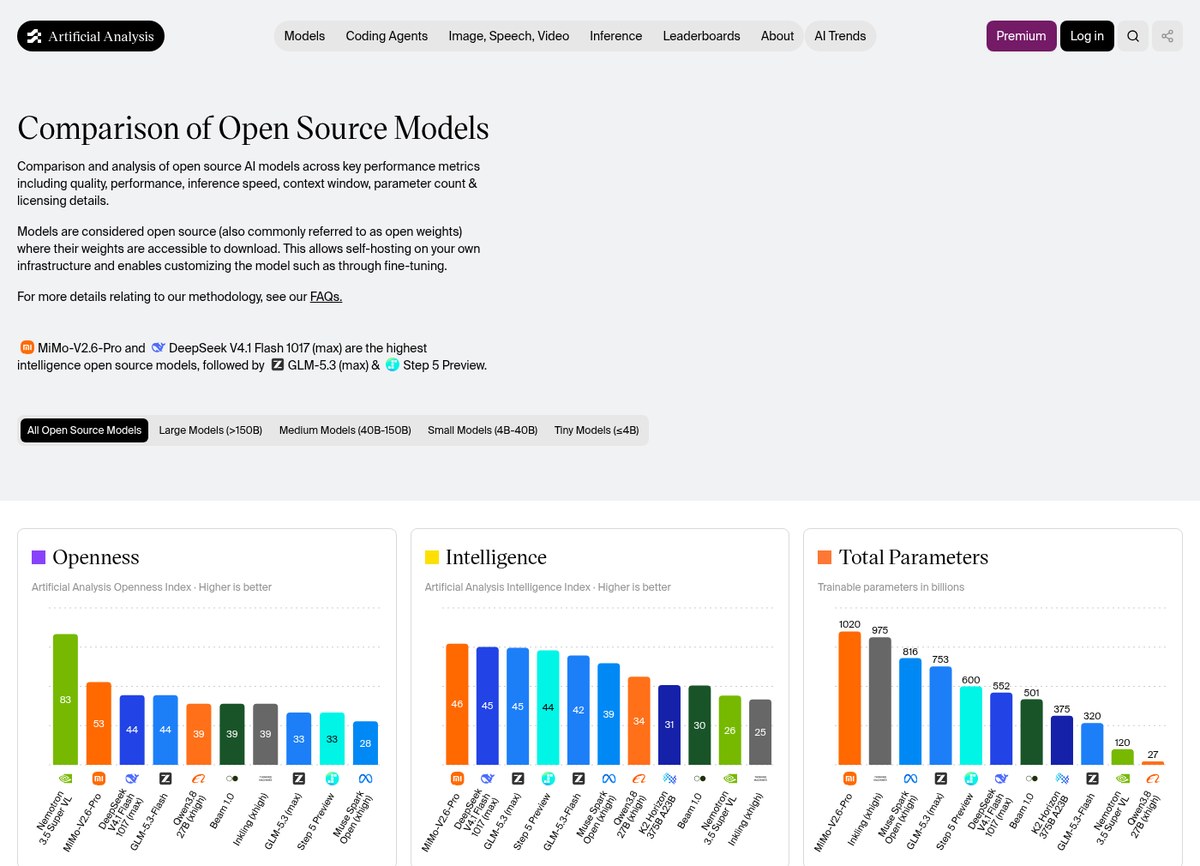
بیشتر مدلهایی که در رسانهها «متنباز» نامیده میشوند در واقع فقط وزنهایشان باز است. دادهٔ آموزشی، کد آموزش و جزئیات کامل فرایند ساخت معمولاً منتشر نمیشود. به همین دلیل Artificial Analysis در صفحهٔ مقایسهٔ مدلهای باز توضیح میدهد که منظورش از Open Source همان مدلهایی است که «وزنهایشان برای دانلود در دسترس است». این سایت کنار شاخص هوش، یک شاخص بازبودن (Openness Index) هم منتشر میکند. در آن، Nemotron 3.5 Super VL از NVIDIA با امتیاز ۸۳ بازترین مدل است و MiMo-V2.6-Pro با ۵۳ در رتبهٔ دوم قرار دارد. یعنی حتی میان مدلهای وزنباز هم میزان شفافیت یکسان نیست.
صفحهٔ مقایسهٔ مدلهای متنباز Artificial Analysis با سه نمودار بازبودن، هوش و تعداد پارامتر (۳ آبان ۱۴۰۵). منبع تصویر: Artificial Analysis
معایب مدلهای باز
مدل باز رایگان نیست، فقط هزینهاش جابهجا میشود. مدلهای بزرگ این فهرست صدها میلیارد تا چند تریلیون پارامتر دارند و اجرای آنها به چند GPU مرکز داده نیاز دارد. نگهداری، بهروزرسانی، امنیت و مقیاسپذیری هم با خود شماست. برای بیشتر کسبوکارهای کوچک، خرید API همان مدل باز از یک ارائهدهنده منطقیتر از راهاندازی سرور شخصی است.
رتبهبندی مدلهای بزرگ متنباز
جدول زیر مدلهای وزنباز را بر اساس شاخص هوش Artificial Analysis مرتب کرده است. این شاخص میانگین وزنی ۱۰ ارزیابی در حوزههای ایجنت، کدنویسی، استدلال علمی و دانش عمومی است. اگر با روش محاسبهاش آشنا نیستید، راهنمای Artificial Analysis و راهنمای بنچمارکهای هوش مصنوعی را بخوانید.
رتبه
مدل
سازنده
شاخص هوش
هزینهٔ هر تسک
قیمت API (ورودی/خروجی)
۱
MiMo-V2.6-Pro
Xiaomi
۴۶.۳
۰.۱۳ دلار
۰.۴۴ / ۰.۸۷ دلار
۲
DeepSeek V4.1 Flash 1017 (Max)
DeepSeek
۴۵.۱
۰.۲۶ دلار
۰.۳۰ / ۱.۲۰ دلار
۳
GLM-5.3 (Max)
Z.ai
۴۴.۸
۲.۰۱ دلار
۱.۴۰ / ۴.۴۰ دلار
۴
Step 5 Preview
StepFun
۴۳.۷
۱.۰۳ دلار
۱.۰۰ / ۲.۷۰ دلار
۵
Kimi K3 (Max)
Moonshot AI
۴۳.۶
—
—
۶
GLM-5.3-Flash
Z.ai
۴۱.۸
۰.۲۸ دلار
۰.۱۵ / ۰.۵۰ دلار
۷
Ling 3.1 Flash
InclusionAI
۴۱.۱
۱.۰۱ دلار
۰.۳۰ / ۰.۹۰ دلار
۸
Qwen3.8 2.4T A95B
Alibaba
۳۹.۹
۲.۱۶ دلار
۲ / ۶ دلار
۹
Qwen3.8-Flash-Next
Alibaba
۳۹.۸
۰.۳۷ دلار
۰.۱۵ / ۰.۴۷ دلار
۱۰
Muse Spark Open (Xhigh)
Meta
۳۸.۹
۰.۸۴ دلار
۱.۲۵ / ۴.۲۵ دلار
قیمتها برای هر میلیون توکن و طبق جدول Artificial Analysis هستند؛ برای مدلهای باز، قیمت به ارائهدهنده بستگی دارد. برای Kimi K3 در جدول فعلی سایت هزینهٔ هر تسک ثبت نشده است.
شاخص هوش مدلهای وزنباز؛ نوار نارنجی بهترین مدل بسته را برای مقایسه نشان میدهد. منبع تصویر: تحریریه رادینو
۱. MiMo-V2.6-Pro؛ قویترین و بهصرفهترین
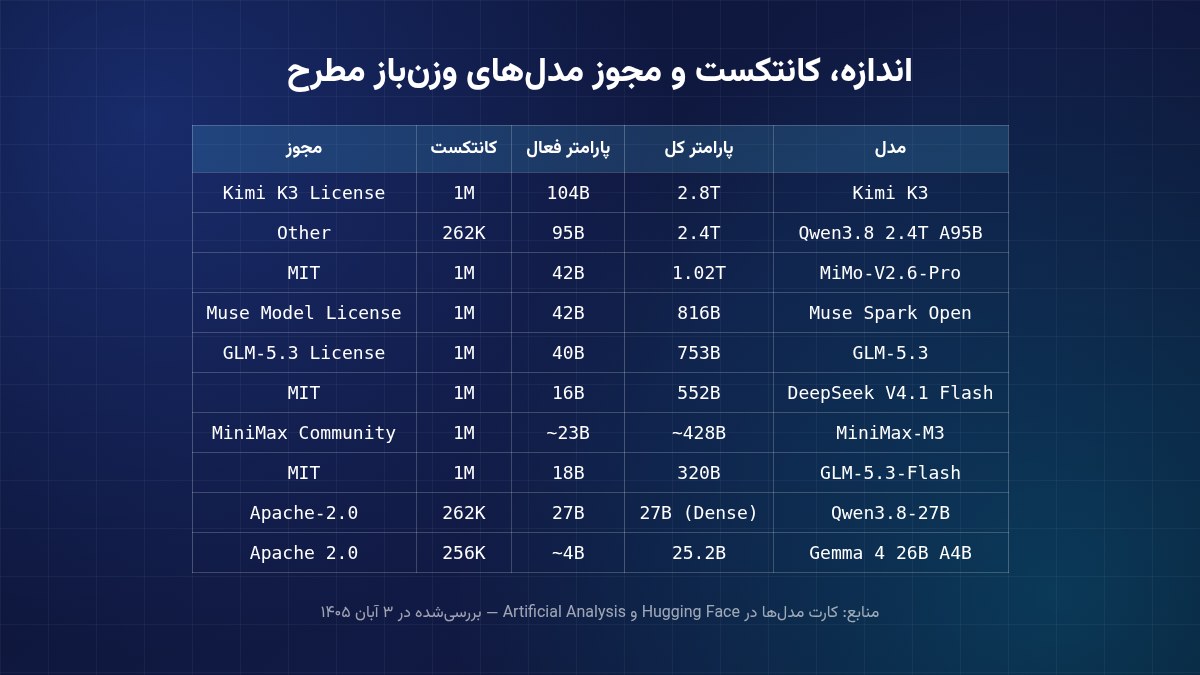
مدل شیائومی با ۱.۰۲ تریلیون پارامتر کل و ۴۲ میلیارد پارامتر فعال، معماری MoE (ترکیب متخصصها) دارد و ورودی متن، تصویر، ویدیو و صدا را میپذیرد. پنجرهٔ زمینهاش یک میلیون توکن و مجوزش MIT است. ترکیب «بالاترین امتیاز میان مدلهای باز» و «هزینهٔ هر تسک ۰.۱۳ دلاری» آن را به گزینهٔ اول این فهرست تبدیل کرده است. وزنها در مخزن XiaomiMiMo/MiMo-V2.6-Pro-RL در Hugging Face منتشر شدهاند.
۲. DeepSeek V4.1 Flash؛ سریع، ارزان و MIT
نسخهٔ 1017 از DeepSeek V4.1 Flash با ۵۵۲ میلیارد پارامتر کل و فقط ۱۶ میلیارد پارامتر فعال، سبکترین مدل بزرگ این جدول در زمان اجراست. سرعت خروجیاش طبق Artificial Analysis حدود ۱۹۵ توکن در ثانیه است. در API رسمی با نام deepseek-flash عرضه میشود و در ساعتهای خلوت نصف قیمت است. جزئیات بیشتر را در مقایسهٔ مدلهای هوش مصنوعی چینی آوردهایم.
۳. GLM-5.3؛ قوی اما گرانتر
مدل Z.ai (برند بینالمللی Zhipu AI) با ۷۵۳ میلیارد پارامتر کل و ۴۰ میلیارد فعال، در سطح Max تقریباً همامتیاز DeepSeek است. ولی هزینهٔ هر تسکش حدود ۸ برابر است، چون هم قیمت توکن بالاتری دارد و هم توکن بیشتری مصرف میکند. نسخهٔ سبکتر آن، GLM-5.3-Flash (۳۲۰ میلیارد کل / ۱۸ میلیارد فعال) با امتیاز ۴۱.۸ و مجوز MIT، برای بیشتر کاربردها انتخاب اقتصادیتری است.
۴. Kimi K3 و وضعیت Kimi K3.1 Pro
Kimi K3 از Moonshot AI با ۲.۸ تریلیون پارامتر کل و ۱۰۴ میلیارد فعال، بزرگترین مدل این فهرست است و امتیاز ۴۳.۶ دارد. نسخهٔ جدیدتر، Kimi K3.1 Pro، با امتیاز ۵۵.۱ در رتبهٔ چهارم کل جدول Artificial Analysis قرار گرفته است. ولی وزنهایش هنوز منتشر نشده و Moonshot وعدهٔ انتشار آن را تا ۱۳ آبان ۱۴۰۵ داده است. اگر این وعده عملی شود، فاصلهٔ مدلهای باز و بسته ناگهان به کمتر از ۳ امتیاز میرسد. بررسی کامل را در بررسی Kimi K3.1 Pro و عددهای آن را در بنچمارک Kimi K3.1 Pro بخوانید.
۵. Qwen3.8، Muse Spark Open و Step 5
علیبابا در نسل Qwen3.8 هم مدل غولپیکر ۲.۴ تریلیون پارامتری (۹۵ میلیارد فعال) را با وزن باز منتشر کرده و هم Qwen3.8-Flash-Next را، که با قیمت ۰.۱۵ دلار برای ورودی تقریباً همامتیاز برادر بزرگش است. پرچمدار اصلی، Qwen3.8 Max، فقط از راه API در دسترس است. متا هم با Muse Spark Open (۸۱۶ میلیارد کل / ۴۲ میلیارد فعال، منتشرشده در ۲۳ مهر ۱۴۰۵) به رقابت مدلهای باز برگشته است. Step 5 Preview از StepFun هم تازهوارد قدرتمندی است که در رتبهٔ چهارم مدلهای باز ایستاده است.
اندازهٔ کل و فعال، پنجرهٔ زمینه و نوع مجوز مدلهای وزنباز مطرح. منبع تصویر: تحریریه رادینو
فاصلهٔ مدلهای باز و بسته چقدر است؟
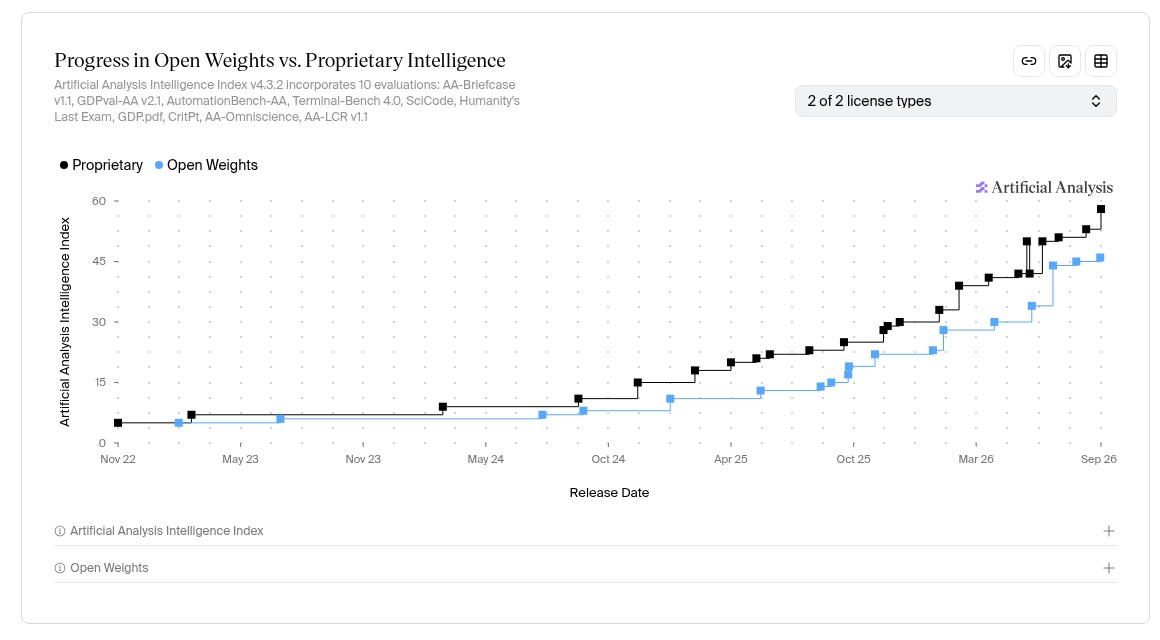
نمودار پیشرفت Artificial Analysis نشان میدهد که از سال ۲۰۲۳ تا امروز، مدلهای وزنباز همیشه پشت مدلهای بسته حرکت کردهاند، اما با فاصلهای نسبتاً ثابت. امروز بهترین مدل بسته (Claude Opus 5.5، با امتیاز ۵۷.۶) حدود ۱۱ امتیاز از بهترین مدل باز (MiMo-V2.6-Pro، با امتیاز ۴۶.۳) جلوتر است. نکتهٔ مهمتر این است که امتیاز ۴۶ امروزِ مدلهای باز، از امتیاز بهترین مدلهای بستهٔ اوایل سال ۲۰۲۶ بیشتر است.
پیشرفت شاخص هوش مدلهای وزنباز (آبی) و اختصاصی (مشکی) در طول زمان. منبع تصویر: Artificial Analysis
مدلهای کوچک و متوسط
مدلهای بالای جدول برای اجرا به سرورهای چند GPU نیاز دارند. اگر میخواهید مدل را روی یک کارت گرافیک، یک Mac قوی یا حتی گوشی اجرا کنید، باید سراغ مدلهای زیر ۴۰ میلیارد پارامتر بروید. Artificial Analysis اینها را در دستهٔ Small (۴ تا ۴۰ میلیارد) و Tiny (زیر ۴ میلیارد) قرار میدهد.
مدل
سازنده
اندازه
شاخص هوش
مجوز
Qwen3.8-27B (Xhigh)
Alibaba
۲۷ میلیارد (Dense)
۳۳.۷
Apache-2.0
Muse Glimmer (High)
Meta
حدود ۳۰ میلیارد
۱۷.۵
Apache-2.0
Gemma 4 26B A4B (Reasoning)
Google
۲۵.۲ میلیارد (حدود ۴ میلیارد فعال)
۱۶.۷
Apache 2.0
Gemma 4 31B (Reasoning)
Google
۳۰.۷ میلیارد
۱۴.۷
Apache 2.0
gpt-oss-120b (High)
OpenAI
۱۲۰ میلیارد (متوسط)
۱۱.۶
Apache-2.0
gpt-oss-20b (High)
OpenAI
۲۰ میلیارد
۹.۰
Apache-2.0
Gemma 4 E4B (Reasoning)
Google
۴.۵ میلیارد مؤثر
۸.۹
Apache 2.0
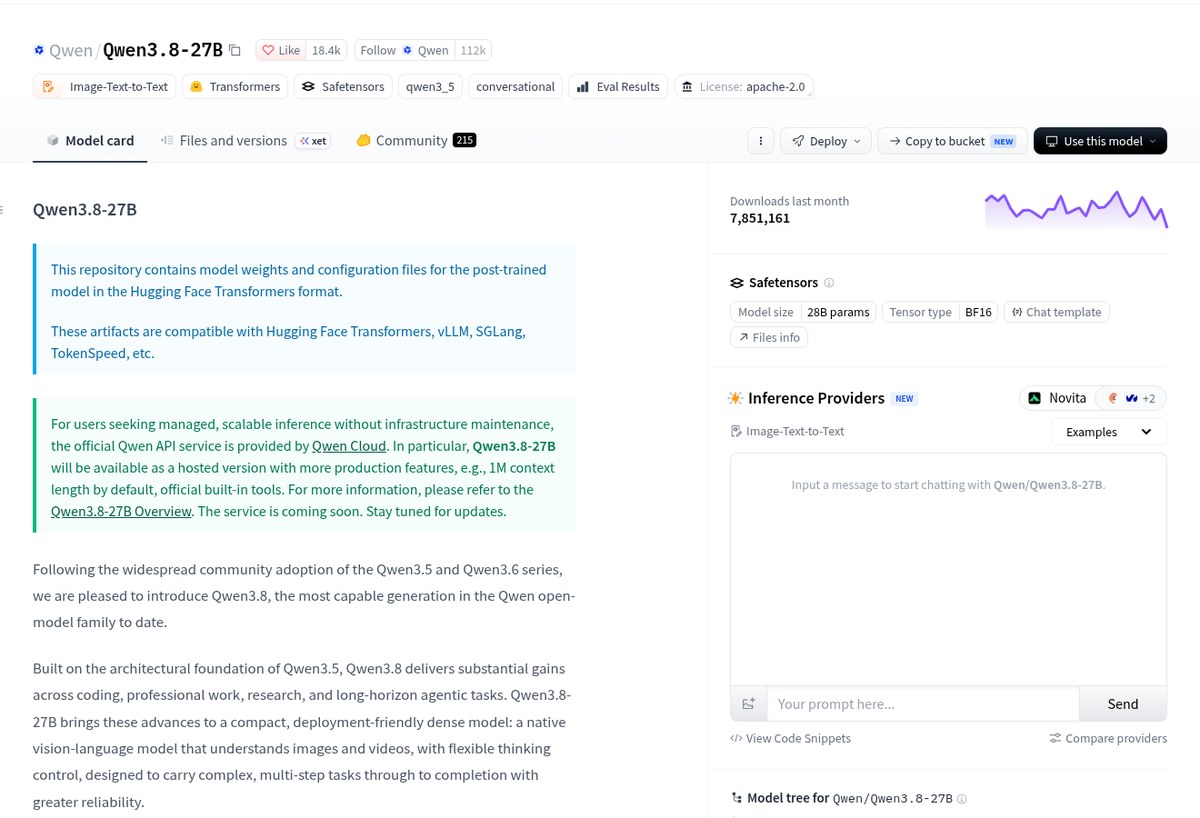
Qwen3.8-27B با فاصلهٔ زیاد بهترین مدل کوچک است. این مدل Dense چندوجهی، متن، تصویر و ویدیو را میفهمد، پنجرهٔ زمینهٔ بومی ۲۶۲,۱۴۴ توکنی دارد (قابل گسترش تا یک میلیون) و حالت تفکرش با پارامتر reasoning_effort قابل تنظیم است. صفحهٔ آن در Hugging Face بیش از ۷.۸ میلیون دانلود در ماه گذشته ثبت کرده است. برای مقایسه، امتیاز ۳۳.۷ آن از Llama 4 Maverick متا (۹.۳) چند برابر بیشتر است.
صفحهٔ مدل Qwen3.8-27B در Hugging Face با مجوز Apache 2.0 (۳ آبان ۱۴۰۵). منبع تصویر: Hugging Face
خانوادهٔ Llama کجاست؟
Llama سالها نماد مدلهای باز بود، اما نسل Llama 4 در شاخص فعلی امتیاز پایینی دارد: ۹.۳ برای Maverick و ۶.۵ برای Scout. البته Scout هنوز طولانیترین پنجرهٔ زمینه، یعنی ۱۰ میلیون توکن، را دارد. متا حالا مدلهای باز جدیدش را با نام Muse عرضه میکند: Muse Spark Open برای سرور و Muse Glimmer برای سختافزار سبکتر. تاریخچهٔ کامل را در همه چیز دربارهٔ هوش مصنوعی Llama آوردهایم.
روی لپتاپ چه چیزی اجرا میشود؟
یک قاعدهٔ سرانگشتی ساده: حافظهٔ لازم برای وزنها تقریباً برابر است با تعداد پارامترها ضرب در تعداد بایت هر وزن. یک مدل ۲۷ میلیاردی با کوانتیزهسازی ۴ بیتی (نیم بایت برای هر وزن) حدود ۱۳ تا ۱۴ گیگابایت فقط برای وزنها لازم دارد. کانتکست طولانی هم حافظهٔ بیشتری میخواهد. پس Qwen3.8-27B یا Gemma 4 31B روی یک کارت گرافیک ۲۴ گیگابایتی یا یک Mac با حافظهٔ یکپارچهٔ زیاد قابل اجراست. مدلهای E2B و E4B گوگل هم برای گوشی و دستگاههای لبه طراحی شدهاند. در طرف دیگر، متا اعلام کرده Muse Spark Open روی دو Mac Studio با تراشهٔ M5 Ultra اجرا میشود، که نشان میدهد مدلهای بزرگ هم کمکم از مراکز داده بیرون میآیند.
مجوزها و استفادهٔ تجاری
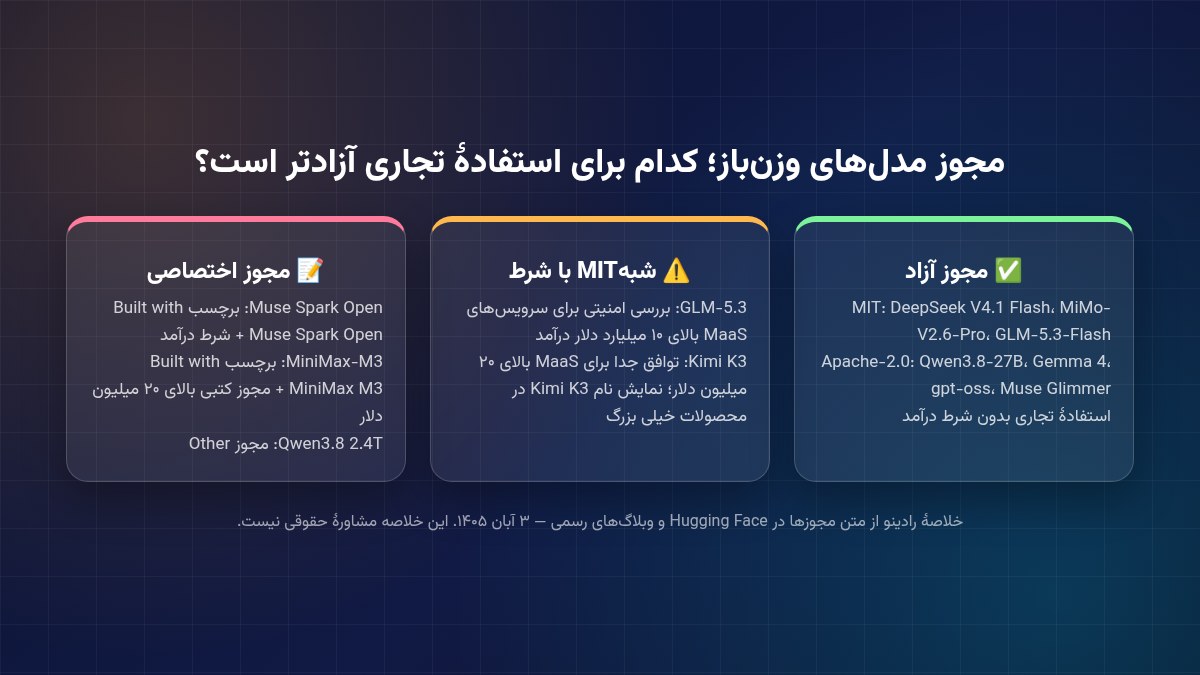
«وزن باز» به معنی «هر کاری خواستید بکنید» نیست. قبل از استفادهٔ تجاری، متن مجوز را بخوانید. مدلهای این فهرست سه دستهٔ کلی دارند:
مدل
مجوز
شرط مهم
DeepSeek V4.1 Flash، MiMo-V2.6-Pro، GLM-5.3-Flash
MIT
تقریباً بدون محدودیت؛ فقط حفظ متن مجوز
Qwen3.8-27B، Gemma 4، gpt-oss، Muse Glimmer
Apache 2.0
بدون محدودیت تجاری؛ حفظ اعلان مجوز و ذکر تغییرات
GLM-5.3
GLM-5.3 License
شبیه MIT؛ سرویسهای مدلبهعنوانسرویس (MaaS) با درآمد بیش از ۱۰ میلیارد دلار در ۱۲ ماه باید بررسی امنیتی Z.ai را بگذرانند
Kimi K3
Kimi K3 License
شبیه MIT؛ سرویس MaaS با درآمد بیش از ۲۰ میلیون دلار به توافق جدا نیاز دارد؛ محصولات با بیش از ۱۰۰ میلیون کاربر ماهانه یا ۲۰ میلیون دلار درآمد ماهانه باید نام Kimi K3 را نمایش دهند
Muse Spark Open
Muse Model License
نمایش عبارت Built with Muse Spark Open؛ سرویس MaaS با درآمد بیش از ۲۰ میلیون دلار باید به متا اطلاع دهد و قرارداد جدا ببندد
MiniMax-M3
MiniMax Community License
نمایش Built with MiniMax M3؛ با درآمد سالانهٔ بیش از ۲۰ میلیون دلار مجوز کتبی لازم است؛ فهرست کاربردهای ممنوع دارد
دستهبندی مجوز مدلهای وزنباز از آزاد تا اختصاصی. منبع تصویر: تحریریه رادینو
⚠️ توجه: این جدول خلاصهٔ ما از متن مجوزها در تاریخ ۳ آبان ۱۴۰۵ است و جای مشاورهٔ حقوقی را نمیگیرد. متن مجوزها ممکن است تغییر کند. برای یک کسبوکار کوچک یا متوسط ایرانی، شرطهای درآمدی این مجوزها معمولاً فعال نمیشوند، اما الزام نمایش نام (مثل Built with …) را جدی بگیرید.
کدام مدل متنباز برای فارسی بهتر است؟
پاسخ صادقانه این است که هنوز بنچمارک معتبر و بهروزی برای مقایسهٔ مدلهای باز در زبان فارسی منتشر نشده است. شاخص هوش Artificial Analysis عمدتاً انگلیسی است و شاخص چندزبانهٔ این سایت هم فارسی را پوشش نمیدهد. پس هر ادعای «بهترین مدل فارسی» را باید با احتیاط خواند. با این حال چند نکتهٔ عملی وجود دارد:
مدلهای بزرگتر معمولاً فارسی بهتری دارند. مدلهای تریلیون پارامتری مثل Kimi K3، MiMo-V2.6-Pro و Qwen3.8 2.4T دادهٔ چندزبانهٔ بیشتری دیدهاند و در متنهای طولانی و تخصصی فارسی کمتر دچار خطای دستوری میشوند.
در مدلهای کوچک، به دادهٔ چندزبانه توجه کنید. گوگل اعلام کرده Gemma 4 روی بیش از ۱۴۰ زبان پیشآموزش دیده و از بیش از ۳۵ زبان بهصورت آماده پشتیبانی میکند. خانوادهٔ Qwen هم سابقهٔ خوبی در زبانهای غیرانگلیسی دارد.
خودتان تست کنید. ۲۰ تا ۳۰ نمونهٔ واقعی از کار خودتان (مثلاً پاسخ به مشتری، خلاصهٔ گزارش یا ترجمه) آماده کنید و خروجی دو یا سه مدل را کنار هم بگذارید. نیمفاصله، اعداد فارسی، اصطلاحات تخصصی و روانی جملهها را بررسی کنید.
Fine-tune را فراموش نکنید. مزیت اصلی مدل باز این است که میتوانید آن را با چند هزار نمونهٔ فارسی باکیفیت برای کار خودتان بهینه کنید.
پیشنهاد ما برای شروع: اگر API میخرید، DeepSeek V4.1 Flash یا MiMo-V2.6-Pro را امتحان کنید که هم ارزاناند و هم مجوز MIT دارند. اگر سختافزار محدود دارید، Qwen3.8-27B و Gemma 4 31B نقطهٔ شروع خوبی هستند.
چطور یک مدل متنباز را امتحان کنیم؟
بدون نصب: در صفحهٔ هر مدل در Hugging Face بخش Inference Providers را ببینید؛ میتوانید همانجا پرامپت بفرستید یا از ارائهدهندهها API بگیرید.
API رسمی سازنده: DeepSeek، Z.ai و Moonshot API سازگار با OpenAI دارند و با تغییر آدرس پایه، کد فعلیتان کار میکند. قیمتها را در راهنمای قیمت API هوش مصنوعی مقایسه کنید.
اجرای محلی: کارت مدل Qwen3.8-27B سازگاری با Transformers، vLLM و SGLang را اعلام کرده است. برای مدلهای کوچک، نسخههای کوانتیزهشدهٔ جامعه هم معمولاً چند روز پس از انتشار در Hugging Face پیدا میشوند.
سؤالات متداول
فرق Open Weights با Open Source چیست؟
در Open Weights فقط وزنهای مدل منتشر میشود و میتوانید آن را دانلود و اجرا کنید. Open Source کامل یعنی دادهٔ آموزشی، کد آموزش و روش ساخت هم منتشر شود. بیشتر مدلهای معروفی که «متنباز» نامیده میشوند، مثل DeepSeek، Qwen و Kimi، در واقع وزنباز هستند.
بهترین مدل متنباز برای فارسی کدام است؟
بنچمارک فارسی معتبری برای مقایسهٔ مدلهای باز وجود ندارد. در عمل، مدلهای بزرگ مثل MiMo-V2.6-Pro، DeepSeek V4.1 Flash و Kimi K3 فارسی بهتری دارند و در میان مدلهای کوچک، Qwen3.8-27B و Gemma 4 گزینههای خوبی هستند. بهترین راه، آزمایش روی نمونههای واقعی کار خودتان است.
میتوانم مدل هوش مصنوعی متنباز را روی لپتاپ اجرا کنم؟
بله، مدلهای کوچک را میتوانید. یک مدل ۲۷ تا ۳۱ میلیارد پارامتری با کوانتیزهسازی ۴ بیتی حدود ۱۴ تا ۱۶ گیگابایت حافظه برای وزنها لازم دارد و روی کارت گرافیک ۲۴ گیگابایتی یا Mac با حافظهٔ زیاد اجرا میشود. مدلهای بزرگ این فهرست به سرور چند GPU نیاز دارند.
آیا میتوانم از مدلهای متنباز استفادهٔ تجاری کنم؟
بیشتر آنها بله. مدلهای با مجوز MIT و Apache 2.0 تقریباً بدون شرط قابل استفادهٔ تجاریاند. مدلهایی مثل Kimi K3، GLM-5.3، Muse Spark Open و MiniMax-M3 مجوز سفارشی دارند که برای شرکتهای خیلی بزرگ یا سرویسدهندههای API شرطهایی مثل توافق جداگانه یا نمایش نام مدل میگذارند.
آیا Kimi K3.1 Pro متنباز است؟
هنوز نه. Kimi K3 با وزن باز منتشر شده است، اما وزنهای Kimi K3.1 Pro تا ۳ آبان ۱۴۰۵ در Hugging Face نیامدهاند. Moonshot AI وعدهٔ انتشار آنها را تا ۱۳ آبان ۱۴۰۵ داده است. تا آن زمان این مدل فقط از راه API در دسترس است.
جمعبندی
مدلهای هوش مصنوعی متنباز در سال ۲۰۲۶ به جایی رسیدهاند که برای بخش بزرگی از کارهای روزمره، از چتبات پشتیبانی تا کدنویسی و تحلیل سند، جایگزین واقعی مدلهای بسته هستند. MiMo-V2.6-Pro و DeepSeek V4.1 Flash با مجوز MIT و قیمت پایین بهترین نسبت کیفیت به هزینه را دارند. GLM-5.3 و Kimi K3 قدرت بیشتری در کارهای سنگین نشان میدهند و Qwen3.8-27B بهترین انتخاب برای اجرا روی سختافزار شخصی است. هنوز حدود ۱۱ امتیاز با بهترین مدل بسته فاصله داریم، اما انتشار احتمالی وزنهای Kimi K3.1 Pro میتواند این فاصله را بهسرعت کم کند. برای انتخاب ارزانترین گزینهها، ارزانترین مدلهای هوش مصنوعی با کیفیت بالا و برای فهم سطوح Low و Max در جدولها، مدلهای استدلالی چیست؟ را بخوانید. اگر میخواهید کار با این ابزارها را اصولی یاد بگیرید، دورهٔ کپسول هوش مصنوعی رادینو را ببینید.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.