هر بار که با چتبات حرف میزنید یا از API یک مدل هوش مصنوعی استفاده میکنید، پشت صحنه یک شمارنده روشن است: شمارندهٔ توکن. قیمت API، حد مجاز طول گفتوگو، سرعت جواب و حتی اینکه مدل وسط کار «یادش برود» اول گفتوگو چه گفتید، همه با توکن اندازه گرفته میشود. اما توکن دقیقاً چیست و چرا یک جملهٔ فارسی معمولاً توکن بیشتری از همان جمله به انگلیسی مصرف میکند؟
در این مقاله توکن را به زبان ساده توضیح میدهیم، انواع آن را (ورودی، خروجی، کش و استدلال) مرور میکنیم و با یک آزمایش واقعی نشان میدهیم متن فارسی چقدر توکن بیشتری میخواهد. در آخر هم یک مثال محاسبهٔ هزینه داریم. اگر دنبال جدول قیمت مدلها هستید، راهنمای قیمت API مدلهای هوش مصنوعی را ببینید.
آخرین بهروزرسانی: ۱۲ آبان ۱۴۰۵ — عددهای مقایسهٔ فارسی و انگلیسی را تحریریه رادینو با کتابخانهٔ رسمی tiktoken (نسخهٔ 0.14) اندازه گرفته و توضیحات انواع توکن از مستندات رسمی OpenAI، گوگل، Anthropic و DeepSeek برداشته شده است.
⚡ پاسخ کوتاه
توکن کوچکترین تکهای است که مدل زبانی متن را با آن میخواند و مینویسد؛ گاهی یک کلمهٔ کامل، گاهی بخشی از کلمه یا یک علامت. هزینهٔ API بر اساس تعداد توکن ورودی و خروجی حساب میشود و توکنهای «فکر کردن» مدلهای استدلالی هم جزو خروجی پول میگیرند. در آزمایش ما با توکنایزر o200k_base (مدلهای جدید OpenAI)، یک پاراگراف فارسی حدود ۱٫۶ برابر نسخهٔ انگلیسیاش توکن داشت و در توکنایزر قدیمیتر cl100k_base این فاصله به حدود ۳٫۶ برابر رسید. پس متن فارسی معمولاً گرانتر تمام میشود و جای بیشتری از پنجرهٔ زمینه میگیرد.
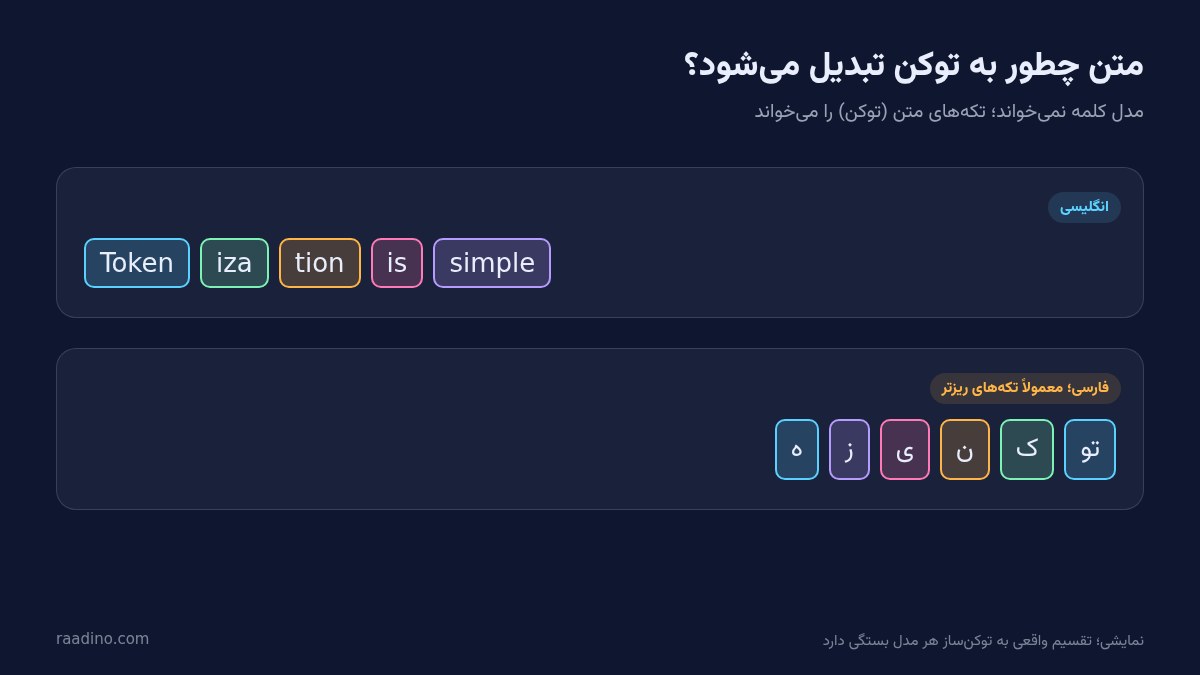
مدلهای زبانی متن را حرفبهحرف یا کلمهبهکلمه نمیخوانند. اول متن را به تکههایی به نام توکن میشکنند و به هر تکه یک شماره میدهند. این کار را ابزاری به نام توکنایزر (tokenizer) انجام میدهد. مجموعهٔ همهٔ تکههایی که مدل میشناسد «واژگان» مدل نام دارد.
مستندات گوگل توکن را اینطور توضیح میدهد: توکن میتواند یک حرف تنها باشد، مثل z، یا یک کلمهٔ کامل، مثل cat. کلمههای بلند به چند توکن شکسته میشوند. گوگل برای مدلهای جمنای تخمین میزند هر توکن حدود ۴ کاراکتر است و ۱۰۰ توکن تقریباً برابر ۶۰ تا ۸۰ کلمهٔ انگلیسی است. DeepSeek هم در مستنداتش میگوید هر کاراکتر انگلیسی تقریباً ۰٫۳ توکن است و تأکید میکند این نسبت از مدلی به مدل دیگر فرق میکند.
برای اینکه حس بهتری بگیرید، چند نمونه را با توکنایزر o200k_base (همان توکنایزری که کتابخانهٔ tiktoken برای خانوادهٔ GPT-4o، GPT-4.1 و GPT-5 به کار میبرد) امتحان کردیم:
متن
تعداد توکن
نحوهٔ شکستن
token
۱
token
intelligence
۲
int | elligence
سلام
۱
سلام
کتاب
۲
کت | اب
توکن
۲
تو | کن
هوش مصنوعی
۴
هو | ش | مصنوع | ی
میبینید که کلمههای پرکاربرد انگلیسی معمولاً یک توکناند، اما خیلی از کلمههای فارسی، حتی کلمههای ساده، به چند تکه شکسته میشوند. دلیلش را پایینتر توضیح میدهیم.
یک جمله چطور به توکن شکسته میشود؛ هر رنگ یک توکن است. منبع تصویر: تحریریه رادینو
انواع توکن: ورودی، خروجی، کش و استدلال
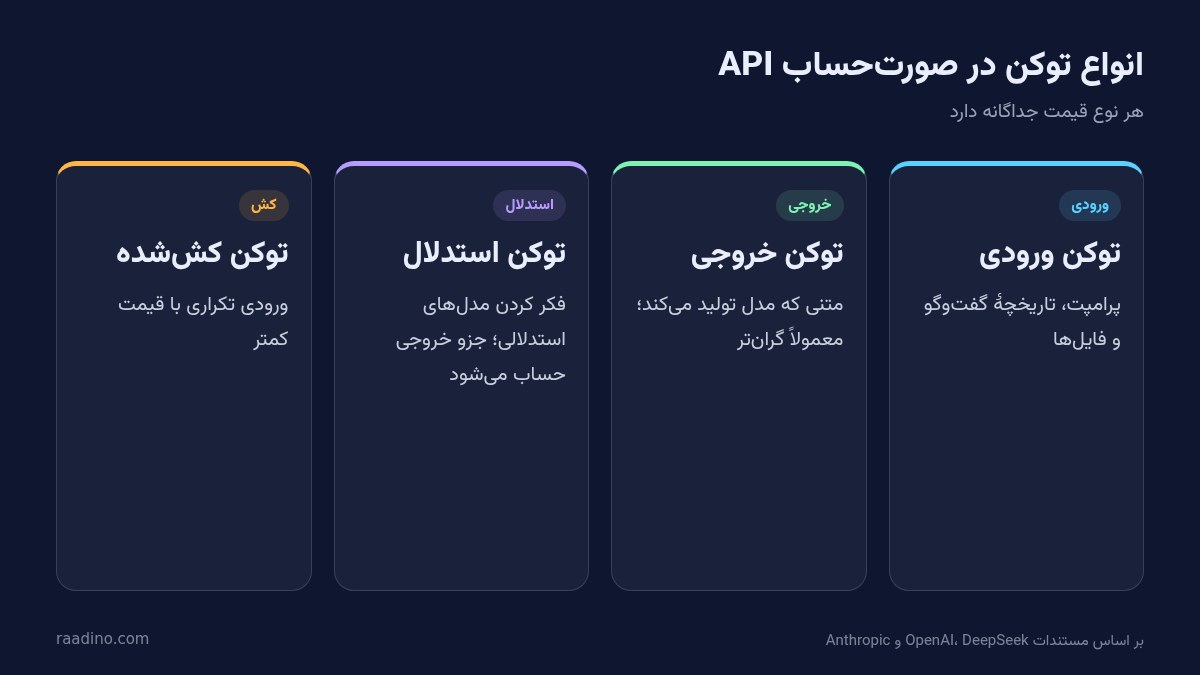
وقتی صورتحساب API را نگاه میکنید، معمولاً با چند نوع توکن روبهرو میشوید که قیمتهای متفاوتی دارند:
توکن ورودی (Input)
همهٔ چیزی که به مدل میفرستید: پیام شما، دستورالعمل سیستمی (system prompt)، تاریخچهٔ گفتوگو، فایلها و حتی تعریف ابزارها. نکتهٔ مهم این است که در هر پیام جدید، معمولاً کل تاریخچهٔ گفتوگو دوباره بهعنوان ورودی فرستاده میشود؛ به همین دلیل گفتوگوهای طولانی بهمرور گرانتر میشوند. تصویر و صدا هم توکن حساب میشوند؛ مثلاً گوگل میگوید در جمنای هر تصویر کوچکتر از ۳۸۴ پیکسل ۲۵۸ توکن حساب میشود و تصاویر بزرگتر به کاشیهای ۷۶۸ در ۷۶۸ پیکسلی تقسیم میشوند که هر کدام ۲۵۸ توکن است.
توکن خروجی (Output)
متنی که مدل تولید میکند. تقریباً همیشه گرانتر از ورودی است. پس جوابهای طولانی و پرحرف مستقیماً هزینه را بالا میبرند.
توکن کش (Cached input)
اگر بخش ابتدایی درخواستهایتان ثابت باشد (مثلاً یک دستورالعمل سیستمی طولانی)، بسیاری از ارائهدهندگان آن را کش میکنند و برای دفعههای بعد قیمت بسیار کمتری میگیرند. مثلاً در جدول قیمت DeepSeek، ورودیِ کششده برای مدل deepseek-flash حدود یکپنجاهم ورودی عادی است.
توکن استدلال (Reasoning)
مدلهای استدلالی قبل از جواب دادن «فکر» میکنند و این فکر کردن هم توکن مصرف میکند. مستندات OpenAI میگوید این توکنها از طریق API دیده نمیشوند، اما در پنجرهٔ زمینه جا میگیرند و بهعنوان توکن خروجی حساب و پرداخت میشوند. OpenAI پیشنهاد میکند در شروع کار دستکم ۲۵ هزار توکن برای استدلال و خروجی کنار بگذارید. گوگل هم در جمنای توکنهای فکر را در شمارش جداگانهای گزارش میکند.
چهار نوع توکنی که در صورتحساب API میبینید. منبع تصویر: تحریریه رادینو
چرا فارسی توکن بیشتری میخواهد؟
توکنایزرها با حجم عظیمی از متن آموزش میبینند و تکههایی را که زیاد تکرار شدهاند بهعنوان یک توکن کامل نگه میدارند. چون بخش بزرگی از متنهای اینترنت انگلیسی است، کلمههای انگلیسی معمولاً یکتکهاند. فارسی سهم کمتری دارد، پس کلمههایش بیشتر به تکههای کوچک شکسته میشوند. نتیجه ساده است: برای یک معنای یکسان، توکن بیشتری خرج میکنید.
آزمایش ما: یک پاراگراف، دو زبان
یک پاراگراف حدوداً ۸۸ کلمهای فارسی و ترجمهٔ انگلیسی تقریباً همطولش را با دو توکنایزر OpenAI شمردیم. نتیجه این بود:
توکنایزر
فارسی
انگلیسی
نسبت فارسی به انگلیسی
o200k_base (مدلهای جدیدتر)
۱۴۵ توکن (۱٫۶۵ توکن برای هر کلمه)
۹۳ توکن (۱٫۰۸ برای هر کلمه)
حدود ۱٫۶ برابر
cl100k_base (GPT-4 و GPT-3.5)
۳۴۲ توکن (۳٫۸۹ برای هر کلمه)
۹۴ توکن (۱٫۰۹ برای هر کلمه)
حدود ۳٫۶ برابر
یک متن بلندتر فارسی (حدود ۱۷۰۰ کلمه از یکی از مقالههای رادینو) هم در o200k_base بهطور میانگین ۱٫۷۳ توکن برای هر کلمه داشت؛ یعنی هر توکن تقریباً ۳ کاراکتر فارسی. همین متن در cl100k_base حدود ۳٫۹۵ توکن برای هر کلمه شد. پس توکنایزرهای جدید برای فارسی خیلی بهتر شدهاند، ولی هنوز به پای انگلیسی نمیرسند.
این عددها مخصوص توکنایزرهای OpenAI است. هر شرکت توکنایزر خودش را دارد و حتی نسلهای مختلف یک شرکت هم فرق میکنند. مثلاً Anthropic میگوید Claude Opus 4.7 و مدلهای بعدی توکنایزر جدیدی دارند که برای همان متن حدود ۳۰ درصد توکن بیشتری از مدلهای قبلی تولید میکند. همیشه با مدلی که واقعاً استفاده میکنید بشمارید.
نیمفاصله و اعداد فارسی
دو جزئیات کوچک هم در آزمایش ما اثر داشتند. «میکند» با نیمفاصله ۲ توکن شد ولی «میکند» چسبیده ۳ توکن. اعداد هم مهماند: «۱۴۰۵» با رقم فارسی ۳ توکن و «1405» با رقم انگلیسی ۲ توکن بود؛ «۱۲۳۴۵۶۷» شش توکن و «1234567» سه توکن. پس اگر متنهای طولانی پر از عدد (مثلاً جدول قیمت یا گزارش مالی) به مدل میدهید و نمایش اعداد برای خواننده مهم نیست، ارقام انگلیسی کمی صرفهجویی میکنند. نیمفاصلهٔ درست هم هم متن را خواناتر میکند و هم ضرری به شمار توکن نمیزند.
مثال محاسبهٔ هزینه
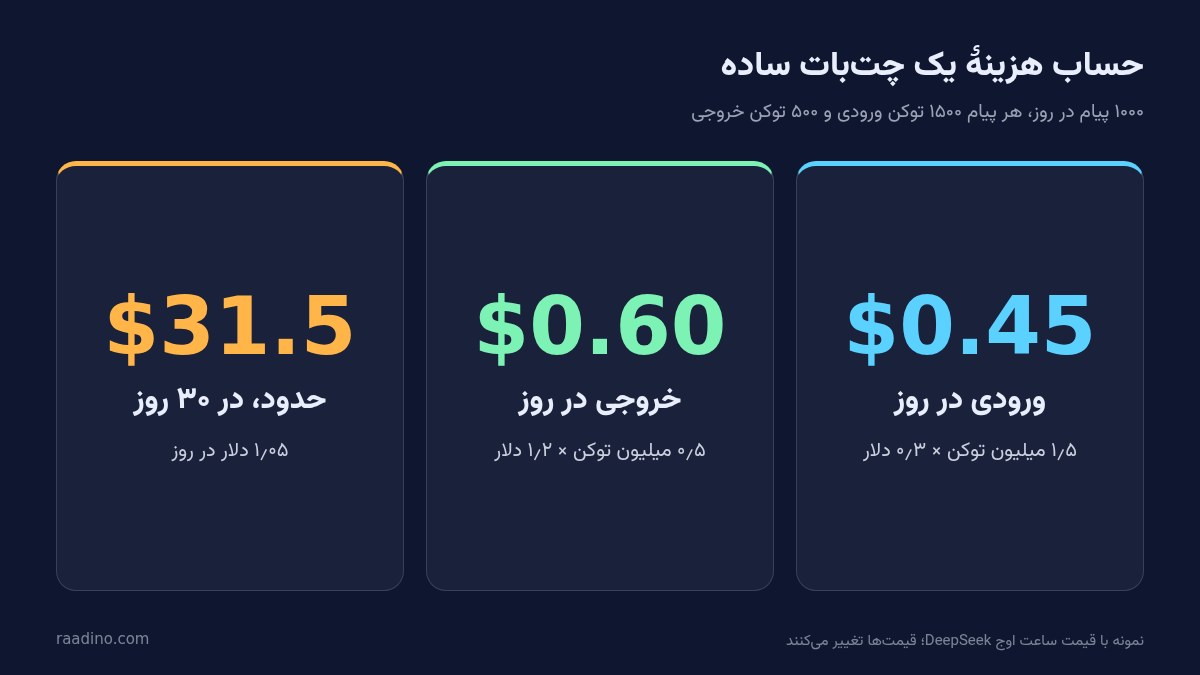
فرض کنید یک چتبات پشتیبانی فارسی دارید که روزی ۱۰۰۰ پیام جواب میدهد. هر درخواست بهطور میانگین ۱۵۰۰ توکن ورودی (دستورالعمل + سؤال + بخشی از تاریخچه) و ۵۰۰ توکن خروجی دارد. با قیمتهای رسمی مدل deepseek-flash در ساعات اوج (هر یک میلیون توکن: ورودی بدون کش ۰٫۳ دلار و خروجی ۱٫۲ دلار) حساب میکنیم:
بخش
محاسبه
هزینهٔ روزانه
ورودی
۱٬۵۰۰٬۰۰۰ توکن × ۰٫۳ دلار ÷ ۱٬۰۰۰٬۰۰۰
۰٫۴۵ دلار
خروجی
۵۰۰٬۰۰۰ توکن × ۱٫۲ دلار ÷ ۱٬۰۰۰٬۰۰۰
۰٫۶۰ دلار
جمع
—
۱٫۰۵ دلار (حدود ۳۱٫۵ دلار در ۳۰ روز)
حالا دو نکته: اول، DeepSeek در ساعات غیراوج نصف این قیمت را میگیرد و اگر دستورالعمل ثابت در کش بنشیند، هزینهٔ ورودی باز هم کمتر میشود. دوم، اگر همین چتبات به انگلیسی کار میکرد، طبق آزمایش ما با توکنایزر مشابه احتمالاً حدود یکسوم توکن کمتری مصرف میکرد (۹۳ در برابر ۱۴۵ توکن در پاراگراف آزمایشی). این عددها فقط برای فهم روش محاسبه است؛ قیمتها مدام تغییر میکنند، پس پیش از تصمیم صفحهٔ قیمت رسمی را ببینید.
روش محاسبهٔ هزینهٔ ماهانهٔ یک چتبات فارسی بر اساس توکن ورودی و خروجی. منبع تصویر: تحریریه رادینو
در مقایسهٔ مدلها هم فقط به قیمت هر میلیون توکن نگاه نکنید. مدلی که ارزانتر است اما جوابهای طولانیتری میدهد یا برای یک کار ساده زیاد «فکر» میکند، ممکن است در عمل گرانتر تمام شود. این موضوع را در ارزانترین مدلهای هوش مصنوعی با جزئیات بررسی کردهایم. سرعت تولید توکن هم معیار مهمی است که در سرعت مدل هوش مصنوعی توضیح دادهایم.
توکن و پنجرهٔ زمینه
هر مدل سقفی برای تعداد توکنی که همزمان میتواند ببیند دارد که به آن پنجرهٔ زمینه (Context Window) میگویند. مثلاً مستندات گوگل میگوید مدلهای Gemini 4 یک پنجرهٔ زمینهٔ مشترک ۱٬۰۴۸٬۵۷۶ توکنی برای ورودی، استدلال و خروجی دارند. چون فارسی توکن بیشتری مصرف میکند، همان پنجره برای متن فارسی «کلمهٔ کمتری» جا میدهد. توضیح کامل این موضوع را در Context Window چیست بخوانید.
ابزارهای شمارش توکن
برای اینکه حدس نزنید، توکنها را بشمارید. این ابزارها رسمی و رایگاناند:
tiktoken: کتابخانهٔ متنباز پایتون از OpenAI که توکنایزرهای مدلهای OpenAI را دارد و آفلاین کار میکند.
Token counting در Claude: Anthropic یک endpoint جداگانه برای شمارش توکن پیش از ارسال دارد که استفاده از آن رایگان است ولی محدودیت تعداد درخواست در دقیقه دارد.
count_tokens در جمنای: گوگل در Gemini API تابعی برای شمارش توکن ورودی پیش از ارسال دارد و بعد از هر درخواست هم تعداد توکنهای ورودی، خروجی، فکر و کش را در بخش usage گزارش میدهد.
DeepSeek: در مستنداتش بستهٔ توکنایزر را برای شمارش آفلاین ارائه میکند و تأکید دارد عدد نهایی همان است که در پاسخ API برمیگردد.
Hugging Face Tokenizers: برای مدلهای متنباز، توکنایزر هر مدل را از Hugging Face بارگیری کنید و دقیق بشمارید.
مثال ساده با tiktoken:
pip install tiktoken

import tiktoken
enc = tiktoken.get_encoding("o200k_base")
text = "توکن در هوش مصنوعی چیست؟"
print(len(enc.encode(text)))
چند راه ساده برای مصرف توکن کمتر
دستورالعمل سیستمی را کوتاه و دقیق بنویسید و بخش ثابت آن را اول بگذارید تا از کش استفاده شود.
تاریخچهٔ گفتوگو را خلاصه کنید یا فقط پیامهای مرتبط را دوباره بفرستید.
از مدل بخواهید کوتاه جواب دهد و برای خروجی سقف (max tokens) بگذارید.
برای کارهای ساده از مدلهای کوچکتر و بدون استدلال سنگین استفاده کنید.
اگر میخواهید کار با مدلهای زبانی و مفاهیمی مثل توکن، پرامپت و API را منظم و از پایه یاد بگیرید، دورهٔ کپسول هوش مصنوعی رادینو نقطهٔ شروع خوبی است.
سؤالات متداول
هر کلمهٔ فارسی تقریباً چند توکن است؟
به توکنایزر بستگی دارد. در آزمایش ما با o200k_base (مدلهای جدید OpenAI) بهطور میانگین حدود ۱٫۷ توکن برای هر کلمهٔ فارسی و با cl100k_base قدیمیتر حدود ۴ توکن. برای مدلهای دیگر خودتان بشمارید.
توکن ورودی و خروجی چه فرقی دارند؟
ورودی همهٔ چیزی است که به مدل میفرستید و خروجی متنی است که مدل تولید میکند. خروجی تقریباً همیشه گرانتر است، پس کوتاه نگه داشتن جوابها بیشترین صرفهجویی را دارد.
توکنهای استدلال (reasoning) هم هزینه دارند؟
بله. طبق مستندات OpenAI این توکنها دیده نمیشوند اما در پنجرهٔ زمینه جا میگیرند و بهعنوان توکن خروجی پرداخت میشوند.
چطور تعداد توکن یک متن را بشماریم؟
برای مدلهای OpenAI از کتابخانهٔ tiktoken، برای Claude از endpoint شمارش توکن Anthropic و برای جمنای از count_tokens استفاده کنید. عدد دقیق نهایی همان است که API در بخش usage برمیگرداند.
نیمفاصله و اعداد فارسی روی تعداد توکن اثر دارند؟
در آزمایش ما بله. «میکند» با نیمفاصله یک توکن کمتر از «میکند» داشت و اعداد با رقم فارسی تقریباً دو برابر رقم انگلیسی توکن گرفتند.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.