اگر با هوش مصنوعی فارسی کار کرده باشید، احتمالاً دیدهاید یک مدل متن روان و طبیعی مینویسد و مدل دیگر جملههایی شبیه ترجمهٔ ماشینی تحویل میدهد؛ یا اصطلاح عامیانه را اشتباه میفهمد. سؤال خیلی از کاربران ایرانی همین است: کدام هوش مصنوعی فارسی را بهتر میفهمد؟
مشکل اینجاست که لیدربوردهای معروف جهانی کیفیت فارسی را جداگانه نمیسنجند. در این مقاله سراغ بنچمارکهایی رفتهایم که مخصوص زبان فارسی ساخته شدهاند، نتیجههایشان را کنار هم گذاشتهایم و برای هر کاربرد پیشنهاد دادهایم. اگر با مفهوم بنچمارک آشنا نیستید، اول راهنمای بنچمارک هوش مصنوعی را بخوانید.
آخرین بهروزرسانی: ۱۴ آبان ۱۴۰۵ — نتیجهها از لیدربوردهای فارسی MIZAN، MRMP Bench و Open Persian LLM Leaderboard در ۱۴ آبان ۱۴۰۵ خوانده شدهاند.
⚡ پاسخ کوتاه
بر اساس تازهترین بنچمارک فارسی که مدلهای نسل جدید را آزموده (MRMP Bench)، Claude Opus 5.5 با امتیاز ۹۸٫۵۹ از ۱۰۰ اول است و GPT-6.1 Sol (۹۴٫۴۲)، Grok 4.7 (۹۴٫۱۳، موقت) و Gemini 3.8 Flash (۹۳٫۰۳) پشت سرش هستند. GPT-6 Luna با ۹۰٫۱۵ امتیاز و هزینهٔ بسیار کم، گزینهٔ اقتصادی خوبی است. در بنچمارک دانشگاهیتر MIZAN که مدلهای نسل قبل را سنجیده، o3 و Gemini 2.5 Pro جلو بودند. بین مدلهای متنباز، خانوادههای Llama، Gemma و Qwen در فارسی بهترند، اما فاصلهشان با مدلهای تجاری برتر هنوز زیاد است. بهترین کار این است که چند مدل برتر را روی متن واقعی خودتان تست کنید.
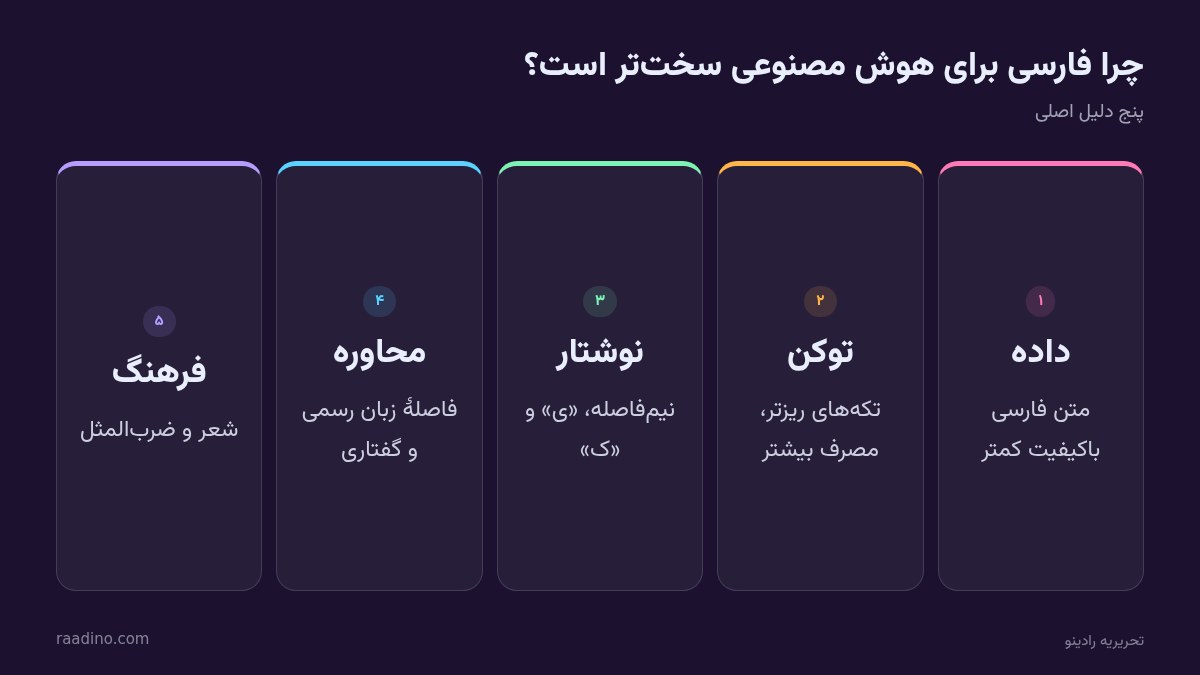
مدلهای زبانی بزرگ با حجم عظیمی از متن آموزش میبینند و بیشتر این متنها انگلیسیاند. فارسی سهم خیلی کمتری در دادهی آموزشی دارد، پس طبیعی است کیفیت مدلها در فارسی پایینتر و متفاوتتر باشد. چند دلیل مشخص دیگر هم هست:
دادهی کمتر و پراکندهتر: متن فارسی باکیفیت و ویراسته در اینترنت نسبت به انگلیسی کم است و بخشی از آن ترجمهٔ ماشینی است.
توکنسازی پرهزینهتر: متن فارسی معمولاً به تکههای ریزتری تقسیم میشود؛ یعنی هر جمله توکن بیشتری مصرف میکند. این موضوع را در توکن در هوش مصنوعی چیست توضیح دادهایم.
نوشتار خاص: نیمفاصله، شکلهای مختلف «ی» و «ک»، اعداد فارسی و جهت راستبهچپ گاهی خروجی را بههم میریزد.
فاصلهٔ زبان رسمی و محاوره: «میخواهم بروم» و «میخوام برم» یک معنی دارند، اما مدلی که فقط متن رسمی دیده، در محاوره ضعیفتر است.
فرهنگ و ادبیات: شعر، ضربالمثل و ارجاعهای فرهنگی ایرانی برای مدلها همچنان سخت است.
یک پژوهش دانشگاهی که پژوهشگرانی از دانشگاه تهران در آن حضور داشتند (منتشرشده در arXiv) مدلهای GPT-3.5، GPT-4 و OpenChat-3.5 را روی وظایف مختلف فارسی آزمود. نتیجهها جالب بود: GPT-4 در مجموع بهتر بود، اما پرامپت انگلیسی معمولاً نتیجهٔ بهتری از پرامپت فارسی میداد و مدلها در وظایف ادبیات فارسی ضعف آشکاری داشتند. این مدلها امروز قدیمی شدهاند، اما الگوی کلی هنوز به کار میآید.
پنج دلیل اصلی که فارسی را برای مدلهای زبانی سختتر از انگلیسی میکند. منبع تصویر: تحریریه رادینو
بنچمارکهای فارسی؛ چه کسانی کیفیت فارسی را میسنجند؟
شاخص چندزبانهٔ Artificial Analysis که یکی از مرجعهای معروف مقایسهٔ مدلهاست، زبان فارسی را در فهرست زبانهایش ندارد. LMArena هم رتبهٔ جداگانهٔ فارسی منتشر نمیکند. خوشبختانه چند تیم ایرانی و مستقل بنچمارک مخصوص فارسی ساختهاند:
MRMP Bench؛ تازهترین مدلها در یک آزمون فارسی
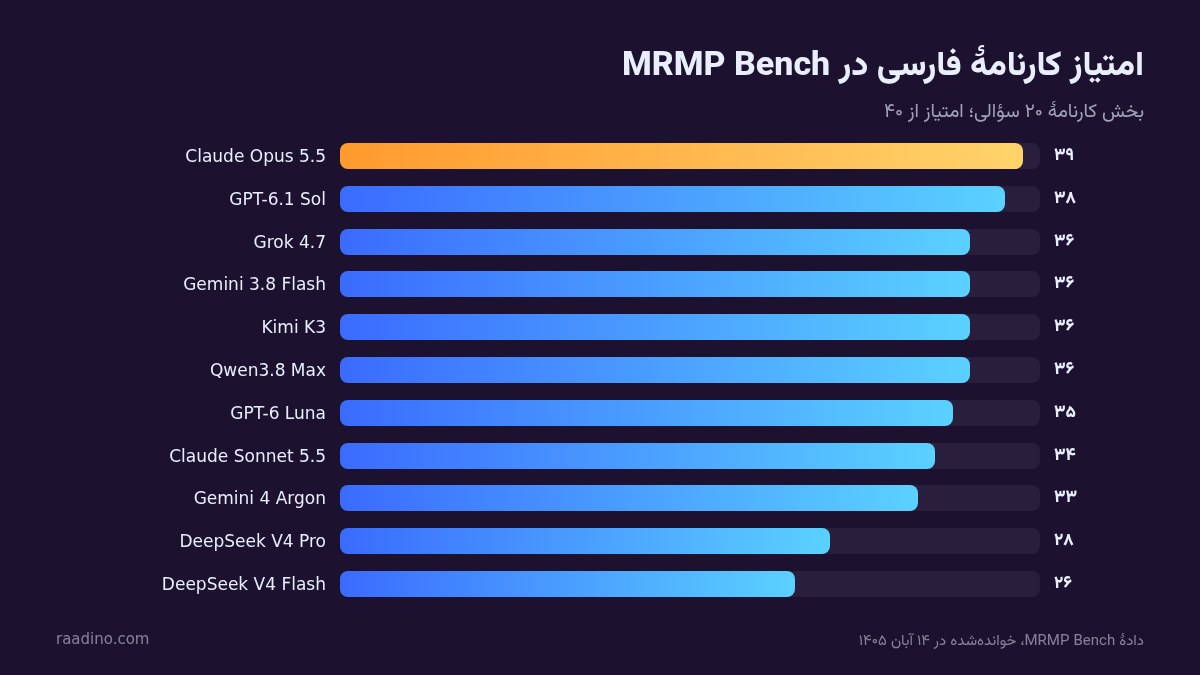
MRMP Bench یک بنچمارک مستقل فارسی است که همهٔ مدلها را با یک آزمون ثابت فارسی میسنجد: یک «کارنامه» ۲۰ سؤالی (۴۰ امتیاز) و ۸ ساخت تعاملی (۶۰ امتیاز)؛ از یک بازی آرکید و ساز سنتور تا تقویم فارسی و برج آزادی سهبعدی. امتیازدهی با کد، یک مرورگر خودکار و هیئت داوری از سه شرکت مختلف انجام میشود. تا امروز ۱۳ مدل در آن منتشر شدهاند:
رتبه
مدل
امتیاز کل (از ۱۰۰)
کارنامه (از ۴۰)
هزینهٔ کل آزمون
۱
Claude Opus 5.5
۹۸٫۵۹
۳۹
۵٫۱۲ دلار
۲
GPT-6.1 Sol
۹۴٫۴۲
۳۸
۱٫۰۱ دلار
۳
Grok 4.7 (موقت)
۹۴٫۱۳
۳۶
۳٫۴۰ دلار
۴
Gemini 3.8 Flash
۹۳٫۰۳
۳۶
۰٫۷۵ دلار
۵
Gemini 4 Argon
۹۰٫۸۵
۳۳
۱٫۳۳ دلار
۶
GPT-6 Luna
۹۰٫۱۵
۳۵
۰٫۰۵۶ دلار
۷
Kimi K3 (موقت)
۸۳٫۰۶
۳۶
۳٫۳۷ دلار
۸
DeepSeek V4 Pro (موقت)
۷۹٫۸۷
۲۸
۰٫۱۷ دلار
۹
Qwen3.8 Max (موقت)
۷۷٫۷۵
۳۶
۳٫۰۳ دلار
۱۰
DeepSeek V4 Flash
۶۸٫۷۸
۲۶
۰٫۰۲۳ دلار
دو نکته برای خواندن درست این جدول: اول اینکه ۶۰ امتیاز از ۱۰۰ به ساختهای تعاملی (یعنی نوشتن کد از روی توضیح فارسی) تعلق دارد؛ پس امتیاز کل ترکیبی از «فهم فارسی» و «توان کدنویسی» است. اگر فقط به فهم و پاسخ فارسی اهمیت میدهید، ستون کارنامه گویاتر است. مثلاً Claude Sonnet 5.5 در کارنامه ۳۴ از ۴۰ گرفته اما امتیاز کلش بهخاطر ساختها ۶۳٫۵۵ است. دوم اینکه مدلهایی که «موقت» نوشته شدهاند فقط یک بار آزمون دادهاند.
امتیاز بخش کارنامهٔ فارسی (از ۴۰) در MRMP Bench برای مدلهای منتخب. منبع تصویر: تحریریه رادینو بر اساس دادهی MRMP Bench
MIZAN؛ بنچمارک جامع فارسی
MIZAN یک لیدربورد فارسی است که از ترکیب دیتاستهای موجود، بنچمارکهای ترجمهشده و دادهی تازهٔ مخصوص فارسی ساخته شده و توانایی مدلها را در فهم، تولید متن، استدلال و دانش مرتبط با زبان و فرهنگ فارسی میسنجد. بخشهایش شامل Persian IFEval (پیروی از دستور)، Persian MT-Bench (گفتوگوی چندمرحلهای)، PerMMLU (دانش عمومی)، PerCoR، Persian NLU (فهم زبان) و Persian NLG (تولید زبان) است.
در جدول کلی MIZAN، مدلهای نسل قبل حضور دارند: o3 با میانگین ۷۴٫۶۸ اول است، بعد Gemini 2.5 Pro (۷۳٫۳۲)، GPT-5 Mini (۷۱٫۶۹) و Claude 3.7 Sonnet (۷۱٫۲۷). بهترین مدلهای باز این جدول GPT-OSS 120B (۶۶٫۳۳)، DeepSeek-R1 (۶۵٫۴۹) و Gemma 3 27B (۶۲٫۴۷) هستند. ارزش MIZAN در دقت و گستردگی بخشهایش است؛ ضعفش اینکه هنوز مدلهای نسل GPT-6، Claude 5 و Gemini 4 را ندارد.
Open Persian LLM Leaderboard و ParsBench
لیدربورد فارسی PartAI روی Hugging Face مدلهای متنباز را با آزمونهای چندگزینهای فارسی (از جمله نسخهٔ فارسی ARC و MMLU Pro) میسنجد. طبق آخرین دادهای که The Aggregate از آن جمع کرده، Llama 3.3 70B با ۷۰٫۳۶ درصد و Gemma 3 27B با ۶۷٫۸۵ درصد جلوترند. ParsBench هم مجموعهابزاری متنباز روی GitHub برای سنجیدن مدلها در وظایف زبان فارسی است که اگر بخواهید مدل خودتان را بسنجید به کار میآید.
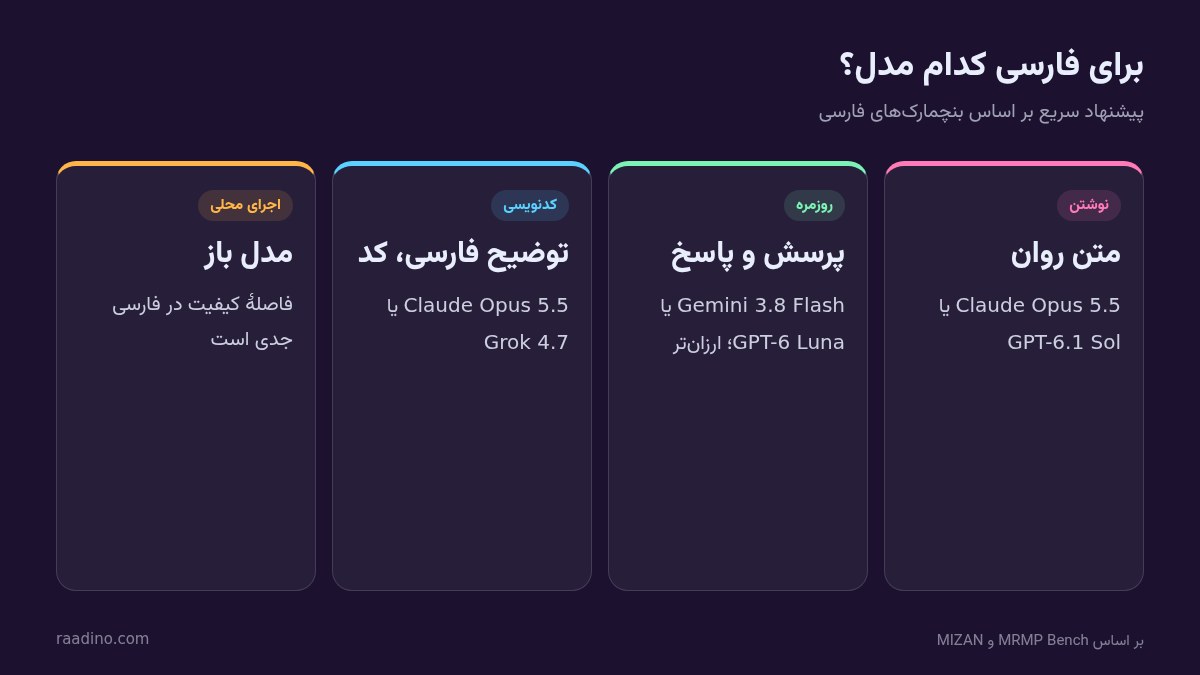
برای مقاله، ایمیل و متن تبلیغاتی، Claude Opus 5.5 در MRMP Bench بالاترین امتیاز کارنامه (۳۹ از ۴۰) را دارد و GPT-6.1 Sol (۳۸) نزدیکش است. در تجربهٔ عمومی کاربران هم Claude به داشتن لحن طبیعیتر شناخته میشود؛ اما این یک قضاوت سلیقهای است و بهتر است خودتان امتحان کنید.
فهم سؤال و جواب دادن به فارسی
برای پرسش و پاسخ روزمره، تفاوت مدلهای برتر کم است. Gemini 3.8 Flash و GPT-6 Luna با هزینهٔ خیلی کمتر، امتیاز کارنامهٔ ۳۶ و ۳۵ گرفتهاند؛ یعنی برای بیشتر کارهای روزمره کافیاند.
کدنویسی با توضیح فارسی
اگر به فارسی توضیح میدهید و کد میخواهید، بخش ساختهای MRMP دقیقاً همین را میسنجد: Claude Opus 5.5 با ۵۹٫۵۹ از ۶۰ و Grok 4.7 با ۵۸٫۱۳ جلوترند. برنامهنویسانی که با انگلیسی راحت نیستند میتوانند از این مزیت استفاده کنند؛ بیشتر دربارهٔ این موضوع در برنامهنویسی بدون زبان انگلیسی نوشتهایم.
خلاصهسازی و کار با متن طولانی
برای خلاصه کردن متنهای طولانی فارسی، علاوه بر کیفیت زبان، اندازهٔ پنجرهٔ متن (Context window) هم مهم است؛ چون متن فارسی توکن بیشتری مصرف میکند. مدلهای تجاری برتر هر سه شرکت پنجرهٔ بزرگی دارند و در این کار به هم نزدیکاند.
مدلهای رایگان و متنباز برای فارسی
اگر میخواهید مدل را روی سرور یا کامپیوتر خودتان اجرا کنید، فاصلهٔ کیفیت در فارسی را جدی بگیرید. در MRMP Bench، DeepSeek V4 Flash با ۶۸٫۷۸ و Qwen3.8 Flash با ۵۴٫۳۴ امتیاز، بهوضوح پایینتر از مدلهای تجاری برترند. در لیدربوردهای قدیمیتر هم خانوادههای Llama، Gemma و Qwen بهترین مدلهای باز در فارسی بودهاند. فهرست بهروز مدلهای باز و پیشنهادهای ما برای فارسی را در بهترین مدلهای هوش مصنوعی متنباز ببینید.
نکتهٔ عملی: اگر مدل کوچکی در فارسی ضعیف است، گاهی نوشتن دستور به انگلیسی و درخواست پاسخ به فارسی نتیجه را بهتر میکند؛ همان چیزی که پژوهش دانشگاهی بالا هم دیده بود.
خودتان تست کنید؛ آزمون ۱۰ دقیقهای
بنچمارکها نقطهٔ شروعاند، اما متن و کاربرد شما مهمتر است. این پنج آزمون را به دو یا سه مدل برتر بدهید و جوابها را کنار هم بگذارید:
نوشتن: «یک متن ۱۵۰ کلمهای صمیمی برای معرفی کافهای در شیراز بنویس.» ببینید متن طبیعی است یا بوی ترجمه میدهد.
محاوره: یک پیام عامیانه با اصطلاح («دمت گرم، فقط یه کم شل گرفتی») بدهید و بخواهید معنیاش را رسمی بنویسد.
نیمفاصله و املا: بخواهید پاراگرافی را ویرایش کند و ببینید نیمفاصله و «ی» و «ک» را درست میگذارد یا نه.
فرهنگ: معنی یک ضربالمثل یا بیت حافظ را بپرسید؛ جای خطای مدلها اینجاست.
متن تخصصی: یک پاراگراف از حوزهٔ کاری خودتان را خلاصه کند.
پرامپت نمونه برای مقایسهٔ مدلها
این متن فارسی را بخوان و سه کار انجام بده:
۱. خلاصهٔ آن را در سه جملهٔ ساده بنویس.
۲. هر غلط املایی یا نیمفاصلهٔ اشتباه را فهرست کن.
۳. یک نسخهٔ محاورهای و صمیمی از آن برای اینستاگرام بنویس.
[متن خودتان]
پیشنهاد سریع انتخاب مدل برای کارهای فارسی، بر اساس بنچمارکهای فارسی. منبع تصویر: تحریریه رادینو
در تازهترین بنچمارک فارسی (MRMP Bench)، Claude Opus 5.5 اول است و GPT-6.1 Sol، Grok 4.7 و Gemini 3.8 Flash بعد از آن قرار دارند. برای کار روزمره، تفاوت مدلهای برتر کم است.
چرا ChatGPT گاهی فارسی را اشتباه مینویسد؟
سهم فارسی در دادهی آموزشی مدلها کم است و نوشتار فارسی (نیمفاصله، راستبهچپ) خاص است. مدلهای رایگانتر و کوچکتر معمولاً خطای بیشتری دارند.
پرامپت را فارسی بنویسم یا انگلیسی؟
مدلهای برتر امروزی با پرامپت فارسی هم خوب کار میکنند. اگر مدلی ضعیف جواب داد، دستور را انگلیسی بنویسید و صریحاً بخواهید پاسخ فارسی باشد.
کدام مدل متنباز فارسی خوبی دارد؟
در لیدربوردهای فارسی، مدلهای بازی مثل GPT-OSS 120B، DeepSeek-R1، Llama 3.3 70B و Gemma 3 27B نتیجههای خوبی گرفتهاند، اما هنوز از مدلهای تجاری برتر عقبترند.
چرا Artificial Analysis رتبهٔ فارسی ندارد؟
شاخص چندزبانهٔ این سایت فقط مجموعهای از زبانها را میسنجد و فارسی در آن نیست. برای فارسی باید سراغ بنچمارکهای تخصصی مثل MIZAN و MRMP Bench رفت.




نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.