اگر تا حالا برای پروژهتان سراغ API یک مدل زبانی رفته باشید، احتمالاً با جدولهایی پر از «دلار به ازای هر میلیون توکن» روبهرو شدهاید که مقایسهشان اصلاً ساده نیست. یک مدل ورودی ارزانی دارد اما خروجیاش گران است، دیگری کش ارزان دارد و سومی در ساعتهای خلوت نصف قیمت حساب میکند. در این راهنما قیمت API هوش مصنوعی را برای مدلهای اصلی ۲۰۲۶ یعنی GPT، Claude، Gemini، Grok و DeepSeek کنار هم میگذاریم، توضیح میدهیم قیمتگذاری توکنی دقیقاً چطور کار میکند، هزینهٔ واقعی هر تسک را حساب میکنیم و ترفندهایی را مرور میکنیم که صورتحساب ماهانهتان را تا نصف یا کمتر پایین میآورند.
آخرین بهروزرسانی: ۲۷ مهر ۱۴۰۵ — همهٔ قیمتها در همین تاریخ از صفحههای رسمی قیمتگذاری OpenAI، Anthropic، Google، xAI و DeepSeek و دادههای هزینهٔ هر تسک از Artificial Analysis برداشته شدهاند. قیمتها به دلار آمریکا و به ازای هر یک میلیون توکن است و ارائهدهندهها ممکن است هر زمان آن را تغییر دهند.
تقریباً همهٔ ارائهدهندههای مدلهای زبانی بزرگ، هزینه را بر اساس توکن حساب میکنند. توکن تکهای از متن است؛ گاهی یک کلمهٔ کامل، گاهی بخشی از یک کلمه و گاهی فقط یک علامت نگارشی. مستندات DeepSeek هم دقیقاً همین تعریف را میدهد: توکن کوچکترین واحد متنی است که مدل میشناسد و صورتحساب بر اساس مجموع توکنهای ورودی و خروجی صادر میشود. برای متن فارسی معمولاً تعداد توکنها از متن انگلیسیِ هماندازه بیشتر است، پس اگر محصولتان فارسی است، در برآورد هزینه کمی دستودلبازتر باشید.
اگر هنوز با خود مفهوم API آشنا نیستید و نمیدانید یک سرویس چطور از طریق API به سرویس دیگری وصل میشود، پیشنهاد میکنم اول مقالهٔ اتصال سرویسهای وبسایت با API را بخوانید و بعد به این جدولها برگردید.
توکن ورودی، توکن خروجی و توکنهای استدلال
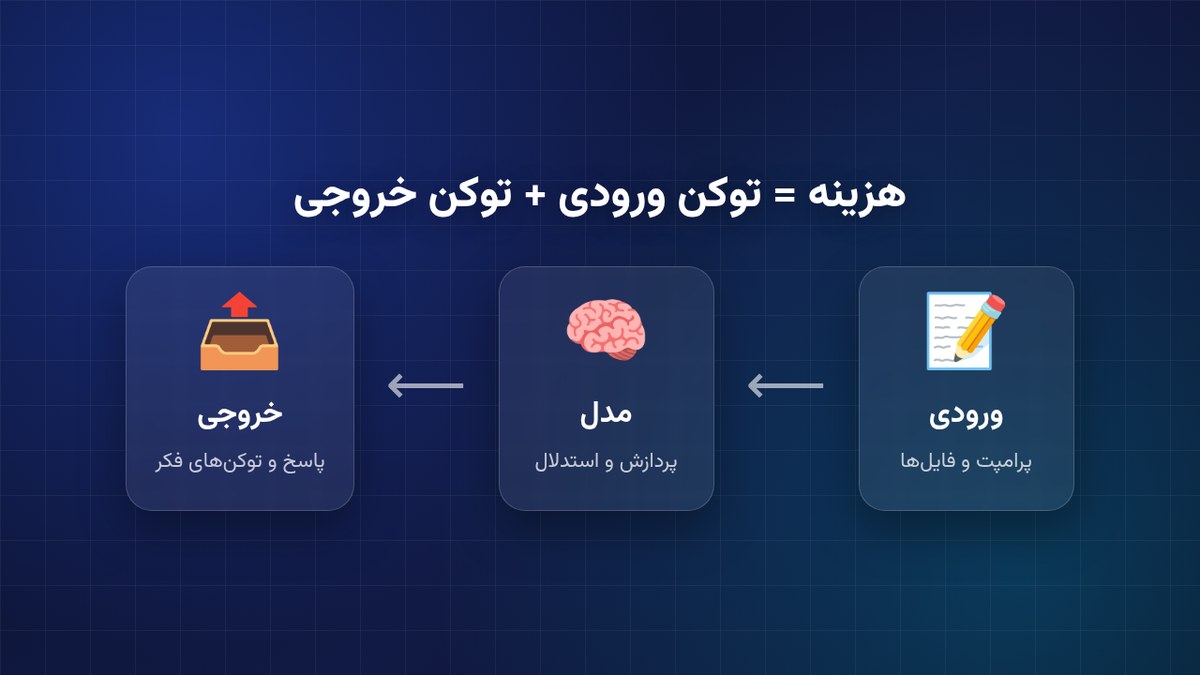
هر درخواست دو بخش هزینه دارد. توکنهای ورودی شامل پرامپت شما، دستورالعمل سیستمی، تاریخچهٔ گفتگو و فایلهایی است که برای مدل میفرستید. توکنهای خروجی همان پاسخی است که مدل تولید میکند. نکتهٔ مهم این است که در مدلهای استدلالی، «فکر کردن» مدل هم معمولاً بهعنوان توکن خروجی حساب میشود؛ یعنی وقتی سطح استدلال را روی high یا max میگذارید، ممکن است مدل قبل از جواب نهایی هزاران توکن فکر تولید کند و همهٔ آنها را بپردازید.
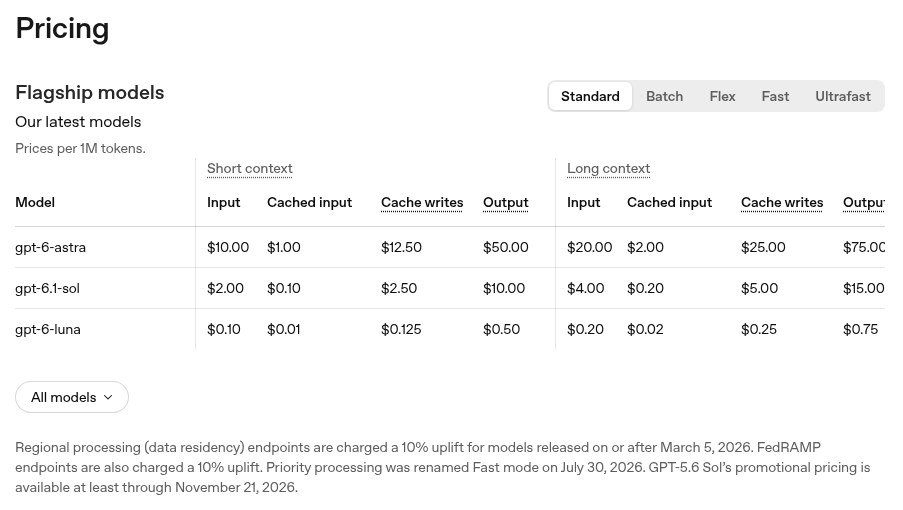
قیمت خروجی تقریباً همیشه چند برابر ورودی است. مثلاً در جدول رسمی OpenAI، مدل gpt-6.1-sol برای ورودی ۲ دلار و برای خروجی ۱۰ دلار به ازای هر میلیون توکن میگیرد، یعنی خروجی پنج برابر گرانتر است. همین نسبت ۱ به ۵ را در Claude Sonnet 5.5 و Gemini 4 Argon هم میبینیم.
هزینهٔ هر درخواست از جمع توکنهای ورودی و خروجی به دست میآید؛ توکنهای استدلال هم جزو خروجی حساب میشوند.
عوامل دیگری که قیمت را تغییر میدهند
قیمت پایه فقط نقطهٔ شروع است. چند عامل دیگر هم روی صورتحساب اثر میگذارند:
کانتکست طولانی: در OpenAI برای ورودیهای بیش از ۲۷۲ هزار توکن، قیمت ورودی تقریباً دو برابر و قیمت خروجی ۱.۵ برابر میشود. xAI هم برای Grok 4.7 بالای ۲۰۰ هزار توکن قیمت بالاتری دارد.
کش پرامپت: اگر بخش ثابتی از پرامپت را بارها تکرار کنید، با کش شدن آن، ورودی تا ده برابر یا بیشتر ارزانتر حساب میشود.
Batch و Flex: کارهایی که فوری نیستند را میشود با نصف قیمت اجرا کرد.
حالت سریع (Fast): OpenAI از ۸ مرداد ۱۴۰۵ (۳۰ ژوئیه ۲۰۲۶) نام Priority را به Fast mode تغییر داد و این حالت دو برابر قیمت عادی است. Anthropic هم برای Opus 5.5 حالت سریع با قیمت ۸ دلار ورودی و ۴۰ دلار خروجی دارد.
محل پردازش داده: OpenAI برای پردازش منطقهای (Data residency) و Anthropic برای استنتاج فقط در آمریکا، حدود ۱۰ درصد به قیمت اضافه میکنند.
ابزارها: جستجوی وب در OpenAI به ازای هر هزار فراخوانی ۱۰ دلار است و Google بعد از ۵ هزار درخواست رایگان ماهانه، برای grounding با جستجو ۱۴ دلار در هر هزار درخواست میگیرد.
جدول قیمت API مدلهای هوش مصنوعی در ۲۰۲۶
در ادامه قیمت مدلهای پرچمدار و اقتصادی هر شرکت را از صفحههای رسمی آوردهایم. همهٔ اعداد برای پردازش استاندارد و کانتکست معمولی است.
OpenAI: قیمت API ChatGPT و مدلهای GPT-6
مدل
ورودی
ورودی کششده
خروجی
کاربرد
gpt-6-astra
$10
$1
$50
قویترین مدل OpenAI برای کارهای سنگین
gpt-6.1-sol
$2
$0.10
$10
مدل همهکارهٔ میانرده
gpt-6-sol
$2
$0.20
$10
نسل قبلی Sol
gpt-6-luna
$0.10
$0.01
$0.50
مدل سبک و بسیار ارزان
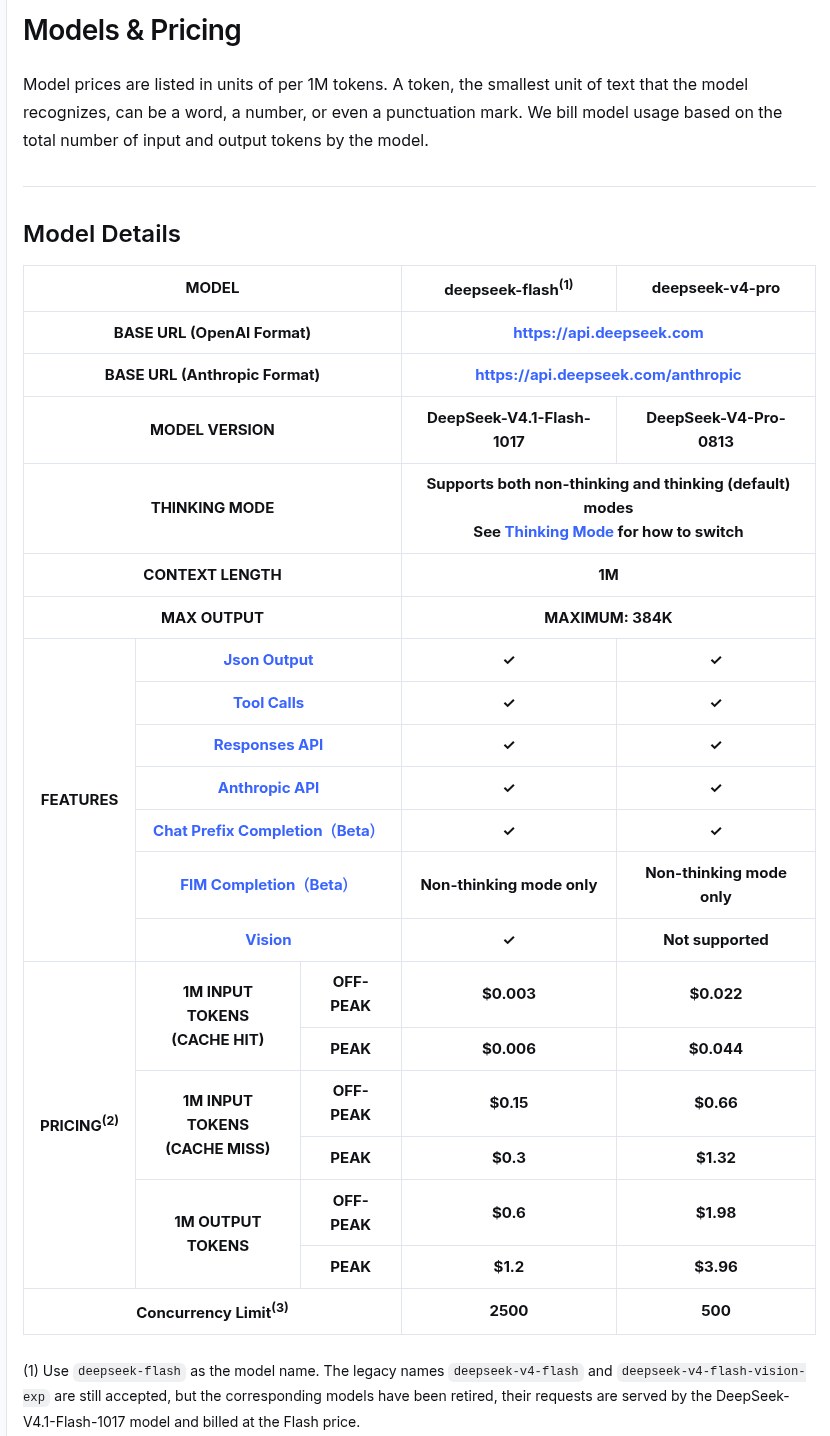
منبع: صفحهٔ قیمتگذاری OpenAI (دریافت: ۲۷ مهر ۱۴۰۵)، قیمت به دلار برای هر یک میلیون توکن در حالت Standard و کانتکست کوتاه.
کسانی که دنبال قیمت API ChatGPT هستند باید بدانند اشتراک ChatGPT Plus و API دو حساب جدا هستند؛ اشتراک ماهانه شامل اعتبار API نمیشود و API کاملاً بر اساس مصرف حساب میشود. در حالت Batch و Flex قیمتها نصف میشوند؛ مثلاً gpt-6-astra در Batch با ۵ دلار ورودی و ۲۵ دلار خروجی محاسبه میشود.
جدول مدلهای پرچمدار در صفحهٔ قیمتگذاری OpenAI؛ ستونهای سمت چپ قیمت کانتکست طولانی را نشان میدهند. منبع تصویر: OpenAI
Anthropic: هزینه API Claude
مدل
ورودی
خروجی
نوشتن کش (۵ دقیقه)
خواندن از کش
Claude Fable 5.1
$10
$50
$12.50
$0.25
Claude Opus 5.5
$4
$20
$5
$0.20
Claude Sonnet 5.5
$2
$10
$2.50
$0.10
Claude Haiku 5.5 (تا ۱۰۰ هزار توکن)
$0.10
$0.50
$0.125
$0.01
Claude Haiku 5.5 (بیش از ۱۰۰ هزار توکن)
$0.50
$2.50
$0.625
$0.05
منبع: مستندات قیمتگذاری Claude Platform (دریافت: ۲۷ مهر ۱۴۰۵).
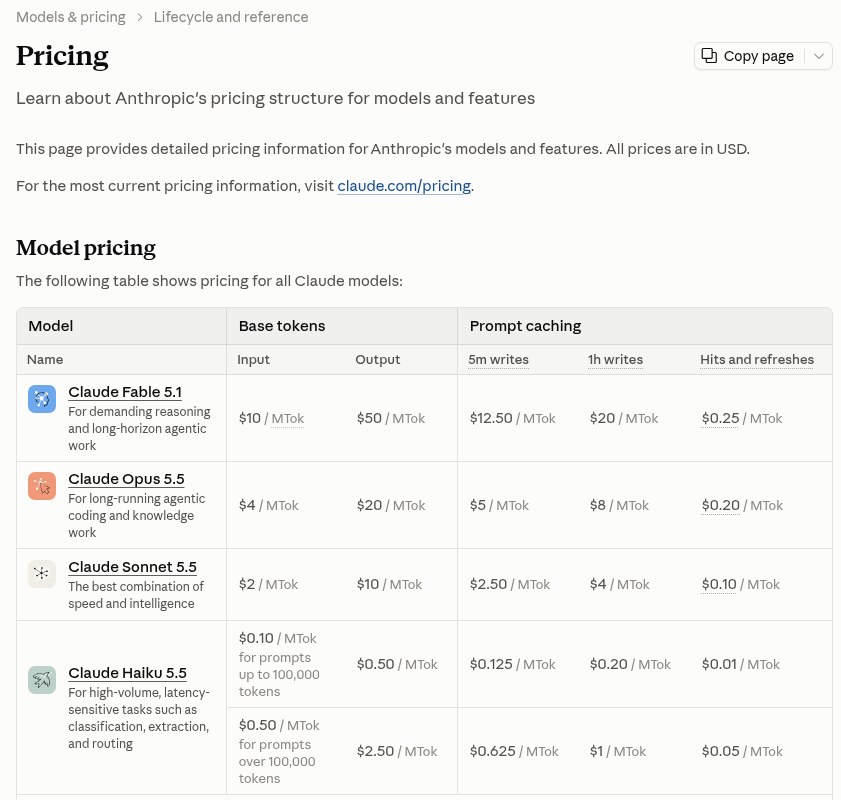
در هزینه API Claude یک نکتهٔ جالب وجود دارد: تخفیف کش در نسل جدید خیلی بیشتر شده است. در حالت عادی خواندن از کش ۰.۱ قیمت پایه است، اما برای Opus 5.5 و Sonnet 5.5 به ۰.۰۵ و برای Fable 5.1 به ۰.۰۲۵ قیمت پایه میرسد. پردازش Batch هم ۵۰ درصد تخفیف دارد. Haiku 5.5 هم قیمت پلهای دارد و اگر پرامپتتان از ۱۰۰ هزار توکن بیشتر شود، قیمتش پنج برابر میشود.
جدول رسمی قیمت مدلهای Claude همراه با هزینهٔ نوشتن و خواندن کش. منبع تصویر: Anthropic
Google، xAI و DeepSeek
مدل
ورودی
خروجی
توضیح
Gemini 4 Argon
$2
$10
تا ۹ آذر ۱۴۰۵؛ از ۱۰ آذر ۴ و ۲۰ دلار. فقط نسخهٔ پولی
Gemini 3.8 Flash
$0.75
$3.75
تا ۱۰ دی ۱۴۰۵؛ بعد از آن ۱.۵ و ۷.۵ دلار. سطح رایگان دارد
Gemini 3.5 Flash-Lite
$0.30
$2.50
سطح رایگان دارد
Grok 4.7
$2
$6
ورودی کششده ۰.۵ دلار؛ کانتکست ۵۰۰ هزار توکن؛ بدون Batch
دو نکته را جدی بگیرید. اول اینکه قیمت فعلی Gemini 4 Argon و Gemini 3.8 Flash تبلیغاتی و موقت است و گوگل تاریخ دو برابر شدنش را اعلام کرده؛ اگر پروژهای بلندمدت میسازید، با قیمت بعدی حساب کنید. دوم اینکه DeepSeek قیمت را بر اساس ساعت تنظیم میکند: ساعتهای اوج ۰۱:۰۰ تا ۰۴:۰۰ و ۰۶:۰۰ تا ۱۰:۰۰ به وقت UTC در روزهای دوشنبه تا جمعه است که به وقت تهران میشود ۴:۳۰ تا ۷:۳۰ و ۹:۳۰ تا ۱۳:۳۰. بقیهٔ ساعتها و آخر هفتهها نصف قیمت حساب میشود.
جدول رسمی DeepSeek که قیمت توکن کششده، کشنشده و خروجی را در ساعت اوج و خلوت جدا نشان میدهد. منبع تصویر: DeepSeek
هزینه هر تسک (Cost per Task)؛ عددی که واقعاً میپردازید
قیمت هر میلیون توکن بهتنهایی گمراهکننده است، چون مدلها برای حل یک مسئلهٔ مشابه تعداد توکن بسیار متفاوتی مصرف میکنند. یک مدل ارزان که برای هر جواب ده برابر بیشتر فکر میکند، ممکن است در نهایت از مدل گرانتر هزینهٔ بیشتری بسازد. به همین دلیل Artificial Analysis شاخصی به نام Cost per Task منتشر میکند که هزینهٔ میانگین اجرای هر تسک در مجموعهآزمونهای شاخص هوش را نشان میدهد.
هزینهٔ واقعی حاصلضرب قیمت توکن در تعداد توکنی است که مدل برای انجام کار مصرف میکند.
مقایسه هزینه مدلها بر اساس دادههای Artificial Analysis
این جدول یک درس مهم دارد: GPT-6.1 Sol در سطح max فقط ۶ امتیاز از Opus 5.5 عقبتر است، اما هزینهٔ هر تسکش حدود یکهشتم است. از آن طرف، Grok 4.7 با اینکه قیمت توکنش پایینتر از Opus است، به دلیل مصرف بالای توکن هزینهٔ هر تسک بالایی دارد. یعنی برای مقایسه هزینه مدلها باید هر دو عدد «هوش» و «هزینهٔ هر تسک» را با هم دید. اگر میخواهید بدانید شاخص هوش چطور ساخته میشود، راهنمای بنچمارکهای هوش مصنوعی را ببینید و برای رتبهبندی کامل، سری به رتبهبندی مدلهای هوش مصنوعی ۲۰۲۶ بزنید.
یک مثال ساده برای محاسبه هزینه
فرض کنید یک چتبات پشتیبانی دارید و هر گفتگو به طور میانگین ۱۰ هزار توکن ورودی و ۲ هزار توکن خروجی مصرف میکند (این فرض ماست، نه دادهای از منابع). با قیمتهای رسمی بالا، هزینهٔ هر گفتگو تقریباً این میشود:
مدل
هزینهٔ هر گفتگو
هزینهٔ ۱۰۰ هزار گفتگو
gpt-6-astra
$0.20
$20,000
Claude Opus 5.5
$0.08
$8,000
gpt-6.1-sol / Claude Sonnet 5.5 / Gemini 4 Argon
$0.04
$4,000
Grok 4.7
$0.032
$3,200
Gemini 3.8 Flash
$0.015
$1,500
deepseek-flash (ساعت اوج)
$0.0054
$540
gpt-6-luna / Claude Haiku 5.5
$0.002
$200
محاسبه: رادینو بر اساس قیمتهای رسمی ۲۷ مهر ۱۴۰۵، بدون کش و بدون توکن استدلال اضافه.
فرمول خیلی ساده است: (توکن ورودی × قیمت ورودی + توکن خروجی × قیمت خروجی) ÷ یک میلیون. در عمل اگر مدل استدلالی باشد، توکنهای فکر را هم به خروجی اضافه کنید؛ این همان جایی است که برآوردها معمولاً اشتباه از آب درمیآیند.
ارزانترین گزینهها برای هر بودجه
«ارزانترین» همیشه به معنی «بهترین برای جیب» نیست؛ مدلی که کار را درست انجام ندهد و مجبور شوید چند بار تکرارش کنید، در نهایت گرانتر تمام میشود. با این حال برای کارهای پرتعداد و ساده، مدلهای سبک انتخاب عاقلانهای هستند:
gpt-6-luna: با ۰.۱ دلار ورودی و ۰.۵ دلار خروجی، و هزینهٔ هر تسک ۰.۰۷ دلار در سطح max، یکی از ارزانترین مدلهای تجاری است. برای دستهبندی، استخراج اطلاعات و خلاصهسازی مناسب است.
Claude Haiku 5.5: همقیمت با Luna برای پرامپتهای زیر ۱۰۰ هزار توکن، اما با شاخص هوش ۴۳ و سرعت ۲۳۲ توکن در ثانیه طبق Artificial Analysis.
deepseek-flash: با کانتکست یک میلیون توکنی و شاخص هوش ۴۵، نسبت کیفیت به قیمت بسیار خوبی دارد؛ مخصوصاً اگر کارهایتان را در ساعتهای خلوت اجرا کنید.
Gemini 3.5 Flash-Lite و Gemini 3.8 Flash: سطح رایگان دارند و برای نمونهسازی و تست بدون هزینه عالیاند.
مدلهای متنباز: مدلهایی مثل MiMo-V2.6-Pro (هزینهٔ هر تسک ۰.۱۳ دلار) یا خانوادهٔ Llama را میشود روی سرور خودتان یا از طریق ارائهدهندههای مختلف اجرا کرد. دربارهٔ مدلهای متا در مقالهٔ همه چیز دربارهٔ هوش مصنوعی Llama بیشتر خواندهاید.
اگر بین چند مدل مرددید، سرویسهای واسط مثل OpenRouter قیمت دهها مدل را در یک صفحه کنار هم نشان میدهند و اجازه میدهند با یک کلید API چند مدل را امتحان کنید. برای اینکه بدانید برای هر کاربرد کدام مدل منطقیتر است، مقالهٔ بهترین هوش مصنوعی برای هر کار را هم ببینید.
ترفندهای کاهش هزینه API: کش، Batch و انتخاب هوشمند مدل
خبر خوب این است که با چند تغییر ساده در معماری، معمولاً میشود هزینه را بهشکل محسوسی پایین آورد.
کش پرامپت و پردازش Batch دو ابزار اصلی برای کم کردن صورتحساب API هستند.
کش پرامپت (Prompt Caching)
اگر پرامپت سیستمی طولانی، مستندات محصول یا یک فایل بزرگ را در هر درخواست تکرار میکنید، کش پرامپت مهمترین ترفند شماست. در OpenAI ورودی کششدهٔ gpt-6.1-sol فقط ۰.۱ دلار است، یعنی یکبیستم ورودی عادی. در Claude Sonnet 5.5 هم خواندن از کش ۰.۱ دلار است، هرچند نوشتن اولیه در کش ۲.۵ دلار (کمی گرانتر از ورودی عادی) هزینه دارد. قاعدهٔ طلایی: بخشهای ثابت پرامپت را اول و بخشهای متغیر را آخر بگذارید تا کش بیشتر به کار بیاید. جزئیات فنی را در راهنمای کش پرامپت OpenAI و مستندات کش Claude ببینید.
پردازش Batch و Flex
کارهایی مثل ترجمهٔ هزاران محصول، برچسبگذاری داده یا تولید توضیحات دستهای نیازی به پاسخ فوری ندارند. Batch API در OpenAI، Batch در Anthropic و Batch/Flex در Gemini همگی حدود ۵۰ درصد تخفیف میدهند. فقط توجه کنید که طبق مستندات xAI، مدل Grok 4.7 فعلاً از Batch API پشتیبانی نمیکند.
مسیریابی بین مدلها و کنترل سطح استدلال
لازم نیست همهٔ درخواستها به گرانترین مدل بروند. یک الگوی رایج این است که یک مدل سبک اول درخواست را دستهبندی کند و فقط سؤالهای سخت به مدل قویتر برسند. سطح استدلال را هم دستکم نگیرید: طبق Artificial Analysis، هزینهٔ هر تسک Opus 5.5 از ۱.۸۲ دلار در سطح high به ۵.۹۸ دلار در سطح max میرسد، در حالی که شاخص هوشش فقط ۴ امتیاز بالا میرود. اگر روی ایجنتها کار میکنید، این موضوع حیاتیتر است، چون هر ایجنت دهها فراخوانی پشت سر هم دارد؛ دربارهٔ ساختار ایجنتها در معرفی ایجنت هوش مصنوعی نوشتهایم و دربارهٔ هزینهٔ ایجنتهای کدنویسی در بهترین هوش مصنوعی برای برنامهنویسی.
چند ترفند کوچک اما مؤثر
طول خروجی را با پارامتر حداکثر توکن محدود کنید و از مدل بخواهید کوتاه و ساختاریافته جواب دهد.
تاریخچهٔ گفتگو را خلاصه کنید به جای اینکه کل گفتگو را در هر پیام دوباره بفرستید.
از کانتکست طولانی فقط وقتی لازم است استفاده کنید؛ عبور از آستانهٔ ۲۷۲ هزار توکن در OpenAI قیمت را بالا میبرد.
برای مصرف بالا، در پنل هر سرویس سقف هزینهٔ ماهانه و هشدار تعریف کنید.
پرداخت API هوش مصنوعی از ایران
برای کاربران ایرانی، چالش اصلی معمولاً قیمت نیست، بلکه پرداخت و دسترسی است. ارائهدهندههای بزرگ آمریکایی خدماتشان را فقط در کشورهای مشخصی ارائه میکنند و ایران در فهرست کشورهای پشتیبانیشدهٔ آنها نیست؛ کارتهای بانکی ایرانی هم در درگاههای بینالمللی کار نمیکنند. پیش از هر اقدامی، شرایط استفادهٔ هر سرویس را بخوانید، چون نقض آن ممکن است به مسدود شدن حساب و از دست رفتن اعتبار باقیمانده منجر شود.
چند مسیر قانونی و کمریسکتر که ارزش بررسی دارند:
مدلهای متنباز روی سرور خودتان: مدلهای با وزن باز را میشود بدون نیاز به پرداخت ارزی روی سرور داخلی اجرا کرد. هزینه اینجا به جای توکن، سختافزار و نگهداری است.
بررسی دقیق واسطها: اگر از سرویسهای واسط یا فروشندهٔ اعتبار استفاده میکنید، شفافیت قیمت، نرخ تبدیل و امکان بازگشت پول را بسنجید و به جای خرید یکجا، با مبلغ کم شروع کنید.
محاسبهٔ کارمزد: هر واسطی معمولاً درصدی روی قیمت رسمی اضافه میکند؛ همین درصد را در جدولهای بالا ضرب کنید تا هزینهٔ واقعیتان را ببینید.
اگر میخواهید یک محصول واقعی روی این APIها بسازید و نگران معماری و هزینهٔ آن هستید، تیم رادینو در طراحی و توسعهٔ وبسایت میتواند کمکتان کند.
سؤالات متداول دربارهٔ قیمت API هوش مصنوعی
ارزانترین API هوش مصنوعی در ۲۰۲۶ کدام است؟
در میان مدلهای تجاری اصلی، gpt-6-luna و Claude Haiku 5.5 (برای پرامپتهای زیر ۱۰۰ هزار توکن) با ۰.۱ دلار ورودی و ۰.۵ دلار خروجی به ازای هر میلیون توکن جزو ارزانترینها هستند. deepseek-flash هم در ساعتهای خلوت با ۰.۱۵ دلار ورودی و ۰.۶ دلار خروجی، کیفیت بالاتری با قیمت پایین ارائه میدهد.
قیمت هر میلیون توکن یعنی چقدر متن؟
بستگی به زبان و توکنایزر مدل دارد. در انگلیسی هر توکن به طور تقریبی کمتر از یک کلمه است و متن فارسی معمولاً توکن بیشتری مصرف میکند. بهترین راه این است که چند نمونهٔ واقعی از متن خودتان را بفرستید و تعداد توکن گزارششده در پاسخ API را ببینید.
آیا اشتراک ChatGPT Plus یا Claude Pro شامل API هم میشود؟
خیر. اشتراکهای ماهانهٔ چت و API دو محصول جدا هستند. API بر اساس مصرف توکن جداگانه صورتحساب میشود و برای استفاده از آن باید در پنل توسعهدهندهٔ هر شرکت حساب و اعتبار جدا داشته باشید.
Cost per Task با قیمت هر توکن چه فرقی دارد؟
قیمت هر توکن فقط تعرفه است، اما Cost per Task هزینهٔ واقعی انجام یک کار را نشان میدهد که به تعداد توکن مصرفی مدل هم بستگی دارد. مدلی که توکن ارزانی دارد اما زیاد فکر میکند، ممکن است هزینهٔ هر تسک بالاتری داشته باشد؛ مثل Grok 4.7 که طبق Artificial Analysis هزینهٔ هر تسکش ۳.۷۴ دلار است.
چطور هزینهٔ API را نصف کنیم؟
برای کارهای غیرفوری از Batch استفاده کنید که در OpenAI، Anthropic و Gemini حدود ۵۰ درصد تخفیف دارد، بخشهای ثابت پرامپت را کش کنید و سطح استدلال را فقط برای کارهای سخت بالا ببرید. در DeepSeek هم اجرای کارها در ساعتهای خلوت قیمت را نصف میکند.
جمعبندی
قیمت API هوش مصنوعی در ۲۰۲۶ دامنهٔ بسیار وسیعی دارد: از ۰.۱ دلار برای هر میلیون توکن ورودی در مدلهای سبک تا ۱۰ دلار در مدلهای پرچمداری مثل gpt-6-astra و Claude Fable 5.1. اما عدد مهمتر، هزینهٔ هر تسک است؛ جایی که مدلی مثل GPT-6.1 Sol با کیفیت نزدیک به بهترینها و هزینهای چند برابر کمتر میدرخشد. پیشنهاد عملی ما این است: با یک مدل میانرده شروع کنید، مصرف واقعی توکن را اندازه بگیرید، کش و Batch را فعال کنید و فقط کارهای سخت را به مدلهای گران بسپارید. برای مقایسهٔ مدلها از نظر کیفیت هم مقالهٔ مقایسهٔ ChatGPT، Claude، Gemini و Copilot را از دست ندهید.
اگر میخواهید استفادهٔ حرفهای از ابزارهای هوش مصنوعی را قدمبهقدم یاد بگیرید، دورهٔ کپسول هوش مصنوعی رادینو برای شما طراحی شده است.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.