شاخص هوش Artificial Analysis یک نمره ترکیبی است که چند آزمون کار دانش، کدنویسی، علم و دانش عمومی را در یک عدد از صفر تا صد خلاصه میکند. در این مقاله نسخه ۵٫۰٫۱ را با ترکیب آزمونها، معنی نمره، رتبه مدلها در ۱۹ آبان ۱۴۰۵ و فرق آن با رأی کاربران در LMArena توضیح میدهیم.
آخرین بهروزرسانی: ۱۹ آبان ۱۴۰۵ — منابع بررسیشده در این روز: صفحه روششناسی شاخص هوش، لیدربورد مدلها، اعلامیه نسخه ۵ در ۲۷ اکتبر ۲۰۲۶، و صفحه روششناسی Progress Index در Artificial Analysis.
⚡ پاسخ کوتاه
نسخه جاری شاخص هوش، نسخه ۵٫۰٫۱ است و از ۹ ارزیابی در چهار دسته هموزن ساخته میشود؛ ۶۰ درصد وزن آن روی آزمونهایی با مجموعه خصوصی است. در ۱۹ آبان ۱۴۰۵، بالاترین نمره نمایشدادهشده در لیدربورد ۶۵ و متعلق به Claude Fable 5.2 در سطح max بود. این نمره را باید همراه سطح تلاش، هزینه و زمان هر تسک خواند و با نسخه قبلی شاخص مقایسه مستقیم نکرد.
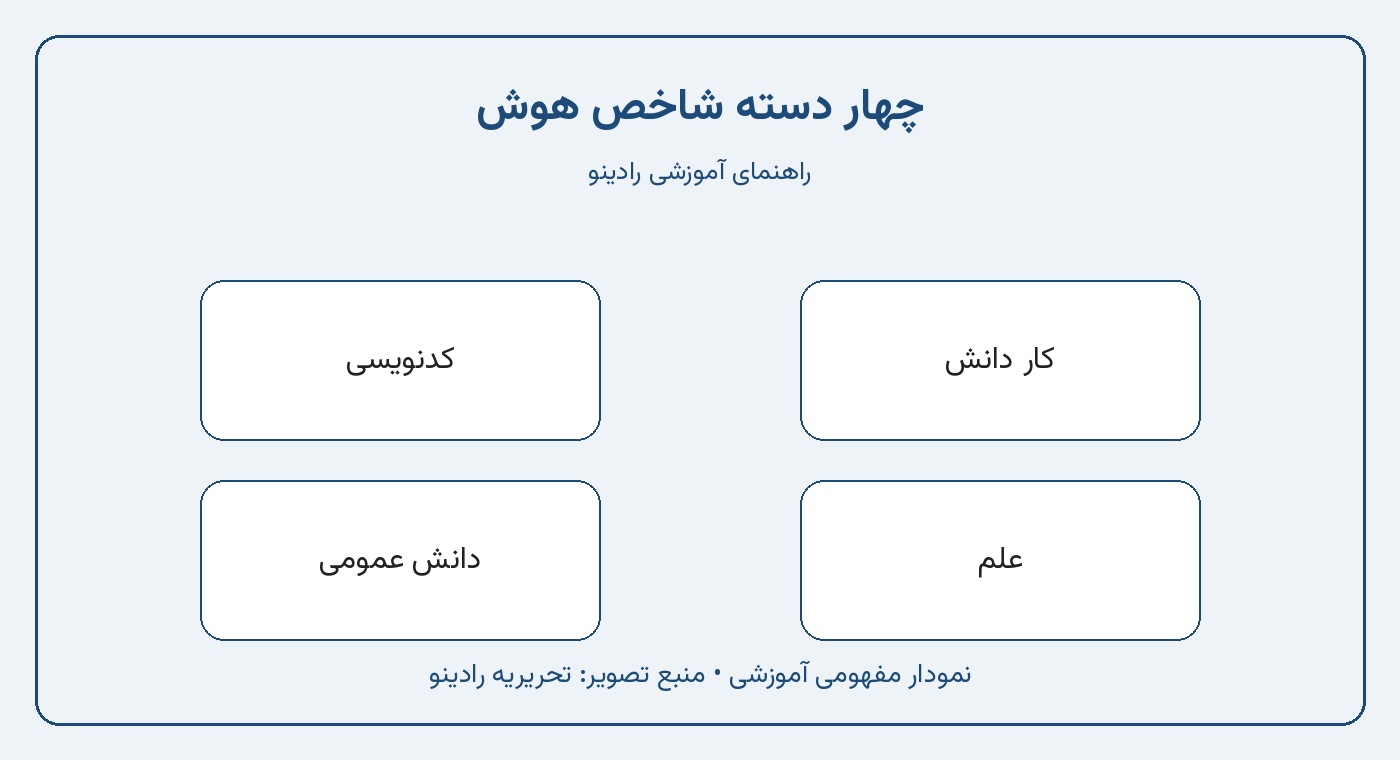
شاخص هوش Artificial Analysis یا Intelligence Index یک نمره ترکیبی است که چند آزمون مختلف را در یک عدد خلاصه میکند تا بتوان مدلهای زبانی را با هم مقایسه کرد. بهجای اینکه فقط بگوییم «این مدل در یک آزمون خوب است»، این شاخص سعی میکند توانایی کلی مدل را در چند نوع کار نشان دهد: کار دانش و اداری، کدنویسی، علم، و دانش عمومی.
طبق صفحه روششناسی Artificial Analysis که در ۱۹ آبان ۱۴۰۵ خواندیم، نسخه جاری این شاخص، نسخه ۵٫۰٫۱ است و از ۹ ارزیابی ساخته میشود. خود سایت میگوید این شاخص یک جمعبندی مفید برای مقایسه مدلهاست، اما مثل هر معیار ارزیابی محدودیت دارد و ممکن است مستقیماً به هر کاربرد شما مربوط نباشد. با این حال، همان صفحه ادعا میکند که این شاخص در حال حاضر جمعبندی مفیدتری از مقایسه مدلها به دست میدهد نسبت به هر معیار تکی دیگر. ما این جمله را بهعنوان نظر خود Artificial Analysis نقل میکنیم، نه بهعنوان حقیقت اثباتشده.
نمره در لیدربورد معمولاً بهصورت عدد صحیح از صفر تا صد دیده میشود. این نمره معدل وزندار چهار دسته است که هر کدام ۲۵ درصد از شاخص را میسازند. بالاتر بودن نمره یعنی مدل در مجموعه همان آزمونها بهتر عمل کرده است؛ بهمعنای «باهوشتر از انسان» یا «بهترین مدل برای کار شما» نیست. در اعلامیه نسخه ۵ در ۲۷ اکتبر ۲۰۲۶، Artificial Analysis نوشته بود که در همه ۹ ارزیابی هنوز جا برای پیشرفت زیاد هست و هیچ مدلی در تمام آزمونها اول نبود.
اگر تازه با مفهوم بنچمارک و لیدربورد آشنا میشوید، بهتر است اول راهنمای بنچمارک هوش مصنوعی را بخوانید. این مقاله فقط روی خود شاخص هوش، ترکیب آزمونها، تفسیر نمره، رتبه امروز و تفاوتش با رأی کاربران تمرکز میکند. آموزش بخشهای مختلف سایت را هم در آموزش Artificial Analysis آوردهایم.
چهار دسته شاخص هوش؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
نسخه ۵٫۰٫۱ و چهار دسته هموزن
شاخص هوش چند بار بازطراحی شده است. نسخه ۴ اوایل سال ۲۰۲۶ معرفی شد و نسخههای ۴٫۱ تا ۴٫۳ ترکیب آزمونها و وزنها را عوض کردند. نسخه ۵ در ۲۷ اکتبر ۲۰۲۶ منتشر شد. طبق اعلامیه رسمی، این بزرگترین ارتقا از زمان نسخه ۴ بود و برای اولین بار بیشتر وزن شاخص، یعنی ۶۰ درصد، روی ارزیابیهایی قرار گرفت که مجموعه سؤال یا جوابهایشان خصوصی است یا جوابها کنار گذاشته شدهاند تا مدلها نتوانند آزمون را از قبل حفظ کنند.
نسخه ۵٫۰٫۱ که امروز در صفحه روششناسی آمده، همان چارچوب نسخه ۵ است با یک اصلاح در نمرهدهی. همان صفحه میگوید Artificial Analysis بهبودهای مربوط به پایداری نمرهدهی را از نویسندگان آزمون CritPt گرفته و همه مدلها را روی CritPt نسخه ۲ دوباره نمره داده است. بنابراین اگر نمره مدلی را از نسخه ۵٫۰ یا از نسخههای ۴٫x با نمره امروز مقایسه کنید، مقایسه مستقیم و دقیقی نیست، چون ترکیب آزمونها یا روش نمره عوض شده است.
چهار دسته نسخه ۵٫۰٫۱ اینها هستند:
دسته (هر کدام ۲۵٪)
آزمون
وزن در کل شاخص
مجموعه خصوصی؟
کار دانش
AA-Briefcase نسخه ۱٫۱
۱۵٪
بله
کار دانش
AutomationBench-AA
۵٪
بله
کار دانش
GDP.pdf
۵٪
خیر
کدنویسی
FrontierCode نسخه ۲٫۰
۱۵٪
بله
کدنویسی
Terminal-Bench نسخه ۴٫۰
۱۰٪
خیر
علم
Terminal-Bench-Science نسخه ۰٫۱
۱۵٪
خیر
علم
CritPt نسخه ۲ (زیرمجموعه سخت)
۱۰٪
بله
دانش عمومی
AA-Omniscience نسخه ۱٫۱ (دقت ۱۰٪ و عدم توهم ۵٪)
۱۵٪
بله
دانش عمومی
HLE-Diamond
۱۰٪
خیر
وزن هر دسته ۲۵ درصد است. داخل هر دسته، آزمونها وزن برابر ندارند. مثلاً در کار دانش، AA-Briefcase بهتنهایی ۱۵ درصد کل شاخص را میسازد و دو آزمون دیگر هر کدام ۵ درصداند. در دانش عمومی هم سهم AA-Omniscience خودش به دو قسمت تقسیم میشود: ۱۰ درصد برای دقت و ۵ درصد برای «یک منهای نرخ توهم». یعنی مدل فقط بهخاطر جواب درست پاداش نمیگیرد؛ اگر جایی که نمیداند با اطمینان جواب غلط بدهد، نمره جداگانهای از دست میدهد.
یک نکته دیگر هم در روششناسی آمده است: این شاخص عمدتاً مجموعهای متنمحور و انگلیسیزبان است. مدلهایی که تصویر هم میگیرند، در بعضی آزمونها مثل سؤالهای تصویری HLE-Diamond و صفحه تصویر GDP.pdf تصویر هم دریافت میکنند. اما استدلال تصویری، ورودی گفتاری و عملکرد چندزبانه جدا از شاخص هوش سنجیده میشوند و در خود این نمره نیستند. فهرست زبانهای شاخص چندزبانه در روز بررسی شامل انگلیسی، چینی، هندی، اسپانیایی، فرانسوی، عربی، بنگالی، پرتغالی، اندونزیایی، ژاپنی، سواحیلی، آلمانی، کرهای، ایتالیایی، یوروبایی و برمهای بود. فارسی در این فهرست نبود. پس نمره بالای شاخص هوش بهمعنای درک بهتر فارسی نیست. برای این موضوع کدام هوش مصنوعی فارسی را بهتر میفهمد را بخوانید.
کار دانش؛ ۱۵ درصد Briefcase و آزمونهای اداری
دسته کار دانش ۲۵ درصد شاخص است و سه آزمون دارد.
AA-Briefcase نسخه ۱٫۱ با وزن ۱۵ درصد، آزمون اختصاصی خود Artificial Analysis برای کار دانش واقعی است و مجموعه خصوصی دارد. طبق روششناسی، ۹۱ تسک در چهار سناریو اجرا میشود. مدل در پروژههای چندهفتهای کار میکند که پر از پرونده منبع است: نامه، صفحهگسترده، پیدیاف، رونوشت گفتوگو و سندهای اداری. خروجی، فایل تحویلی است نه فقط یک جواب کوتاه. نمره از مقایسه زوجی و چکلیست کیفیت تحلیلی و ارائه بهصورت Elo به دست میآید. مدل در جعبه امن و بدون اینترنت کار میکند و تا ۵۰۰ نوبت برای هر تسک فرصت دارد. این آزمون سنگین و «ایجنتی» است؛ یعنی مدل باید ابزار را به کار ببرد، فایل بسازد و کار را تمام کند.
AutomationBench-AA با وزن ۵ درصد، اجرای Artificial Analysis از آزمون AutomationBench شرکت Zapier است. ۶۵۷ تسک دارد، مجموعه آن خصوصی است و مدل باید گردشکار واقعی نرمافزارهای ابری را با ابزارهای REST کامل کند. اگر مدل محدودیتی را بشکند که نباید بشکند، برای آن تسک نمره صفر میگیرد.
GDP.pdf با وزن ۵ درصد، پیادهسازی Artificial Analysis از آزمون Surge AI است و خصوصی نیست. ۱۰۰ تسک در ده حوزه دارد، هر تسک پنج بار تکرار میشود، و مدل باید جواب را بر اساس یک پیدیاف بلند و واقعی بدهد. نمره به روش «همه شرطها باید قبول شود» و با داور مدل زبانی حساب میشود. این آزمون ابزار ندارد.
اگر با کار روی سندهای بلند سر و کار دارید، این دسته از شاخص به کارتان نزدیکتر است تا مثلاً فقط یک آزمون چندگزینهای دانش عمومی.
کدنویسی؛ FrontierCode و Terminal-Bench
دسته کدنویسی هم ۲۵ درصد است و دو آزمون دارد.
FrontierCode نسخه ۲٫۰ با وزن ۱۵ درصد، بنچمارک خصوصی شرکت Cognition است. ۱۳۲ تسک دارد و هر تسک سه بار اجرا میشود. کار مدل این است که در مخزن متنباز واقعی تغییر ایجاد کند. نمره با آزمون خودکار و داور مدل زبانی حساب میشود. اگر هر چک مسدودکننده رد شود، نمره آن تلاش صفر است. هدف اعلامشده این است که ببینند آیا نگهدارنده مخزن حاضر میشود تغییر را ادغام کند یا نه. چون مجموعه خصوصی است، احتمال اینکه مدلها سؤالها را از قبل دیده باشند کمتر است.
Terminal-Bench نسخه ۴٫۰ با وزن ۱۰ درصد خصوصی نیست. ۶۶ تسک دارد، سه بار تکرار میشود، و مدل باید کار را در محیط خط فرمان انجام دهد. نمره قبول یا رد مجموعه آزمون است و به روش pass@1 حساب میشود. این آزمون را پژوهشگران دانشگاه استنفورد، مؤسسه Laude و جامعه متنباز توسعه دادهاند.
پس «نمره کدنویسی» در این شاخص، ترکیبی از تغییر در مخزن واقعی و کار در ترمینال است؛ نه فقط نوشتن یک تابع در گفتوگوی چت. اگر کار اصلی شما ایجنت کدنویسی است، این بخش مفید است، اما باز هم جای مقایسه جداگانه ایجنتها را نمیگیرد. برای آن موضوع بهترین هوش مصنوعی برای برنامهنویسی و مقایسه ایجنتهای کدنویسی را ببینید.
علم؛ پژوهش در ترمینال و فیزیک سخت
دسته علم ۲۵ درصد است.
Terminal-Bench-Science نسخه ۰٫۱ با وزن ۱۵ درصد خصوصی نیست. ۷۰ تسک در پنج حوزه دارد، سه بار تکرار میشود، و مدل باید گردشکار پژوهش علمی را در ترمینال انجام دهد. نمره باز هم قبول یا رد مجموعه آزمون و pass@1 است. این آزمون در نسخه ۵ تازه به شاخص اضافه شد.
CritPt نسخه ۲، زیرمجموعه سخت، با وزن ۱۰ درصد خصوصی است. از ۷۰ مسئله فیزیک سطح پژوهشی، ۴۰ مسئلهای که سختتر ماندهاند انتخاب شدهاند؛ طبق روششناسی، ۳۰ مسئلهای که هفت مدل پیشرو در هر پنج تلاش حل کرده بودند کنار گذاشته شده است. هر مسئله پنج بار تکرار میشود. مدل میتواند در جعبه پایتون کد اجرا کند و نمره از سرور رسمی نمرهدهی و به روش pass@1 میآید.
این دسته برای کسی که مدل را برای مشاوره پزشکی یا کار علمی دقیق میخواهد، فقط یک نشانه اولیه است. آزمونهای پزشکی و تصویری علمی جداگانه گزارش میشوند و در خود شاخص هوش نیستند.
دانش عمومی؛ دقت، توهم و HLE-Diamond
دسته عمومی هم ۲۵ درصد است.
AA-Omniscience نسخه ۱٫۱ با وزن ۱۵ درصد، آزمون دانش و توهم خود Artificial Analysis است و مجموعه آن خصوصی است. ۳۰۰۰ سؤال باز دارد. ۱۰ درصد کل شاخص از دقت میآید و ۵ درصد از «یک منهای نرخ توهم». یعنی مدلی که زیاد حدس غلط میزند، حتی اگر بعضی سؤالها را درست جواب دهد، نمره جداگانهای از دست میدهد. نسخه ۱٫۱ نسبت به نسخه قبل پاکسازی شده: سؤالهای اشباعشده و مجموعه عمومی حذف شده، سؤال جدید اضافه شده، و سؤالهای مبهم یا غلط اصلاح شده است. اگر میخواهید مفهوم توهم و همین آزمون را کاملتر ببینید، توهم هوش مصنوعی را بخوانید.
HLE-Diamond با وزن ۱۰ درصد خصوصی نیست. این نسخه پالایششده و هزارسؤالی از آزمون Humanity's Last Exam است که مرکز ایمنی هوش مصنوعی و Scale AI ساختهاند. ۵۰۰ سؤال استدلالی و ۵۰۰ سؤال دانشی دارد. نمره با یک «بررسیکننده تساوی» مبتنی بر مدل زبانی و به روش pass@1 حساب میشود. در نسخه ۵، این آزمون جای نسخه قبلی Humanity's Last Exam را در شاخص گرفت. نمره بالا در HLE-Diamond یعنی مدل از پس سؤالهای خیلی سخت برآمده است؛ بهمعنای درک بهتر کارهای روزمره یا زبان فارسی نیست.
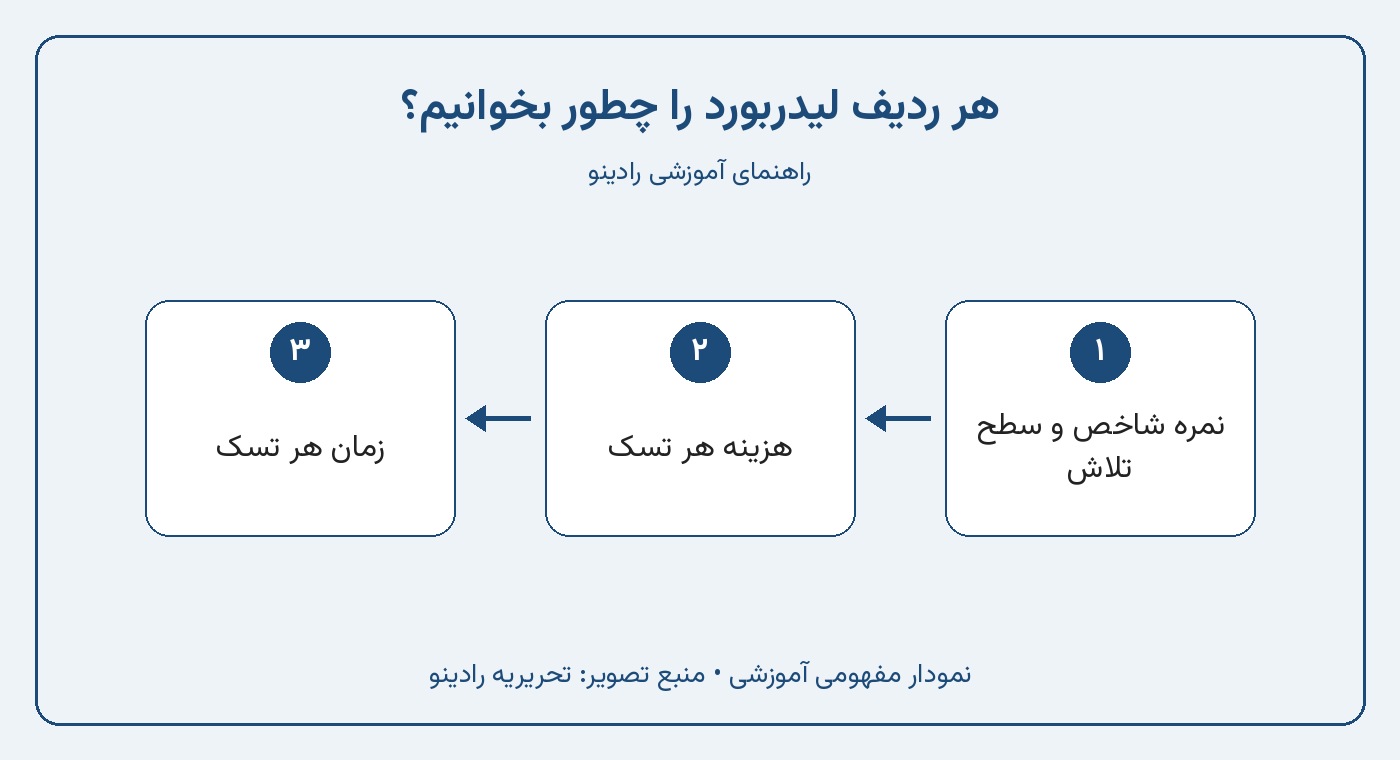
هر ردیف لیدربورد را چطور بخوانیم؟؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
تفسیر نمرهها؛ عدد، سطح تلاش، هزینه و زمان
نمره شاخص را باید با سه عدد دیگر ببینید: سطح تلاش، هزینه هر تسک، و زمان هر تسک.
سطح تلاش یا effort setting میگوید مدل چقدر برای جواب وقت و توکن صرف کند. در لیدربورد، یک مدل ممکن است چند بار با برچسب low، medium، high، xhigh و max بیاید. اینها مدلهای جدا نیستند؛ تنظیمهای مختلف یک مدلاند. بالا بردن سطح تلاش معمولاً نمره را بهتر میکند، اما هزینه و زمان را هم بالا میبرد. در ۱۹ آبان ۱۴۰۵، Claude Opus 5.5 در سطح max نمره ۵۹ و هزینه هر تسک ۱۰٫۰۴ دلار داشت و در سطح low نمره ۳۵ و هزینه ۰٫۹۸ دلار. پس وقتی میگویید «نمره این مدل چند است»، باید سطح تلاش را هم بگویید.
هزینه هر تسک در لیدربورد، برآورد Artificial Analysis از هزینه فراخوانی خود مدل برای یک تسک متوسط مجموعه شاخص است. طبق روششناسی، برای این کار از تعداد توکن اعلامشده توسط ارائهدهنده API استفاده میشود و نرخ برخورد با کش از اندازهگیری زنده به دست میآید، نه فقط از همان یکبار اجرای آزمون. هزینههای منتشرشده فقط فراخوانی مدل شرکتکننده را میپوشاند و هزینه داور، آمادهسازی پیدیاف و نویسهخوانی را ندارد. زمان هر تسک هم از تعداد توکن خروجی و سرعت خروجی برآورد میشود و زمان پایانبهپایان کل ارزیابی نیست. بنابراین این ستونها برای مقایسه مدلها مفیدند، اما صورتحساب دقیق پروژه شما یا مدت انتظار واقعی کاربر نیستند.
نمره ۱۰۰ در صفحه روششناسی بهعنوان سقف مقیاس آمده است، اما در عمل حتی مدلهای صدر جدول خیلی پایینتر از ۱۰۰ بودند. در روز بررسی، بالاترین نمره نمایشدادهشده ۶۵ بود. این با همان حرف اعلامیه نسخه ۵ سازگار است که هنوز جا برای پیشرفت زیاد هست. از طرف دیگر، نمره ۵۵ یا ۵۰ لزوماً «مدل ضعیف» نیست؛ ممکن است برای کار شما کافی و بسیار ارزانتر باشد. روش انتخاب را در چطور مدل هوش مصنوعی مناسب را انتخاب کنیم توضیح دادهایم.
نسخه شاخص را هم روی برگه یادداشت کنید. نمره نسخه ۵٫۰٫۱ را نباید با نمره نسخه ۴٫۳ یا با جدول قدیمیتر یکی گرفت. Artificial Analysis در کنار شاخص هوش، شاخص جداگانهای به نام Progress Index هم معرفی کرده که برای دیدن روند توان مدلها در طول سالهاست. برای انتخاب مدل در کاربرد امروز، خود سایت شاخص هوش را معیار اصلی میداند. ما در این مقاله عددهای Progress Index را بررسی نکردیم.
رتبه فعلی مدلها در ۱۹ آبان ۱۴۰۵
جدول زیر همان اعداد نمایشدادهشده در لیدربورد مدلهای Artificial Analysis در ۱۹ آبان ۱۴۰۵ است. فقط ردیفهای بالای جدول و چند ردیف مرجع برای مقایسه ارزش و مدلهای سبکتر آمدهاند. نمرهها همان اعداد صحیح صفحه رسمیاند. اگر در منبع هزینه یا زمان با خط تیره آمده، اینجا هم خالی گذاشتهایم.
مدل و سطح تلاش
سازنده
نمره شاخص
هزینه هر تسک (دلار)
زمان هر تسک (دقیقه)
Claude Fable 5.2 (max)
Anthropic
۶۵
۲۶٫۵۴
۴۶٫۴
Claude Fable 5.2 (xhigh)
Anthropic
۶۲
۱۴٫۸۳
۲۶٫۴
Claude Fable 5.2 (high)
Anthropic
۶۲
۹٫۰۸
۱۷٫۹
Gemini 4 Carbon (high)
Google
۶۰
۷٫۷۶
۲۶٫۴
Claude Opus 5.5 (max)
Anthropic
۵۹
۱۰٫۰۴
۲۵٫۱
GPT-6 Astra (max)
OpenAI
۵۷
۶٫۲۴
۲۳٫۰
GPT-6.1 Sol (max)
OpenAI
۵۵
۱٫۲۷
۱۹٫۷
Claude Sonnet 5.5 (max)
Anthropic
۵۵
۱۰٫۰۲
۳۱٫۴
GPT-6.1 Terra (max)
OpenAI
۵۱
۰٫۹۶
۱۳٫۶
Gemini 4 Argon (high)
Google
۵۰
۹٫۹۵
۲۹٫۲
Muse Wonder Full (max)
Meta
۵۰
گزارش نشده
گزارش نشده
Kimi K3.1 Pro
Kimi
۴۶
۳٫۶۸
۳۷٫۷
DeepSeek V4.1 Flash 1017 (max)
DeepSeek
۳۳
۰٫۶۰
۱۶٫۶
GLM-5.3 (max)
Z AI
۳۲
۵٫۰۱
۲۹٫۶
Claude Haiku 5.5 (max)
Anthropic
۳۶
۰٫۴۱
۱۴٫۸
Grok 4.7 (xhigh)
SpaceXAI
۳۵
۷٫۷۷
۲۵٫۹
GPT-6 Luna (max)
OpenAI
۲۸
۰٫۱۵
۱۲٫۳
GPT-6 Luna (low)
OpenAI
۱۰
۰٫۰۱
۰٫۶
در صدر جدول، Claude Fable 5.2 در سطح max با نمره ۶۵ قرار داشت. همین مدل در سطح xhigh و high هر دو نمره ۶۲ داشت، اما هزینه و زمانش کمتر بود: ۱۴٫۸۳ دلار و ۲۶٫۴ دقیقه در xhigh، و ۹٫۰۸ دلار و ۱۷٫۹ دقیقه در high. یعنی حتی داخل یک مدل، سطح تلاش میتواند هزینه را چند برابر کند و نمره را فقط چند واحد جابهجا کند.
بعد از آن، Gemini 4 Carbon در سطح high با نمره ۶۰ و هزینه ۷٫۷۶ دلار بود. Claude Opus 5.5 در سطح max نمره ۵۹ و هزینه ۱۰٫۰۴ دلار داشت. GPT-6 Astra در سطح max نمره ۵۷ و هزینه ۶٫۲۴ دلار داشت. فاصله نمره این چند مدل کم است؛ فاصله هزینه و زمان بیشتر به چشم میآید.
اگر نسبت نمره به هزینه برایتان مهم است، ردیفهای میانی جدول در همین روز قابلتوجهاند. GPT-6.1 Sol در سطح max نمره ۵۵ و هزینه ۱٫۲۷ دلار داشت. GPT-6.1 Terra در سطح max نمره ۵۱ و هزینه ۰٫۹۶ دلار داشت. Claude Sonnet 5.5 در سطح max هم نمره ۵۵ داشت، اما هزینه هر تسک آن ۱۰٫۰۲ دلار گزارش شده بود؛ یعنی نمرهای نزدیک به Sol با هزینهای نزدیک به مدلهای گرانتر.
در میان مدلهایی که در لیدربورد بهعنوان متنباز علامت خورده بودند، بالاترین نمره مربوط به Kimi K3.1 Pro با ۴۶ بود و هزینه هر تسک آن ۳٫۶۸ دلار گزارش شده بود. DeepSeek V4.1 Flash 1017 در سطح max نمره ۳۳ و هزینه ۰٫۶۰ دلار داشت و GLM-5.3 در سطح max نمره ۳۲ و هزینه ۵٫۰۱ دلار داشت. وضعیت انتشار وزن هر مدل را از صفحه سازنده چک کنید؛ ما فقط همان نمره و برچسب لیدربورد را نقل میکنیم. مقایسه وسیعتر را در بهترین مدلهای هوش مصنوعی متنباز ببینید.
مدلهای سبکتر هم جای خود را دارند. Claude Haiku 5.5 در سطح max نمره ۳۶ و هزینه ۰٫۴۱ دلار داشت. GPT-6 Luna در سطح max نمره ۲۸ و هزینه ۰٫۱۵ دلار، و در سطح low نمره ۱۰، هزینه ۰٫۰۱ دلار و زمان ۰٫۶ دقیقه داشت. این ردیفها برای کار پرتعداد و کمحساس معمولاً منطقیتر از صدر جدولاند.
چند مدل دیگر در میانه جدول همان روز نمره داشتند که برای کامل بودن تصویر مفید است، هرچند در صدر نبودند: Muse Wonder Full در سطح max نمره ۵۰ داشت اما هزینه و زمانش گزارش نشده بود؛ Grok 4.7 در سطح xhigh نمره ۳۵ و هزینه ۷٫۷۷ دلار داشت. اینها را نباید «حذفشده» فرض کرد؛ فقط در این نسخه از شاخص، پشت سر مدلهای بالاتر بودند.
رتبهبندی کاملتر ماهانه را در رتبهبندی مدلهای هوش مصنوعی میبینید. به خاطر داشته باشید که صدر جدول ممکن است ظرف چند روز عوض شود.
تفاوت شاخص هوش با LMArena چیست؟
LMArena یا همان آرنای مدلهای زبانی، روش کاملاً متفاوتی دارد. آنجا دو مدل به یک کاربر جواب میدهند و کاربر بدون اینکه اسم مدل را بداند، یکی را بهتر میداند. از همین رأیها امتیاز Elo ساخته میشود. شاخص هوش اما آزمون ثابت و تکرارپذیر است: سؤالها مشخصاند، شرایط اجرا یکسان است، و نمره از صحت کار یا داوری ساختاریافته به دست میآید، نه از پسندیدن متن توسط کاربر.
هر کدام چیزی را نشان میدهند که آن یکی نمیتواند. شاخص هوش برای مقایسه منظم و نسبتاً کنترلشده مناسب است و ستون هزینه و زمان هم کنارش دارد. محدودیتاش این است که آزمونها عمدتاً انگلیسی و متنمحورند، بخشی از سؤالها خصوصی است و ممکن است با سلیقه یا کار روزمره شما یکی نباشد. LMArena به حس واقعی کاربر نزدیکتر است، اما رأیها تحت تأثیر سبک نوشتن، سرعت جواب، موضوعهای محبوب و سوگیریهای انسانی قرار میگیرند و هزینه اجرا را نشان نمیدهند.
اگر دو منبع با هم یکی نبودند، لازم نیست یکی را «غلط» بدانید. ممکن است مدلی در آزمونهای سخت علمی بالاتر باشد و مدلی دیگر در گفتوگوی آزاد محبوبتر. برای انتخاب، هر دو را ببینید و بعد روی کار خودتان آزمون کنید. جدول قدیمیتر مقایسه مدلها را هم در مقایسه ChatGPT، Claude، Gemini و Copilot میتوانید بخوانید، با این یادآوری که آن مقایسه از جنس محصول است نه از جنس همین شاخص.
اول، تعمیم. خود Artificial Analysis میگوید این شاخص ممکن است مستقیماً به هر کاربرد مربوط نباشد. اگر کار شما تصویر، صدا، گفتار، یا زبان فارسی است، نمره شاخص هوش را بیش از حد جدی نگیرید و آزمون مناسب همان حوزه را ببینید.
دوم، زبان و قالب. مجموعه عمدتاً انگلیسی و متنمحور است. حتی شاخص چندزبانه همان سایت، در روز بررسی فارسی را در فهرست زبانها نداشت.
سوم، خصوصی بودن ۶۰ درصد وزن. این کار احتمال نشت سؤال و حفظ شدن آزمون را کم میکند و مدلها را سختتر محک میزند. در عوض، بازتولید مستقل همان نمره برای دیگران سختتر است، چون به همه سؤالها دسترسی عمومی ندارند. این یک بدهبستان است، نه تقلب؛ فقط باید در تفسیر لحاظ شود.
چهارم، مقایسه بین نسخهها. با عوض شدن آزمونها و وزنها، نمره امروز با نمره سه ماه قبل روی یک مقیاس نیست. وقتی مقالهای میگوید «نمره این مدل ۵۸ بود»، بپرسید در کدام نسخه شاخص.
پنجم، سطح تلاش و هزینه. گزارش کردن نمره بدون سطح تلاش، گمراهکننده است. مدل صدر جدول در سطح max ممکن است برای محصول شما بیش از حد گران و کند باشد.
ششم، تعریف زمان و هزینه. این عددها برآورد مصرف مدل در خود آزموناند، نه صورتحساب اشتراک و نه زمان انتظار کاربر در رابط چت.
هفتم، یک نمره، چند توانایی. معدل چهار دسته ممکن است ضعف مدل در یک حوزه را پشت قوت در حوزه دیگر پنهان کند. اگر فقط کدنویسی برایتان مهم است، نمره همان دسته یا بنچمارک کدنویسی را جدا ببینید، نه فقط عدد کل.
هشتم، بهروز شدن سریع جدول. مدل جدید یا اصلاح نمرهدهی میتواند ترتیب صدر را عوض کند. عدد این مقاله مربوط به ۱۹ آبان ۱۴۰۵ است.
سؤالات متداول درباره شاخص هوش
نمره شاخص هوش از ۱۰۰ یعنی چه؟
نمره، معدل وزندار چهار دسته آزمون در نسخه جاری شاخص است و در لیدربورد معمولاً به صورت عدد صحیح دیده میشود. صد سقف مقیاس است. در روز بررسی، بالاترین نمره نمایشدادهشده ۶۵ بود. نمره بالاتر یعنی عملکرد بهتر در همان مجموعه آزمون، نه برتری مطلق در هر کاری.
الان کدام مدل بالاترین نمره را دارد؟
در ۱۹ آبان ۱۴۰۵، Claude Fable 5.2 در سطح max با نمره ۶۵ در صدر لیدربورد بود. رتبه ممکن است عوض شود؛ همان صفحه را دوباره ببینید.
چرا یک مدل چند نمره مختلف دارد؟
چون با سطح تلاش مختلف سنجیده شده است. سطح بالاتر معمولاً نمره بهتر و هزینه و زمان بیشتر میدهد.
آیا این شاخص برای انتخاب مدل کافی است؟
برای غربال اولیه بله؛ برای تصمیم نهایی نه. هزینه، سرعت، زبان، دسترسی، و نتیجه آزمون روی کار خودتان را هم باید ببینید. روش عملی را در راهنمای انتخاب مدل نوشتهایم.
فرق این شاخص با بنچمارکهایی مثل MMLU چیست؟
MMLU و آزمونهای مشابه معمولاً یک توانایی را میسنجند. شاخص هوش چند آزمون را با وزن مشخص در یک عدد جمع میکند. بعضی آزمونهای معروف قدیمیتر، مثل GPQA، در نسخه ۵٫۰٫۱ داخل خود این شاخص نیستند و جداگانه گزارش میشوند.
چرا نمره مدل متنباز از صدر جدول فاصله دارد؟
در روز بررسی، بالاترین نمره بین مدلهای علامتخورده بهعنوان متنباز در این لیدربورد ۴۶ بود، در حالی که صدر جدول ۶۵ بود. این فاصله را فقط برای همین نسخه شاخص و همین روز میشود گفت. علت دقیق را از روی یک جدول نمیشود با قطعیت نوشت و ما حدس نمیزنیم.




نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.