حتماً برایتان پیش آمده که وسط یک گفتوگوی طولانی با ChatGPT یا Claude، مدل چیزی را که چند پیام قبل گفته بودید «فراموش» کند؛ یا فایل PDF بزرگی را بفرستید و پیغام بگیرید که فایل بیش از حد طولانی است. دلیل هر دو یک مفهوم ساده است: Context Window یا «پنجرهٔ متنی».
در این مقاله با زبان ساده میگوییم Context Window چیست، چرا عدد «۱ میلیون توکن» اینقدر در تبلیغات مدلها تکرار میشود، کدام مدلها بزرگترین پنجره را دارند و مهمتر از همه، کدامها واقعاً متن طولانی را خوب میفهمند. اگر با خود مفهوم توکن و هزینهٔ آن آشنا نیستید، مقالهٔ قیمت API مدلهای هوش مصنوعی را هم ببینید.
آخرین بهروزرسانی: ۷ آبان ۱۴۰۵ — اندازهٔ پنجرهٔ متنی مدلها از Artificial Analysis و مستندات رسمی Anthropic، Google و xAI، و امتیازهای AA-LCR از سایت Artificial Analysis در همین تاریخ برداشته شدهاند.
⚡ پاسخ کوتاه
Context Window مقدار متنی است که مدل در یک لحظه میتواند «جلوی چشمش» داشته باشد؛ شامل پیامهای شما، فایلها، دستورهای سیستمی و پاسخ خود مدل. واحد آن توکن است. امروز Llama 4 Scout با ۱۰ میلیون توکن بزرگترین پنجره را دارد و بیشتر مدلهای پرچمدار مثل GPT-6، Claude Opus 5.5 و Gemini 4 حدود ۱ میلیون توکن دارند؛ Grok 4.7 هم ۵۰۰ هزار توکن. اما پنجرهٔ بزرگتر یعنی فهم بهتر نیست: در آزمون AA-LCR، Kimi K3 با ۸۸.۷٪ بهترین درک متن طولانی را داشته است.
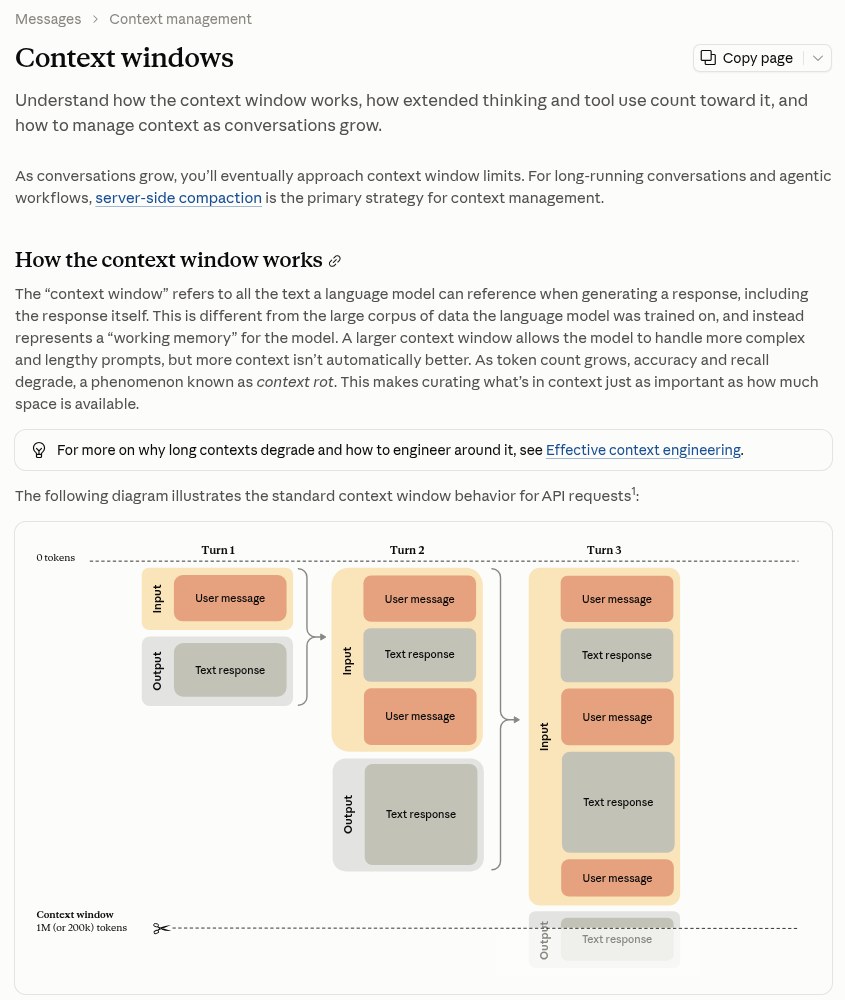
مستندات Anthropic پنجرهٔ متنی را «حافظهٔ کاری» مدل توصیف میکند: همهٔ متنی که مدل هنگام تولید پاسخ میتواند به آن رجوع کند، بهعلاوهٔ خود پاسخ. این با کل دانشی که مدل در دوران آموزش یاد گرفته فرق دارد؛ پنجرهٔ متنی فقط همان چیزی است که در همین درخواست به مدل دادهاید.
بخش Context windows در مستندات Anthropic که پنجرهٔ متنی را حافظهٔ کاری مدل توصیف میکند. منبع تصویر: Anthropic
یک تشبیه ساده: مدل زبانی مثل کارمندی است که روی میزش فقط جای مشخصی برای کاغذ دارد. هر چیزی روی میز باشد، میتواند بخواند و به آن ارجاع بدهد؛ اما اگر کاغذها از اندازهٔ میز بیشتر شوند، یا باید بعضی را کنار بگذارد یا کلاً کار را قبول نکند. اندازهٔ همین میز، Context Window است.
توکن چیست و چه چیزهایی در پنجره حساب میشوند؟
مدلها متن را به تکههایی به نام توکن میشکنند؛ هر توکن میتواند یک کلمه، بخشی از کلمه یا یک علامت باشد. چیزهایی که در پنجرهٔ متنی جا میگیرند:
دستورهای سیستمی و تنظیمات پنهان اپلیکیشن
همهٔ پیامهای قبلی گفتوگو (هم پیامهای شما و هم پاسخهای مدل)
فایلها، تصاویر و صفحههای PDF که پیوست کردهاید
نتیجهٔ ابزارها، مثل جستوجوی وب یا خروجی کد
در مدلهای استدلالی، «فکر کردن» مدل و پاسخ نهایی
Artificial Analysis هم پنجرهٔ متنی را مجموع توکنهای ورودی و خروجی تعریف میکند. در مستندات گوگل هم صریحاً آمده که پنجرهٔ ۱ میلیون توکنی Gemini 4 Argon بین ورودی، فکر کردن و خروجی مشترک است. برای همین در مدلهای استدلالی که پیش از پاسخ زیاد فکر میکنند، فضای واقعی برای متن شما کمتر از عدد اعلامشده است.
💡 نکته برای فارسیزبانها: متن فارسی معمولاً به توکنهای بیشتری نسبت به همان حجم متن انگلیسی تبدیل میشود. پس وقتی میخوانید «۱ میلیون توکن برابر چند رمان است»، این برآورد برای انگلیسی است و برای فارسی ظرفیت واقعی کمتر خواهد بود. نسبت دقیق به توکنایزر هر مدل بستگی دارد.
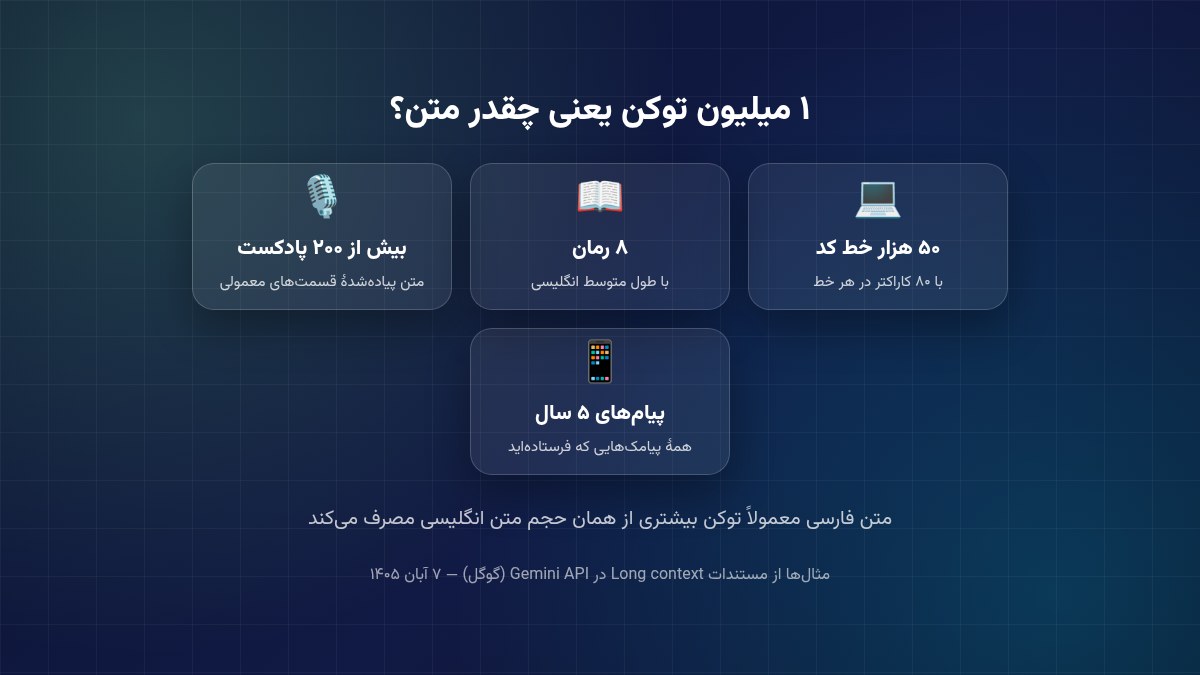
۱ میلیون توکن یعنی چقدر متن؟
برآورد گوگل از گنجایش یک پنجرهٔ ۱ میلیون توکنی. منبع تصویر: تحریریه رادینو
مستندات Long context گوگل چند مثال ملموس میزند. طبق این برآورد، ۱ میلیون توکن تقریباً برابر است با:
حدود ۵۰ هزار خط کد (با ۸۰ کاراکتر در هر خط)
همهٔ پیامکهایی که در ۵ سال گذشته فرستادهاید
۸ رمان انگلیسی با طول متوسط
متن پیادهشدهٔ بیش از ۲۰۰ قسمت پادکست با طول متوسط
گوگل همچنین یادآوری میکند که بیشتر مدلهای چند سال پیش پنجرهای حدود ۸ هزار توکن داشتند و بعد ۳۲ هزار و ۱۲۸ هزار توکن رایج شد. یعنی در مدت کوتاهی ظرفیت حافظهٔ کاری مدلها بیش از صد برابر شده است.
کدام مدلها طولانیترین پنجرهٔ متنی را دارند؟
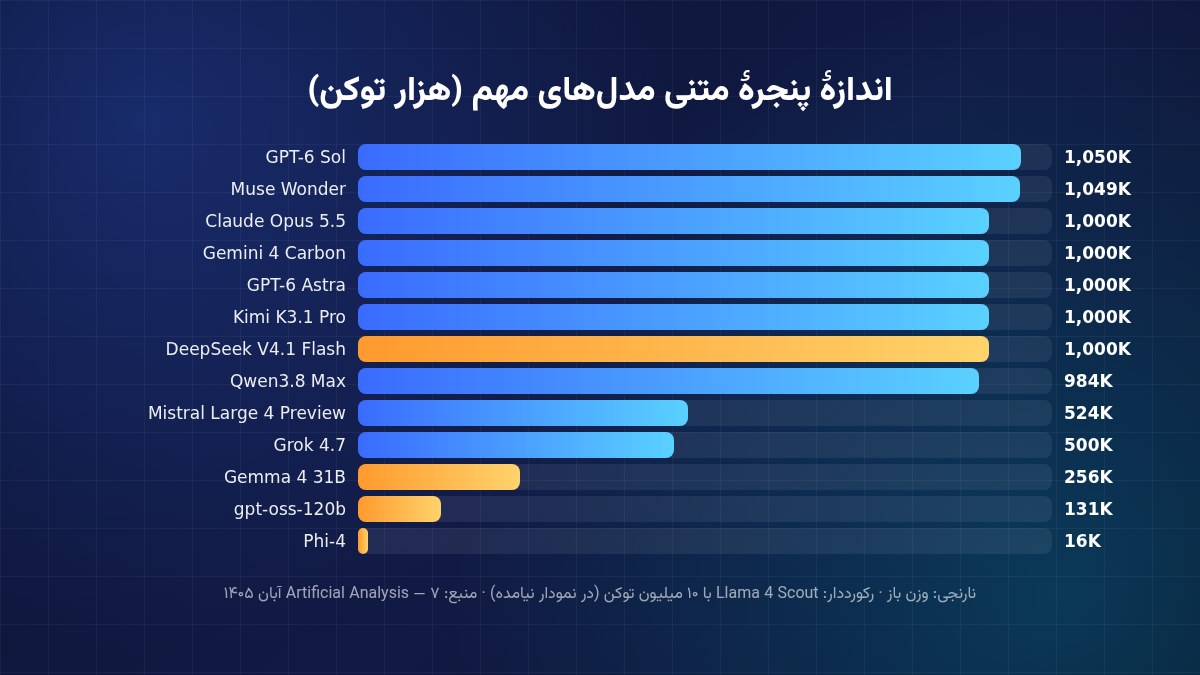
اندازهٔ پنجرهٔ متنی مدلهای مهم به هزار توکن؛ نارنجی: مدلهای وزن باز. منبع تصویر: تحریریه رادینو
مدل
پنجرهٔ متنی (توکن)
نوع
Llama 4 Scout
۱۰ میلیون
وزن باز
GPT-6 Sol
حدود ۱.۰۵ میلیون
بسته
Claude Opus 5.5
۱ میلیون
بسته
Gemini 4 Carbon / Gemini 4 Argon
۱ میلیون
بسته
GPT-6 Astra
۱ میلیون
بسته
Kimi K3.1 Pro
۱ میلیون
بسته
DeepSeek V4.1 Flash
۱ میلیون
وزن باز
Qwen3.8 Max
حدود ۹۸۴ هزار
بسته
Mistral Large 4 Preview
حدود ۵۲۴ هزار
بسته
Grok 4.7
۵۰۰ هزار
بسته
Gemma 4 31B
۲۵۶ هزار
وزن باز
gpt-oss-120b
حدود ۱۳۱ هزار
وزن باز
Phi-4
۱۶ هزار
وزن باز
اعداد بالا از دادههای Artificial Analysis و مستندات سازندهها آمدهاند. همانطور که میبینید، «۱ میلیون توکن» عملاً استاندارد مدلهای پرچمدار شده است. مستندات Anthropic میگوید بسیاری از مدلهای فعلی Claude پنجرهٔ ۱ میلیون توکنی و تا ۱۲۸ هزار توکن خروجی دارند و در هر درخواست تا ۶۰۰ تصویر یا صفحهٔ PDF میپذیرند. برای آشنایی با تفاوت نسخههای Claude و GPT، راهنمای مدلهای Claude و مقالهٔ مدلهای GPT-6 را ببینید.
پنجرهٔ بزرگتر یعنی فهم بهتر؟ نه لزوماً
اینجا مهمترین نکتهٔ مقاله است. اینکه مدلی بتواند ۱ میلیون توکن را «بپذیرد»، به این معنی نیست که همهاش را خوب بفهمد. Anthropic در مستنداتش از پدیدهای به نام context rot (فرسایش متن) نام میبرد: هرچه تعداد توکنها بیشتر شود، دقت و توانایی یادآوری مدل افت میکند. پس مدیریت اینکه چه چیزی در پنجره باشد، به اندازهٔ بزرگی پنجره مهم است.
پژوهش معروف «Lost in the Middle» (گمشده در میانه) از لیو و همکاران در سال ۲۰۲۳ هم نشان داد مدلهای زبانی وقتی اطلاعات مهم در ابتدا یا انتهای متن باشد بهتر عمل میکنند و وقتی همان اطلاعات وسط یک متن طولانی باشد، عملکردشان بهطور محسوسی افت میکند.
آزمون AA-LCR؛ چه کسی واقعاً متن طولانی را میفهمد؟
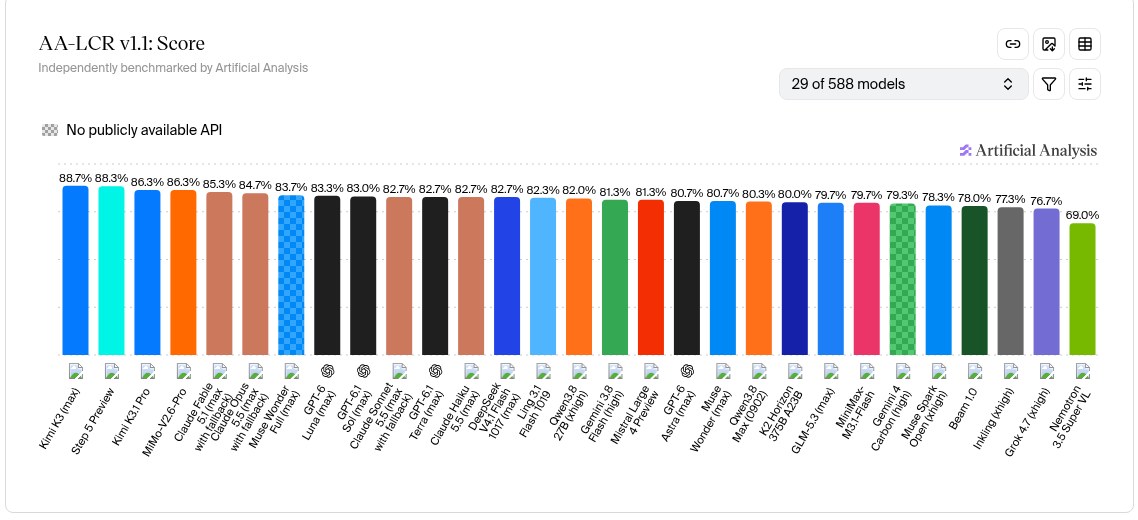
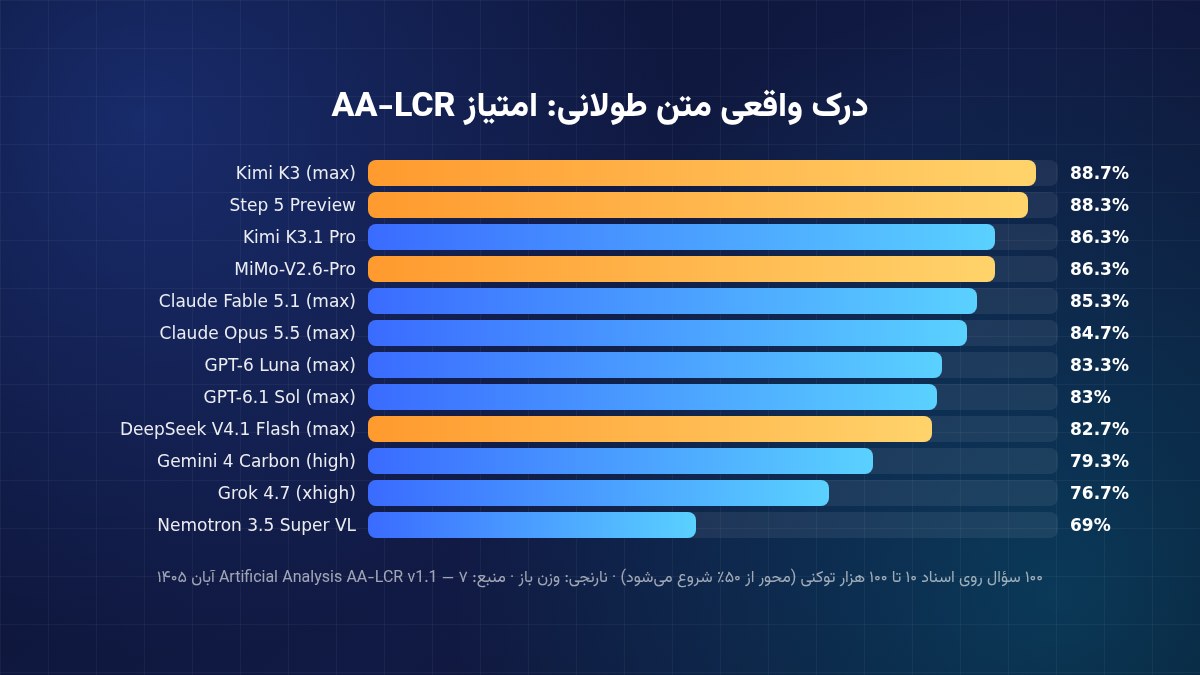
Artificial Analysis برای سنجیدن همین موضوع آزمونی به نام AA-LCR (استدلال روی متن طولانی) دارد: ۱۰۰ سؤال سخت روی اسنادی بین ۱۰ تا ۱۰۰ هزار توکن که جوابشان را نمیشود با پیدا کردن یک جمله داد و مدل باید اطلاعات چند بخش از سند را کنار هم بگذارد.
نمودار آزمون AA-LCR در سایت Artificial Analysis. منبع تصویر: Artificial Analysisامتیاز مدلها در آزمون استدلال روی متن طولانی AA-LCR؛ نارنجی: مدلهای وزن باز. منبع تصویر: تحریریه رادینو
نتیجه جالب است: صدر جدول دست Kimi K3 (۸۸.۷٪) و Step 5 Preview (۸۸.۳٪) است و Kimi K3.1 Pro و MiMo-V2.6-Pro با ۸۶.۳٪ پشت سرشاناند. Claude Fable 5.1 (۸۵.۳٪) و Claude Opus 5.5 (۸۴.۷٪) هم نزدیکاند. در مقابل، Gemini 4 Carbon با وجود پنجرهٔ ۱ میلیون توکنی ۷۹.۳٪ و Grok 4.7 ۷۶.۷٪ گرفتهاند. حتی مدل وزن باز و ارزان DeepSeek V4.1 Flash با ۸۲.۷٪ از هر دو جلوتر است.
درس عملی این جدول: اگر کارتان تحلیل قرارداد، گزارشهای بلند یا کتاب است، بهجای نگاه کردن به عدد پنجره، به نتیجهٔ آزمونهایی مثل AA-LCR نگاه کنید.
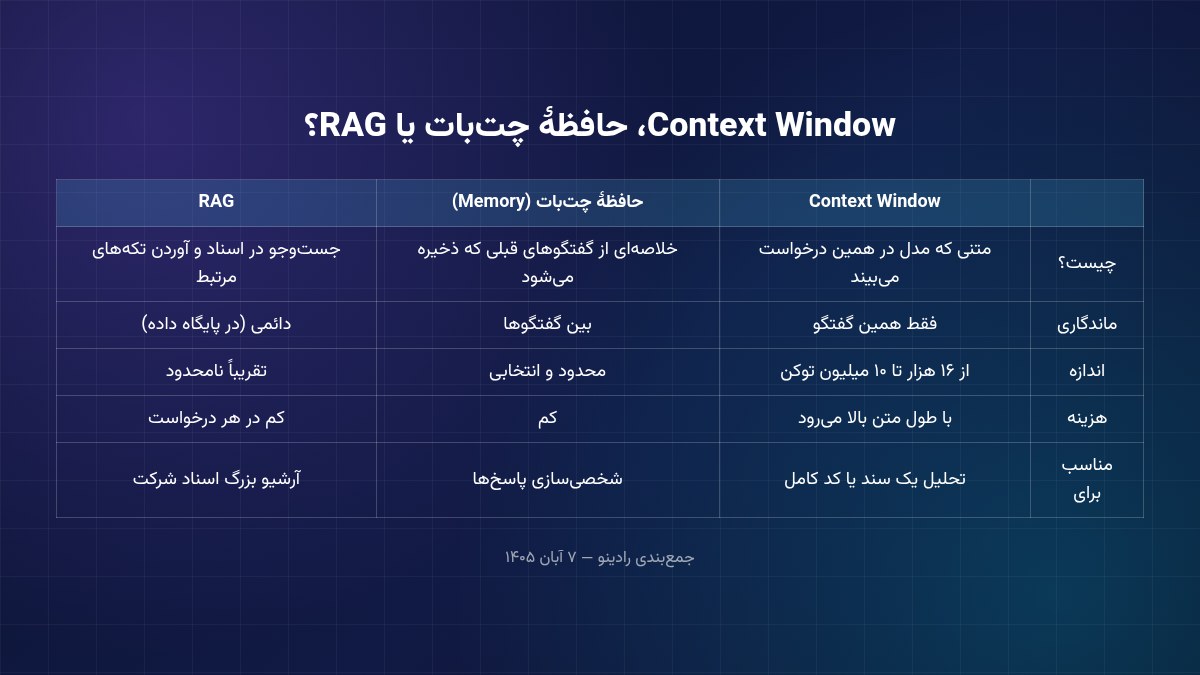
Context Window، حافظهٔ چتبات یا RAG؟
سه روش متفاوت برای اینکه مدل اطلاعات را «به یاد» داشته باشد. منبع تصویر: تحریریه رادینو
خیلیها این سه مفهوم را با هم اشتباه میگیرند. Context Window فقط همان چیزی است که در همین درخواست جلوی مدل است. حافظهٔ چتبات (مثل Memory در ChatGPT) خلاصهای از گفتوگوهای قبلی را ذخیره میکند و در گفتوگوهای بعدی دوباره در پنجره میگذارد؛ یعنی حافظه هم در نهایت از همان پنجره استفاده میکند. RAG هم روشی است که از میان انبوهی سند، فقط تکههای مرتبط را پیدا میکند و به پنجره اضافه میکند. توضیح کامل این روش را در مقالهٔ RAG چیست بخوانید.
نکتههای کاربردی برای استفادهٔ بهتر از Context Window
برای کار طولانی گفتوگوی تازه باز کنید. وقتی موضوع عوض میشود، شروع دوباره هم دقت را بالا میبرد و هم هزینه را پایین میآورد.
اطلاعات مهم را ابتدا یا انتها بگذارید. با توجه به یافتههای «Lost in the Middle»، سؤال اصلی و دستور مهم را در وسط یک متن بلند گم نکنید.
از فشردهسازی استفاده کنید. مستندات Anthropic قابلیتی به نام compaction را توضیح میدهد که بخشهای قدیمی گفتوگو را در سمت سرور خلاصه میکند تا جای خالی باز شود.
هزینه و سرعت را در نظر بگیرید. هر توکن ورودی هزینه دارد و پردازش ورودی بلند، زمان رسیدن اولین پاسخ را بیشتر میکند؛ دربارهٔ سرعت مدلها این مقاله را ببینید.
در مدلهای محلی تنظیم پنجره را چک کنید. طبق مستندات Ollama، پنجرهٔ پیشفرض به حافظهٔ گرافیک بستگی دارد: زیر ۲۴ گیگابایت ۴ هزار توکن، بین ۲۴ تا ۴۸ گیگابایت ۳۲ هزار و بیشتر از آن ۲۵۶ هزار توکن. برای کارهای ایجنتی و کدنویسی دستکم ۶۴ هزار توکن پیشنهاد شده و پنجرهٔ بزرگتر حافظهٔ بیشتری مصرف میکند.
معمولاً «پنجرهٔ متنی» یا «پنجرهٔ زمینه» ترجمه میشود؛ یعنی مقدار متنی که مدل در یک درخواست میتواند ببیند و به آن رجوع کند.
کدام هوش مصنوعی بیشترین حافظه را دارد؟
از نظر اندازهٔ پنجره، Llama 4 Scout با ۱۰ میلیون توکن. از مدلهای بسته، GPT-6 Sol، Claude Opus 5.5، Gemini 4 و GPT-6 Astra حدود ۱ میلیون توکن دارند. اما در درک متن طولانی (آزمون AA-LCR)، Kimi K3 با ۸۸.۷٪ اول است.
اگر متن از Context Window بیشتر شود چه میشود؟
در API معمولاً خطا برمیگرداند؛ مثلاً مستندات Anthropic میگوید در این حالت خطای ۴۰۰ دریافت میکنید. در اپهای چت، معمولاً بخشهای قدیمی گفتوگو کنار گذاشته یا خلاصه میشوند و مدل آنها را «فراموش» میکند.
آیا Context Window همان حافظهٔ ChatGPT است؟
نه. Context Window ظرفیت هر درخواست است، اما حافظه اطلاعاتی است که اپلیکیشن از گفتوگوهای قبلی نگه میدارد و دوباره در پنجره قرار میدهد.
آیا پنجرهٔ متنی بزرگتر همیشه بهتر است؟
نه همیشه. پنجرهٔ بزرگ هزینه و زمان پاسخ را بالا میبرد و طبق مستندات Anthropic، با بیشتر شدن توکنها دقت یادآوری افت میکند. برای اسناد زیاد، RAG اغلب ارزانتر و دقیقتر است.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.