هر ماه چند مدل زبانی تازه از راه میرسند و جای بهترینها مدام عوض میشود. اگر بخواهید بدانید امروز واقعاً کدام مدل قویتر، سریعتر یا بهصرفهتر است، باید به جای ادعاهای تبلیغاتی سراغ دادههای مستقل بروید. در این مقاله رتبه بندی مدل های هوش مصنوعی را بر اساس دو منبع معتبر یعنی شاخص هوش Artificial Analysis و رأی کاربران در LMArena مرور میکنیم و مدلهایی مثل Claude Opus 5.5، GPT-6، Gemini 4، Grok 4.7 و DeepSeek را از سه زاویهٔ هوش، سرعت و قیمت کنار هم میگذاریم.
آخرین بهروزرسانی: ۲۷ مهر ۱۴۰۵ — اعداد این مقاله از لیدربورد Artificial Analysis (دادههای ۲۷ مهر ۱۴۰۵) و LMArena (دادههای ۲۳ و ۲۶ مهر ۱۴۰۵) برداشته شدهاند. این رتبهبندی را ماهانه بهروز میکنیم، چون لیدربوردها مدام تغییر میکنند.
هیچ عدد واحدی نمیتواند بهتنهایی بگوید «بهترین مدل هوش مصنوعی» کدام است. برای همین در این رتبهبندی از دو نوع داده استفاده کردهایم که مکمل هم هستند. اگر با خود مفهوم بنچمارک آشنا نیستید، اول راهنمای بنچمارکهای هوش مصنوعی را بخوانید؛ آنجا توضیح دادهایم هر آزمون دقیقاً چه چیزی را میسنجد.
شاخص هوش Artificial Analysis (نسخهٔ ۴.۳.۲): مدلها را روی مجموعهای از آزمونهای استدلال، دانش، ریاضی، کدنویسی و کارهای ایجنتی امتحان میکند و نتیجه را در یک عدد خلاصه میکند. این سایت در حال حاضر بیش از ۲۵۰ مدل را مقایسه میکند و سرعت، تأخیر و هزینهٔ هر تسک را هم اندازه میگیرد.
LMArena: کاربران واقعی پاسخ دو مدل ناشناس را مقایسه و به بهتری رأی میدهند و از این رأیها امتیاز Elo ساخته میشود. لیدربورد متنی آن در ۲۳ مهر ۱۴۰۵ بر پایهٔ ۸٬۸۳۴٬۲۱۱ رأی و ۴۱۶ مدل بود.
یک نکتهٔ مهم: بسیاری از مدلها چند «سطح استدلال» دارند (مثل low، high یا max). همان مدل در سطح بالاتر باهوشتر اما کندتر و گرانتر است، به همین دلیل در جدولها سطح استدلال را هم کنار نام مدل آوردهایم.
چطور یک لیدربورد را درست بخوانیم؟
وقتی به جدول رتبهبندی نگاه میکنید، به چند نکته دقت کنید. اول، فاصلهٔ امتیازها: در LMArena هر امتیاز یک بازهٔ خطا دارد و مدلهایی که فقط چند امتیاز با هم فاصله دارند، عملاً همسطحاند. دوم، برچسب «مقدماتی» یعنی هنوز رأی کافی برای آن مدل جمع نشده و رتبهاش ممکن است تغییر کند. سوم، تاریخ دادهها: رتبهای که سه ماه پیش منتشر شده، امروز احتمالاً کهنه است. و در نهایت، همیشه بپرسید این لیدربورد دقیقاً چه چیزی را میسنجد و آیا با کار شما ربط دارد یا نه.
هر مدل را باید از سه زاویه سنجید: کیفیت پاسخ، سرعت تولید و هزینهٔ واقعی هر کار.
۱۰ مدل برتر هوش مصنوعی این ماه
جدول زیر ده مدل اول شاخص هوش Artificial Analysis را نشان میدهد. برای مدلهایی که چند سطح استدلال دارند، فقط بهترین نسخه را آوردهایم تا فهرست شلوغ نشود.
رتبه
مدل (سطح استدلال)
سازنده
شاخص هوش
هزینهٔ هر تسک
1
Claude Opus 5.5 (max)
Anthropic
58
$5.98
2
Claude Sonnet 5.5 (max)
Anthropic
56
$5.46
3
Muse Wonder Full (max)
Meta
56
گزارش نشده
4
Claude Fable 5.1 (max)
Anthropic
53
$7.63
5
GPT-6 Astra (max)
OpenAI
53
$3.26
6
Gemini 4 Argon (high)
Google
53
$1.99
7
GPT-6.1 Sol (max)
OpenAI
52
$0.72
8
Grok 4.7 (xhigh)
SpaceXAI
46
$3.74
9
MiMo-V2.6-Pro
Xiaomi
46
$0.13
10
DeepSeek V4.1 Flash 1017 (max)
DeepSeek
45
$0.26
منبع: لیدربورد مدلهای Artificial Analysis (دریافت: ۲۷ مهر ۱۴۰۵). رتبهها بر اساس بهترین نسخهٔ هر مدل مرتب شدهاند؛ در رتبههای مساوی ترتیب جدول اصلی حفظ شده است.
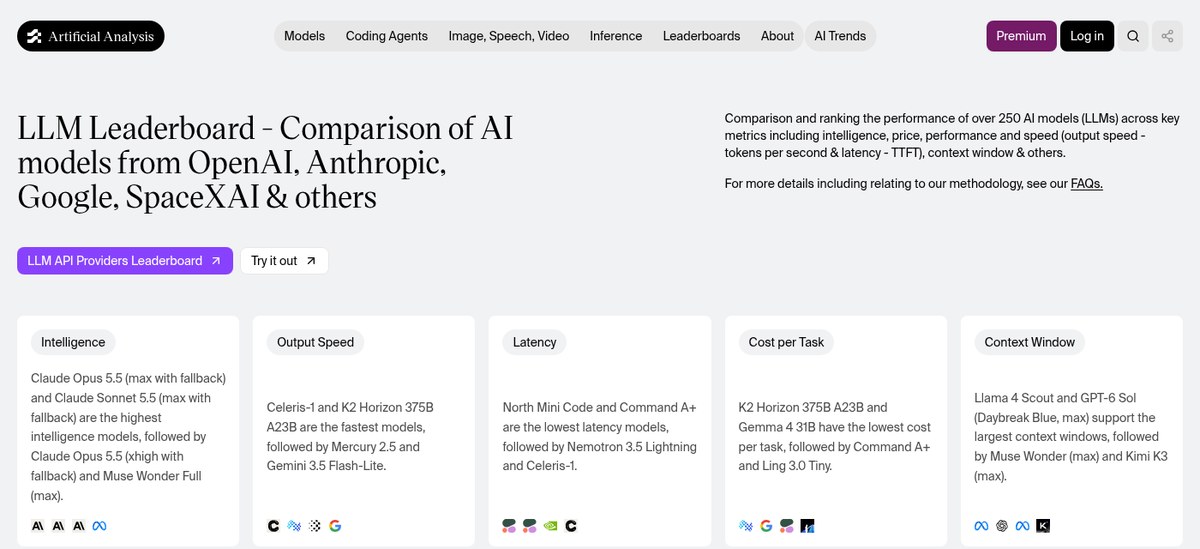
کارتهای خلاصهٔ Artificial Analysis: برترینها در هوش، سرعت خروجی، تأخیر، هزینهٔ هر تسک و طول کانتکست. منبع تصویر: Artificial Analysis
قوی ترین هوش مصنوعی ۲۰۲۶ کدام است؟
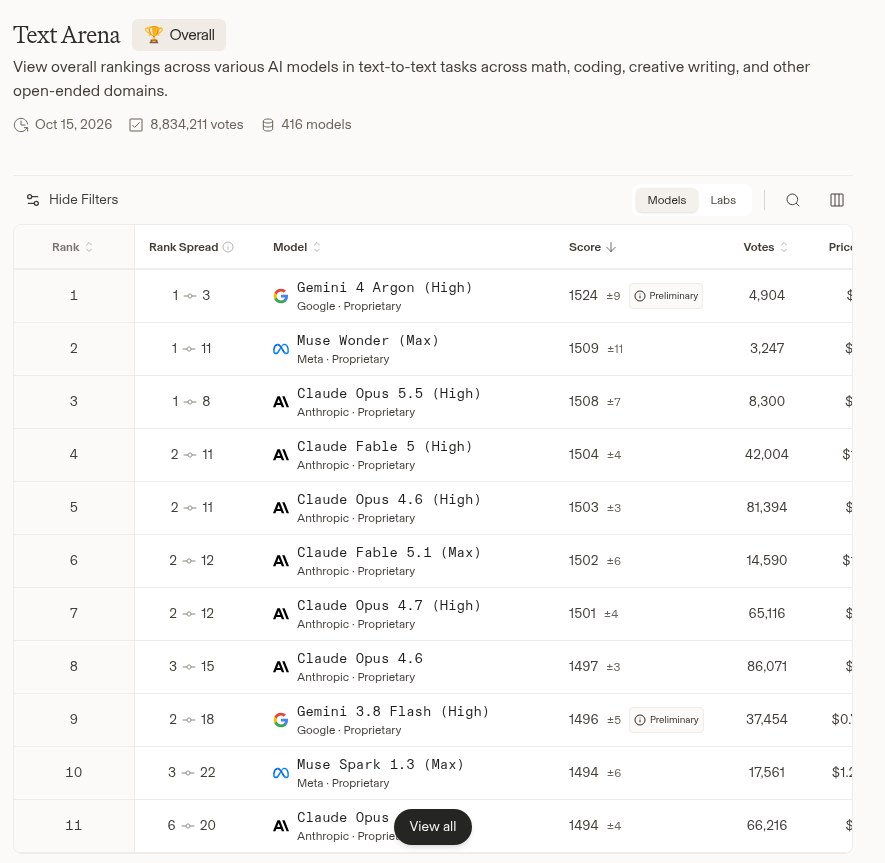
اگر فقط معیار هوش را در نظر بگیریم، Claude Opus 5.5 با امتیاز ۵۸ در سطح max قویترین مدل فعلی است و Anthropic با سه مدل در پنج رتبهٔ اول، صدرنشین این ماه است. اما در LMArena تصویر کمی فرق دارد: Gemini 4 Argon با امتیاز ۱۵۲۴ (هنوز با برچسب «مقدماتی») در صدر لیدربورد متنی است و Muse Wonder متا با ۱۵۰۹ و Claude Opus 5.5 با ۱۵۰۸ پشت سرش قرار دارند. یعنی در گفتگوهای روزمره، کاربران پاسخهای Gemini را کمی بیشتر پسندیدهاند.
رتبهبندی بر اساس رأی کاربران (LMArena)
مدل
امتیاز Text Arena
امتیاز WebDev Arena
Gemini 4 Argon (High)
1524
1678
Muse Wonder (Max)
1509
—
Claude Opus 5.5
1508 (High)
1806 (Max)
Claude Fable 5.1 (Max)
1502
1743
GPT-6.1 Sol (Max)
1484
1753
GPT-6 Astra (Max)
1477
1775
Claude Sonnet 5.5 (xHigh)
1475
1769
DeepSeek-V4.1-Flash (Max)
1475 (نسخهٔ 20260910)
1664 (نسخهٔ 20261017)
Grok 4.7 (xHigh)
1444
1638
منبع: LMArena، لیدربورد Text (۲۳ مهر ۱۴۰۵) و WebDev (۲۶ مهر ۱۴۰۵). علامت «—» یعنی آن مدل در دهها رتبهٔ اول آن لیدربورد نبود و ما عددش را ثبت نکردیم.
در WebDev Arena که توانایی ساخت صفحه و اپلیکیشن وب را میسنجد، Claude Opus 5.5 با فاصلهٔ زیاد (۱۸۰۶ امتیاز) اول است و GPT-6 Astra با ۱۷۷۵ دوم. پس اگر کار شما طراحی فرانتاند است، رتبهٔ متنی را ملاک قرار ندهید؛ جزئیات بیشتر را در بهترین هوش مصنوعی برای برنامهنویسی آوردهایم.
صفحهٔ Text Arena در LMArena؛ دادههای ۲۳ مهر ۱۴۰۵ با بیش از ۸.۸ میلیون رأی. منبع تصویر: LMArena
مقایسه هوش مدلها (Intelligence Index)
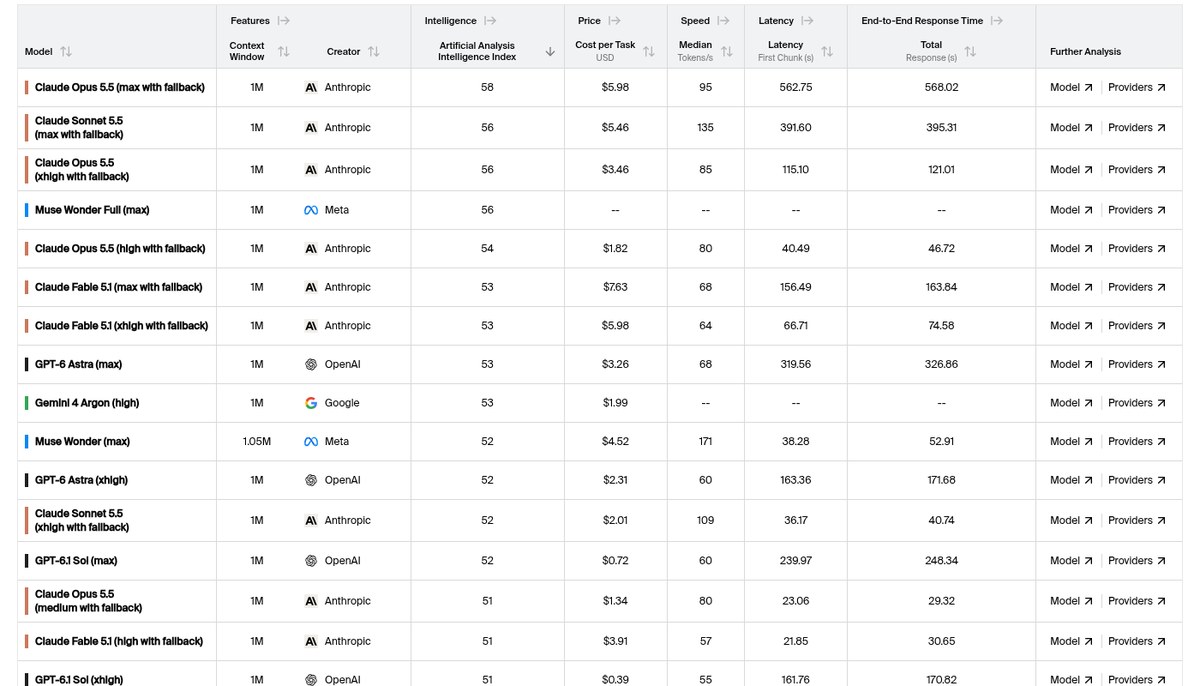
شاخص هوش Artificial Analysis بهترین نقطهٔ شروع برای مقایسه مدل های زبانی است، چون همهٔ مدلها را با یک روش و روی یک مجموعه آزمون میسنجد. چند الگوی جالب در دادههای این ماه دیده میشود:
اثر سطح استدلال بسیار بزرگ است. Opus 5.5 در سطح max امتیاز ۵۸ میگیرد، در xhigh ۵۶، در high ۵۴ و در medium ۵۱. یعنی انتخاب سطح استدلال گاهی از انتخاب خود مدل مهمتر است.
Sonnet 5.5 تقریباً همسطح Opus است. Claude Sonnet 5.5 با ۵۶ امتیاز تقریباً همسطح Opus 5.5 در xhigh است.
رقابت OpenAI و Google نزدیک است. GPT-6 Astra و Gemini 4 Argon هر دو ۵۳ امتیاز دارند، اما هزینهٔ هر تسک Gemini حدود ۱.۹۹ دلار و Astra حدود ۳.۲۶ دلار است.
Grok 4.7 در میانهٔ جدول است. با امتیاز ۴۶ در سطح xhigh و کانتکست ۵۰۰ هزار توکنی، Grok 4.7 همردیف بهترین مدلهای متنباز قرار میگیرد. برای آشنایی بیشتر با این خانواده، آشنایی با هوش مصنوعی Grok را ببینید.
بخشی از جدول اصلی Artificial Analysis که شاخص هوش، هزینهٔ هر تسک، سرعت خروجی و تأخیر هر مدل را نشان میدهد. منبع تصویر: Artificial Analysis
مقایسه سرعت و تأخیر مدلها
سرعت دو جنبه دارد: سرعت خروجی (تعداد توکنی که مدل در هر ثانیه تولید میکند) و تأخیر (زمانی که طول میکشد تا اولین تکهٔ پاسخ برسد). در مدلهای استدلالی، تأخیر شامل زمان فکر کردن هم هست و میتواند به چند دقیقه برسد.
نتیجه روشن است: سریعترین مدلها معمولاً باهوشترینها نیستند. Celeris-1 با ۱٬۴۸۵ توکن در ثانیه سریعترین مدل جدول است، اما شاخص هوشش فقط ۶ است. در مقابل، Opus 5.5 در سطح max به طور میانه بیش از ۹ دقیقه فکر میکند تا اولین تکهٔ پاسخ را بدهد. اگر برنامهٔ شما به پاسخ فوری نیاز دارد (مثلاً چتبات پشتیبانی)، DeepSeek V4.1 Flash با تأخیر حدود یک ثانیه و شاخص هوش ۴۵ تعادل بسیار خوبی دارد. طبق همین لیدربورد، کمترین تأخیر متعلق به North Mini Code و Command A+ از Cohere است.
مقایسه قیمت و هزینه هر تسک
قیمت هر میلیون توکن فقط نیمی از ماجراست. مدلی که توکن بیشتری برای فکر کردن مصرف میکند، ممکن است با تعرفهٔ پایینتر در نهایت گرانتر تمام شود. به همین دلیل در کنار تعرفههای رسمی، هزینهٔ هر تسک Artificial Analysis را هم آوردهایم.
مدل
ورودی / خروجی (دلار برای ۱ میلیون توکن)
هزینهٔ هر تسک (AA)
Claude Opus 5.5
$4 / $20
$5.98 (max)
Claude Sonnet 5.5
$2 / $10
$5.46 (max)
GPT-6 Astra
$10 / $50
$3.26 (max)
Gemini 4 Argon
$2 / $10 (تا ۹ آذر ۱۴۰۵)
$1.99 (high)
GPT-6.1 Sol
$2 / $10
$0.72 (max)
Grok 4.7
$2 / $6
$3.74 (xhigh)
DeepSeek V4.1 Flash
$0.30 / $1.20 (ساعت اوج)
$0.26 (max)
Claude Haiku 5.5
$0.10 / $0.50 (تا ۱۰۰ هزار توکن)
$0.21 (max)
GPT-6 Luna
$0.10 / $0.50
$0.07 (max)
منبع: صفحههای رسمی قیمتگذاری OpenAI، Anthropic، Google، xAI و DeepSeek و لیدربورد Artificial Analysis (همه دریافت: ۲۷ مهر ۱۴۰۵).
از نظر نسبت کیفیت به هزینه، GPT-6.1 Sol برندهٔ واضح این ماه است: امتیاز ۵۲ با هزینهٔ ۰.۷۲ دلار برای هر تسک، یعنی حدود یکهشتم Opus 5.5. در سطح xhigh هم با ۵۱ امتیاز فقط ۰.۳۹ دلار هزینه دارد. اگر میخواهید جزئیات تعرفهها، کش و Batch را بدانید، مقالهٔ قیمت API مدلهای هوش مصنوعی ۲۰۲۶ را ببینید.
بهترین مدل متنباز
مدلهای متنباز (دقیقتر بگوییم، مدلهای با وزن باز) را میشود دانلود کرد و روی سرور خود اجرا کرد. این یعنی کنترل کامل روی دادهها و حذف وابستگی به یک شرکت خاص. فاصلهٔ این مدلها با مدلهای بسته هنوز وجود دارد، اما کمتر از همیشه است.
مدل با وزن باز
سازنده
شاخص هوش
هزینهٔ هر تسک
MiMo-V2.6-Pro
Xiaomi
46
$0.13
DeepSeek V4.1 Flash 1017 (max)
DeepSeek
45
$0.26
GLM-5.3 (max)
Z AI
45
$2.01
Kimi K3 (max)
Kimi
44
$2.00
Qwen3.8 2.4T A95B
Alibaba
40
$2.16
Muse Spark Open (xhigh)
Meta
39
$0.84
منبع: لیدربورد مدلهای Artificial Analysis با فیلتر وزن باز (دریافت: ۲۷ مهر ۱۴۰۵).
مدلهای با وزن باز کنترل و هزینهٔ پایین میدهند؛ مدلهای بسته هنوز در صدر امتیازها هستند.
بهترین مدل متنباز این ماه MiMo-V2.6-Pro از شیائومی است که با امتیاز ۴۶ همسطح Grok 4.7 قرار گرفته و هزینهٔ هر تسکش تنها ۰.۱۳ دلار است. DeepSeek V4.1 Flash هم با سرعت ۲۲۷ توکن در ثانیه و کانتکست یک میلیون توکنی گزینهٔ جذابی است. متا هم با Muse Spark Open یک مدل با وزن باز در این جدول دارد؛ اگر سابقهٔ Llama را دنبال کردهاید، مقالهٔ همه چیز دربارهٔ Llama را هم ببینید. نکتهٔ جالب دیگر این است که طولانیترین کانتکست جدول، یعنی ۱۰ میلیون توکن، متعلق به مدل باز Llama 4 Scout است.
تغییرات و نکات مهم این ماه
اگر نسخهٔ قبلی جدول رتبهبندی مدلهای هوش مصنوعی را در رادینو خوانده باشید، میبینید که تقریباً همهٔ نامها عوض شدهاند. نسل GPT-5 که در مقالهٔ GPT-5 چیست بررسی کرده بودیم، حالا جای خود را به خانوادهٔ GPT-6 داده است. مهمترین نکتههای این ماه:
Gemini 4 Argon تازهوارد است. در LMArena هنوز برچسب «مقدماتی» دارد، اما همین حالا در صدر Text Arena است. قیمت فعلیاش تبلیغاتی است و از ۱۰ آذر ۱۴۰۵ دو برابر میشود.
DeepSeek نسخهٔ جدید Flash را منتشر کرد. نسخهٔ V4.1-Flash-1017 هم در Artificial Analysis (امتیاز ۴۵) و هم در WebDev Arena (رتبهٔ ۱۲) حضور دارد و در API با نام deepseek-flash ارائه میشود؛ درخواستهایی که با نامهای قدیمی مثل deepseek-v4-flash فرستاده شوند هم به همین نسخه میرسند.
Anthropic در صدر است. Opus 5.5 هم در شاخص هوش و هم در WebDev Arena رتبهٔ اول را دارد.
OpenAI روی نسبت کیفیت به هزینه تمرکز کرده است. GPT-6.1 Sol با کمتر از یک دلار برای هر تسک، اقتصادیترین مدل میان ده مدل اول است.
لیدربوردها ثابت نیستند؛ این رتبهبندی را هر ماه بازبینی میکنیم.
کدام مدل را انتخاب کنیم؟
جمعبندی رتبهها برای سناریوهای رایج:
بیشترین کیفیت بدون توجه به هزینه: Claude Opus 5.5 در سطح max یا high.
بهترین تعادل کیفیت و هزینه: GPT-6.1 Sol یا Gemini 4 Argon.
پاسخ سریع با هزینهٔ کم: DeepSeek V4.1 Flash یا Claude Haiku 5.5 در سطح پایینتر استدلال.
اجرا روی سرور خودتان: MiMo-V2.6-Pro، GLM-5.3 یا Kimi K3.
طبق شاخص هوش Artificial Analysis در ۲۷ مهر ۱۴۰۵، Claude Opus 5.5 در سطح max با امتیاز ۵۸ قویترین مدل است. در رأی کاربران LMArena اما Gemini 4 Argon با امتیاز ۱۵۲۴ در صدر لیدربورد متنی قرار دارد.
لیدربورد LLM چیست و به کدام اعتماد کنیم؟
لیدربورد جدولی است که مدلها را بر اساس نتایج آزمون یا رأی کاربران مرتب میکند. Artificial Analysis بر پایهٔ آزمونهای استاندارد و اندازهگیری سرعت و هزینه کار میکند و LMArena بر پایهٔ رأی کور کاربران. بهتر است هر دو را با هم ببینید.
چرا یک مدل در لیدربوردهای مختلف رتبههای متفاوتی دارد؟
چون هر لیدربورد چیز متفاوتی را میسنجد. شاخص هوش توانایی حل مسئله را اندازه میگیرد و LMArena ترجیح کاربران در گفتگو را. مثلاً GPT-6.1 Sol در شاخص هوش رتبهٔ بالایی دارد، اما در Text Arena رتبهٔ ۲۲ را گرفته است.
بهترین مدل هوش مصنوعی متنباز کدام است؟
در دادههای این ماه، MiMo-V2.6-Pro از شیائومی با شاخص هوش ۴۶ بهترین مدل با وزن باز است و DeepSeek V4.1 Flash و GLM-5.3 با امتیاز ۴۵ پشت سر آن قرار دارند.
این رتبهبندی هر چند وقت بهروز میشود؟
لیدربوردهای مرجع تقریباً هر روز تغییر میکنند. ما این مقاله را ماهانه بازبینی میکنیم و تاریخ دریافت دادهها را بالای مقاله مینویسیم.
جمعبندی
رتبهبندی مدلهای هوش مصنوعی در مهر ۱۴۰۵ نشان میدهد که Anthropic با Claude Opus 5.5 در صدر هوش و کدنویسی وب است، Google با Gemini 4 Argon محبوبترین مدل در رأی کاربران شده و OpenAI با GPT-6.1 Sol بهترین نسبت کیفیت به هزینه را ارائه میدهد. مدلهای متنبازی مثل MiMo-V2.6-Pro و DeepSeek V4.1 Flash هم فاصله را بهشدت کم کردهاند. مهمترین توصیهٔ ما این است که مدل را فقط با یک عدد انتخاب نکنید؛ هوش، سرعت و هزینهٔ هر تسک را کنار هم بگذارید و در نهایت روی کار واقعی خودتان آزمایش کنید.
اگر میخواهید استفادهٔ حرفهای از این مدلها را قدمبهقدم یاد بگیرید، دورهٔ کپسول هوش مصنوعی رادینو برای شما طراحی شده است.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.