اگر این روزها دنبال قویترین هوش مصنوعی برای کدنویسی، تحلیل یا کارهای ایجنتی هستید، احتمالاً بین دو اسم مردد ماندهاید: Claude Opus 5.5 از Anthropic و GPT-6 Astra از OpenAI. هر دو از قویترین مدلهای شرکت سازندهشان هستند، هر دو کانتکست حدود یک میلیون توکنی دارند و هر دو میتوانند قبل از جواب دادن «فکر» کنند. اما در عمل کدام قویتر است و کدام بهصرفهتر؟
در این مقاله این دو مدل را با دادههای مستقل Artificial Analysis و مشخصات رسمی سازندهها، از نظر هوش، کدنویسی، توهم، سرعت و قیمت مقایسه میکنیم. اگر دنبال مقایسهٔ اپلیکیشنها (ChatGPT، Claude، Gemini و Copilot) هستید، مقایسهٔ چتباتهای محبوب را ببینید؛ این مقاله دربارهٔ خود مدلها و API آنهاست.
آخرین بهروزرسانی: ۵ آبان ۱۴۰۵ — اعداد از لیدربورد و صفحهٔ مقایسهٔ Artificial Analysis و مستندات رسمی Anthropic و OpenAI برداشته شدهاند.
⚡ پاسخ کوتاه
در شاخص هوش Artificial Analysis، Claude Opus 5.5 (Max) با امتیاز ۵۷.۶ بالاتر از GPT-6 Astra (Max) با ۵۲.۷ قرار دارد و در آزمونهای استدلال علمی (HLE)، کدنویسی علمی (SciCode) و متن بلند جلوتر است. قیمت هر توکن Opus هم ارزانتر است (۴ و ۲۰ دلار در برابر ۱۰ و ۵۰ دلار برای هر میلیون توکن ورودی و خروجی). در مقابل، Astra در AA-Omniscience نرخ توهم کمتری دارد، در پاسخ از PDFهای طولانی (GDP.pdf) بهتر است و در سطح تلاش Max هزینهٔ کل هر تسک آن کمتر است. برای بیشتر کارها Opus 5.5 انتخاب اول است؛ اگر دقت واقعیتمحور و کار با سند برایتان مهمتر است، Astra را هم امتحان کنید.
Anthropic در مستندات رسمی خود Opus 5.5 را مدلی «برای کارهای طولانی کدنویسی ایجنتی و کار دانشی» معرفی میکند و پیشنهاد میدهد اگر مطمئن نیستید از کدام مدل استفاده کنید، برای بیشتر کارها با همین مدل شروع کنید. این شرکت مدل گرانتری به نام Claude Fable 5.1 (۱۰ و ۵۰ دلار برای هر میلیون توکن) هم دارد که برای استدلالهای سنگین و کارهای ایجنتی خیلی طولانی پیشنهاد میشود؛ اما در شاخص هوش Artificial Analysis، Fable 5.1 در سطح Max با ۵۳.۴ امتیاز پایینتر از Opus 5.5 میایستد. به همین دلیل در این مقاله Opus 5.5 را با Astra مقایسه میکنیم. OpenAI هم GPT-6 Astra را «توانمندترین مدل برای سختترین کارها» و انتخاب اول برای استدلال و کدنویسی پیچیده میداند.
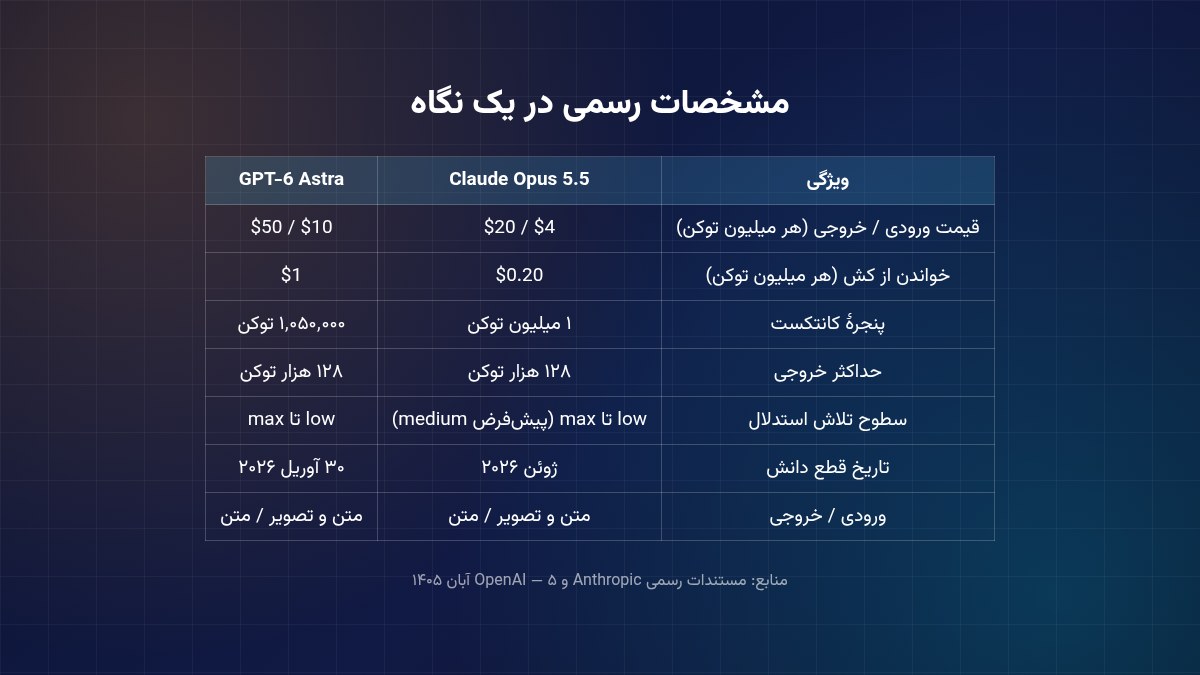
مشخصات رسمی Claude Opus 5.5 و GPT-6 Astra؛ قیمتها به دلار برای هر میلیون توکن. منبع تصویر: تحریریه رادینو
ویژگی
Claude Opus 5.5
GPT-6 Astra
سازنده
Anthropic
OpenAI
قیمت ورودی / خروجی
۴ / ۲۰ دلار
۱۰ / ۵۰ دلار
خواندن از کش
۵٪ قیمت ورودی (۰.۲۰ دلار)
۱ دلار
پنجرهٔ کانتکست
۱ میلیون توکن
۱٬۰۵۰٬۰۰۰ توکن
حداکثر خروجی
۱۲۸ هزار توکن
۱۲۸ هزار توکن
تاریخ قطع دانش
ژوئن ۲۰۲۶
۳۰ آوریل ۲۰۲۶
تلاش پیشفرض استدلال
medium
—
ورودی / خروجی
متن و تصویر / متن
متن و تصویر / متن
هر دو مدل «سطح تلاش» (effort) دارند؛ یعنی میتوانید تعیین کنید مدل قبل از پاسخ چقدر فکر کند. هرچه تلاش بیشتر، پاسخ معمولاً دقیقتر اما کندتر و گرانتر است. اگر با این مفهوم آشنا نیستید، راهنمای مدلهای استدلالی را بخوانید.
کدام باهوشتر است؟ شاخص هوش Artificial Analysis
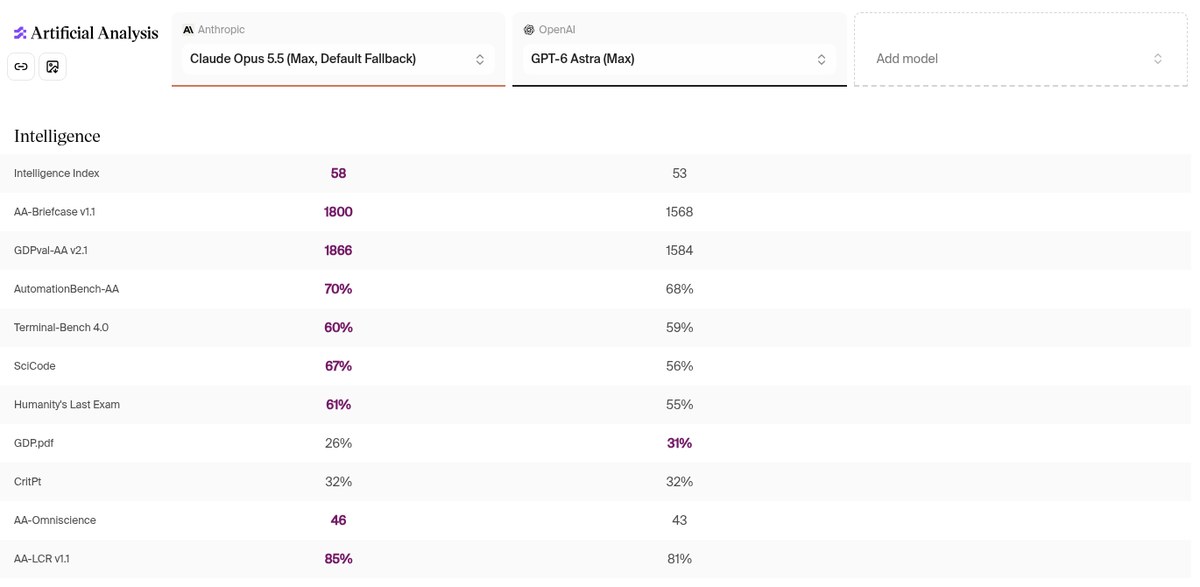
صفحهٔ مقایسهٔ مستقیم دو مدل در سایت Artificial Analysis (هر دو در سطح تلاش Max). منبع تصویر: Artificial Analysis
شاخص هوش Artificial Analysis (نسخهٔ 4.3.2) میانگین وزندار ۱۰ ارزیابی در چهار دسته است: ایجنتها (۳۰٪)، کدنویسی (۲۰٪)، استدلال علمی (۲۰٪) و دانش عمومی (۳۰٪). در این شاخص، Claude Opus 5.5 در سطح Max با ۵۷.۶ در صدر کل لیدربورد است و GPT-6 Astra در همان سطح ۵۲.۷ میگیرد. برای آشنایی با این شاخص، راهنمای Artificial Analysis را ببینید.
در سطحهای پایینتر تلاش چه میشود؟
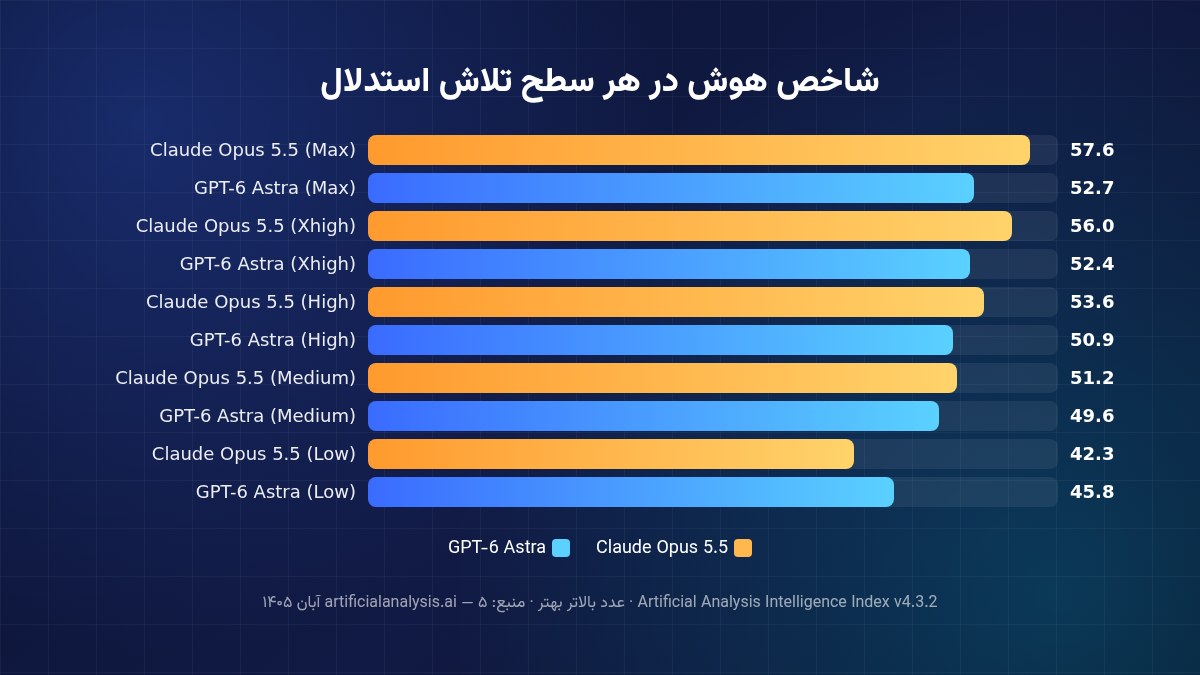
شاخص هوش دو مدل در پنج سطح تلاش استدلال؛ نارنجی Opus 5.5 و آبی GPT-6 Astra. منبع تصویر: تحریریه رادینو
فاصلهٔ دو مدل با پایین آمدن سطح تلاش کم میشود. در سطح Medium، Opus 5.5 امتیاز ۵۱.۲ و Astra امتیاز ۴۹.۶ دارد و در سطح Low حتی ترتیب برعکس میشود: Astra با ۴۵.۸ از Opus با ۴۲.۳ جلو میزند. نتیجهٔ عملی: اگر میخواهید با تلاش کم و پاسخ سریع کار کنید، برتری Opus دیگر قطعی نیست.
سطح تلاش
Claude Opus 5.5
GPT-6 Astra
Max
۵۷.۶
۵۲.۷
Xhigh
۵۶.۰
۵۲.۴
High
۵۳.۶
۵۰.۹
Medium
۵۱.۲
۴۹.۶
Low
۴۲.۳
۴۵.۸
مقایسه در بنچمارکهای تخصصی
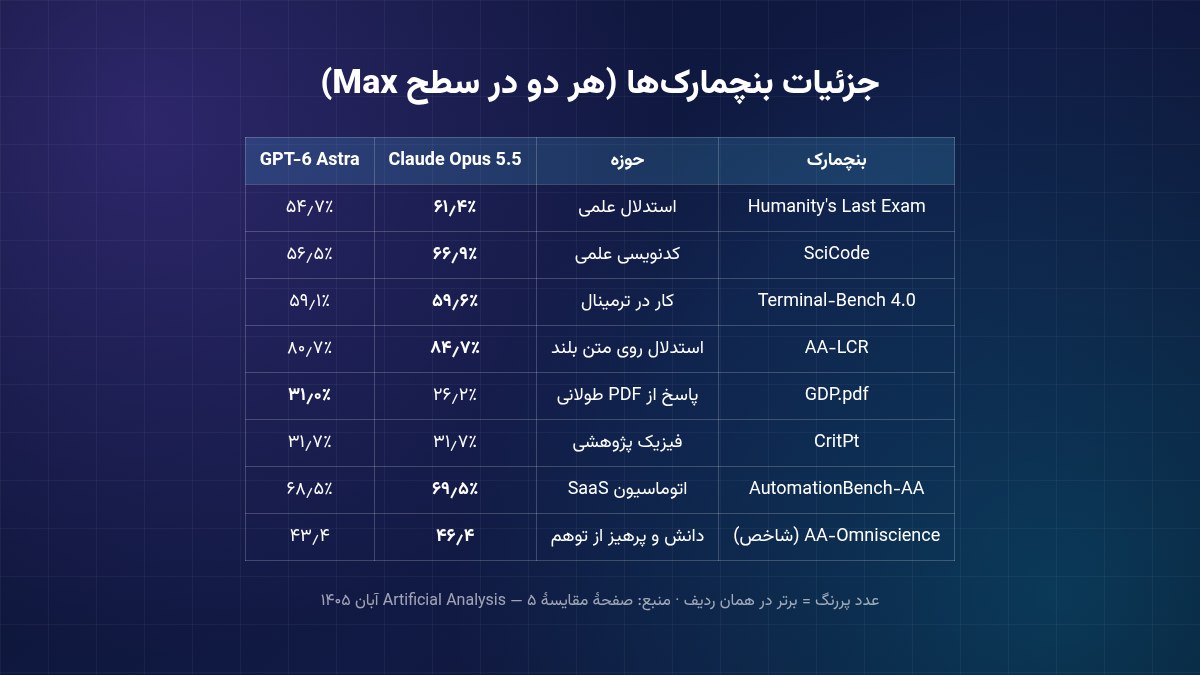
نتیجهٔ دو مدل در ارزیابیهای تشکیلدهندهٔ شاخص هوش؛ عدد پررنگ یعنی برتر. منبع تصویر: تحریریه رادینو
عدد کلی همهچیز را نمیگوید. وقتی به تکتک ارزیابیها نگاه کنیم (هر دو مدل در سطح Max)، تصویر دقیقتری به دست میآید. اگر نمیدانید هر بنچمارک چه میسنجد، راهنمای بنچمارکهای هوش مصنوعی را ببینید.
بنچمارک
چه میسنجد
Opus 5.5
Astra
Humanity's Last Exam
سؤالهای بسیار سخت علمی
۶۱.۴٪
۵۴.۷٪
SciCode
کدنویسی برای مسائل علمی
۶۶.۹٪
۵۶.۵٪
Terminal-Bench 4.0
انجام کار واقعی در ترمینال
۵۹.۶٪
۵۹.۱٪
AA-LCR
استدلال روی متنهای طولانی
۸۴.۷٪
۸۰.۷٪
GDP.pdf
پاسخ دقیق از روی PDF طولانی
۲۶.۲٪
۳۱.۰٪
CritPt
مسائل پژوهشی فیزیک
۳۱.۷٪
۳۱.۷٪
AutomationBench-AA
اتوماسیون کار با ابزارهای SaaS
۶۹.۵٪
۶۸.۵٪
MMMU Pro
درک تصویر و نمودار
۸۷.۷٪
۸۶.۹٪
کدنویسی: کدام برای برنامهنویسها بهتر است؟
در Terminal-Bench 4.0 که کار عملی در ترمینال را میسنجد، دو مدل تقریباً برابرند (۵۹.۶ در برابر ۵۹.۱ درصد)، اما در SciCode فاصلهٔ Opus حدود ۱۰ واحد است. اگر میخواهید Claude را مستقیم در ترمینال برای کدنویسی به کار بگیرید، آموزش Claude Code را ببینید. برای مقایسهٔ گستردهتر ابزارها و مدلهای برنامهنویسی، بهترین هوش مصنوعی برای برنامهنویسی را ببینید.
دقت و توهم: برتری GPT-6 Astra
در بنچمارک AA-Omniscience، Opus 5.5 دقت بیشتری دارد (۶۶.۲٪ در برابر ۶۲.۶٪) و شاخص کلی آن هم بالاتر است (۴۶.۴ در برابر ۴۳.۴). اما نرخ توهم Astra کمتر است: Astra در ۵۱.۳٪ مواقعی که جواب را نمیداند پاسخ غلط میسازد و این عدد برای Opus ۵۸.۶٪ است. یعنی Opus بیشتر میداند، اما Astra وقتی نمیداند کمی صادقتر است. جزئیات این بنچمارک را در مقالهٔ توهم هوش مصنوعی توضیح دادهایم.
قیمت، هزینهٔ واقعی و سرعت
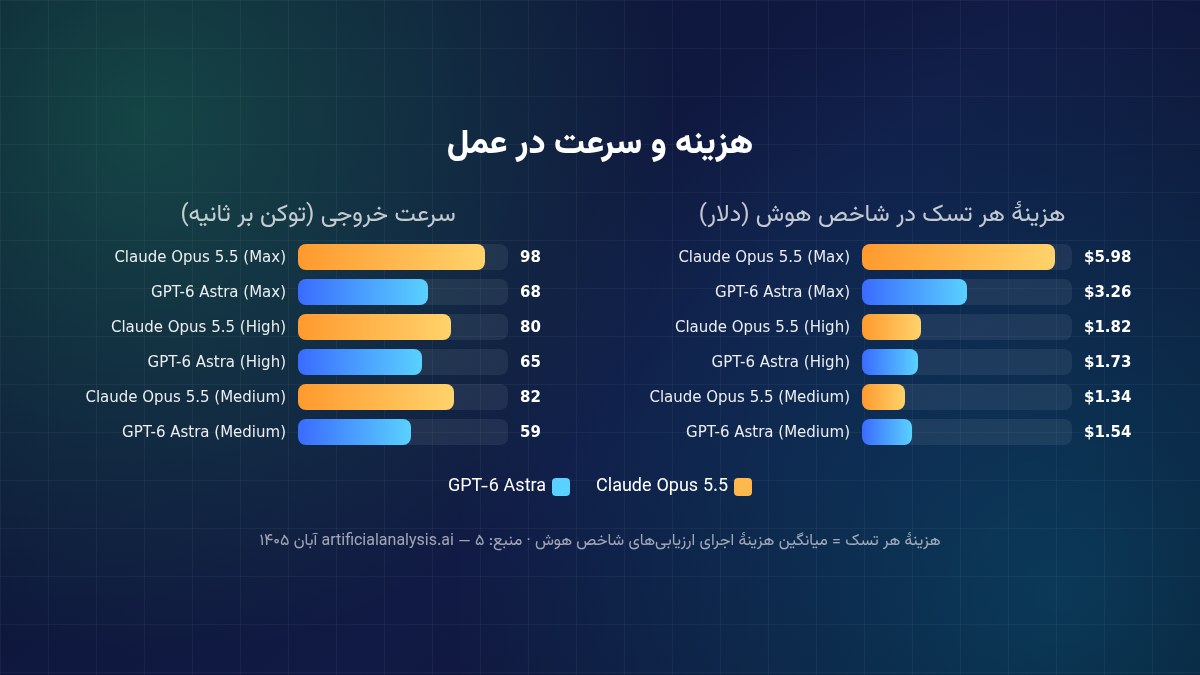
هزینهٔ هر تسک در ارزیابیهای شاخص هوش و سرعت خروجی دو مدل در سه سطح تلاش. منبع تصویر: تحریریه رادینو
قیمت هر توکن Opus 5.5 حدود ۲.۵ برابر ارزانتر از Astra است. اما «هزینهٔ واقعی» به تعداد توکنهایی هم بستگی دارد که مدل مصرف میکند. Artificial Analysis برای هر مدل «هزینهٔ هر تسک» را گزارش میکند؛ یعنی میانگین هزینهٔ اجرای ارزیابیهای شاخص هوش:
سطح تلاش
هزینهٔ هر تسک Opus 5.5
هزینهٔ هر تسک Astra
Max
۵.۹۸ دلار
۳.۲۶ دلار
High
۱.۸۲ دلار
۱.۷۳ دلار
Medium
۱.۳۴ دلار
۱.۵۴ دلار
Low
۰.۵۵ دلار
۰.۸۲ دلار
چرا Opus در سطح Max گرانتر تمام میشود؟ چون در این سطح خیلی بیشتر فکر میکند و توکن خروجی بیشتری تولید میکند. در سطح Medium (پیشفرض Opus) و Low، Opus ارزانتر است. برای مقایسهٔ کامل قیمت همهٔ مدلها، راهنمای قیمت API هوش مصنوعی را ببینید.
سرعت پاسخ
Opus 5.5 در تولید متن سریعتر است: حدود ۹۸ توکن بر ثانیه در سطح Max در برابر ۶۸ توکن بر ثانیه برای Astra. اما زمان انتظار تا شروع پاسخ موضوع دیگری است. در سطح Max، میانهٔ زمان تا اولین توکن پاسخ برای Opus حدود ۷۱۲ ثانیه و برای Astra حدود ۳۵۳ ثانیه است، چون زمان فکر کردن هم در آن حساب میشود. در سطح Medium این زمان برای Opus حدود ۱۸.۶ ثانیه و برای Astra حدود ۵.۸ ثانیه است. OpenAI برای Astra حالتهای Fast و Ultrafast را هم ارائه میکند که با هزینهٔ بیشتر، سرعت بالاتری میدهند.
کدام را انتخاب کنیم؟
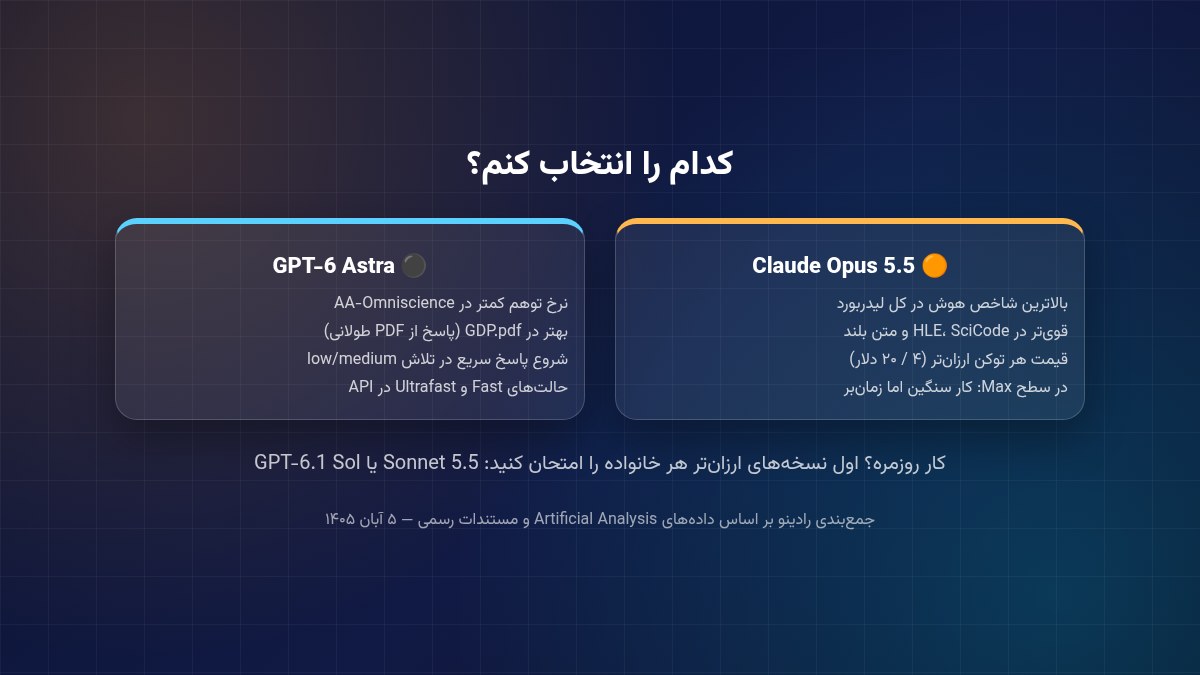
جمعبندی نقاط قوت هر مدل برای انتخاب سریع. منبع تصویر: تحریریه رادینو
کدنویسی ایجنتی، تحلیل علمی و سندهای خیلی بلند: Claude Opus 5.5؛ بالاترین شاخص هوش و برتری در HLE، SciCode و AA-LCR.
پاسخ از روی PDF و کارهایی که توهم در آنها پرهزینه است: GPT-6 Astra؛ نرخ توهم کمتر و نتیجهٔ بهتر در GDP.pdf.
بودجهٔ محدود با حجم زیاد: Opus 5.5 در سطح Medium یا Low ارزانتر است؛ اما برای کارهای روزمره، مدلهای ارزانتر هر خانواده یعنی Claude Sonnet 5.5 و GPT-6.1 Sol معمولاً کافیاند.
پاسخ سریع با تلاش کم: در سطح Low، Astra هم باهوشتر است و هم سریعتر شروع میکند.
بهترین روش این است که هر دو را روی چند نمونه از کار واقعی خودتان امتحان کنید. برای دیدن جایگاه این دو مدل در کنار Gemini، Grok و مدلهای چینی، رتبهبندی مدلهای هوش مصنوعی و برای آشنایی با بقیهٔ اعضای خانوادهٔ Claude، راهنمای مدلهای Claude را ببینید.
🎓 یادگیری عملی: برای اینکه از این مدلها در کار و کسبوکار خود درست استفاده کنید، دورهٔ کپسول هوش مصنوعی رادینو را ببینید.
سؤالات متداول
Claude Opus 5.5 قویتر است یا GPT-6 Astra؟
در شاخص هوش Artificial Analysis، Claude Opus 5.5 در سطح تلاش Max با ۵۷.۶ امتیاز از GPT-6 Astra با ۵۲.۷ امتیاز بالاتر است. در سطح تلاش Low اما Astra با ۴۵.۸ از Opus با ۴۲.۳ جلوتر است.
قیمت API Claude Opus 5.5 و GPT-6 Astra چقدر است؟
Claude Opus 5.5 برای هر میلیون توکن ۴ دلار ورودی و ۲۰ دلار خروجی و GPT-6 Astra ۱۰ دلار ورودی و ۵۰ دلار خروجی هزینه دارد. Batch API در هر دو سرویس ۵۰٪ ارزانتر است.
برای برنامهنویسی کدام بهتر است؟
در Terminal-Bench 4.0 دو مدل تقریباً برابرند (۵۹.۶٪ و ۵۹.۱٪)، اما Opus 5.5 در SciCode با ۶۶.۹٪ در برابر ۵۶.۵٪ جلوتر است.
کدام مدل کمتر توهم میزند؟
در AA-Omniscience نرخ توهم GPT-6 Astra (Max) برابر ۵۱.۳٪ و Claude Opus 5.5 (Max) برابر ۵۸.۶٪ است؛ یعنی Astra وقتی پاسخ را نمیداند کمتر جواب غلط میسازد، هرچند دقت کلی Opus بیشتر است.
کانتکست کدام مدل بزرگتر است؟
پنجرهٔ کانتکست GPT-6 Astra طبق مستندات OpenAI ۱٬۰۵۰٬۰۰۰ توکن و Claude Opus 5.5 یک میلیون توکن است. حداکثر خروجی هر دو ۱۲۸ هزار توکن است.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.