فرض کنید میخواهید یک چتبات بسازید که به سؤالهای مشتریها دربارهٔ محصولات، قیمتها و قوانین فروشگاه شما جواب بدهد. ChatGPT یا Claude هر چقدر هم باهوش باشند، اطلاعات داخلی شما را نمیدانند و اگر بپرسید، ممکن است جوابی از خودشان بسازند. راهحل استاندارد این مشکل RAG است.
در این مقاله ساده توضیح میدهیم RAG چیست، چطور کار میکند، چه تفاوتی با فاینتیون دارد، چه زمانی اصلاً به آن نیاز ندارید و چطور یک RAG دقیق بسازید. اگر تازه با مدلهای زبانی آشنا شدهاید، اول مقالهٔ توهم هوش مصنوعی را بخوانید؛ RAG یکی از مهمترین راههای کم کردن همین توهم است.
آخرین بهروزرسانی: ۵ آبان ۱۴۰۵ — بر اساس مقالهٔ اصلی RAG، پژوهش Contextual Retrieval شرکت Anthropic و مستندات رسمی OpenAI.
⚡ پاسخ کوتاه
RAG مخفف Retrieval-Augmented Generation یا «تولید افزوده با بازیابی» است. در این روش، قبل از اینکه مدل زبانی جواب بدهد، سیستم ابتدا در اسناد شما (مثلاً PDFها، صفحات سایت یا پایگاه دانش) جستوجو میکند، مرتبطترین تکهها را پیدا میکند و آنها را همراه سؤال به مدل میدهد. نتیجه: پاسخهایی بهروز، مبتنی بر منابع خودتان و قابل ارجاع. اصطلاح RAG در سال ۲۰۲۰ با مقالهای از Lewis و همکاران با عنوان «Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks» معرفی شد.
مدلهای زبانی بزرگ دو محدودیت مهم دارند: دانش آنها تا تاریخ مشخصی است (تاریخ قطع دانش) و اطلاعات خصوصی شما را ندیدهاند. RAG مثل این است که قبل از امتحان، کتاب را جلوی مدل باز کنید: مدل بهجای اتکا به حافظه، از روی متن پیدا شده جواب میدهد.
در مقالهٔ اصلی RAG، نویسندگان دو نوع حافظه را ترکیب کردند: حافظهٔ پارامتری یعنی دانشی که در وزنهای مدل ذخیره شده و حافظهٔ غیرپارامتری یعنی یک نمایهٔ برداری از ویکیپدیا که مدل میتواند در آن جستوجو کند. همین ترکیب هنوز اساس سیستمهای RAG امروزی است.
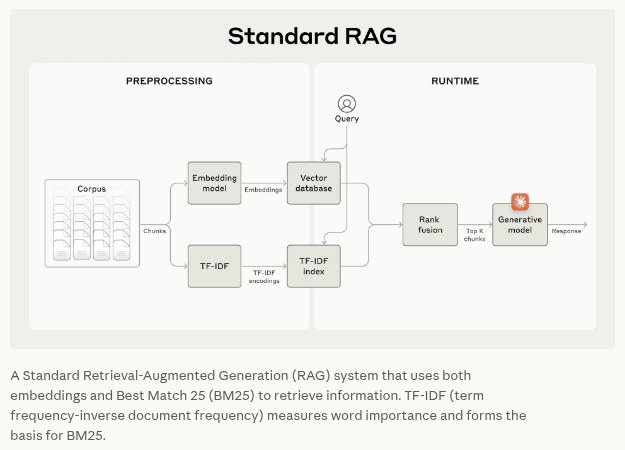
نمودار یک سیستم RAG استاندارد در پژوهش Contextual Retrieval شرکت Anthropic. منبع تصویر: Anthropic
RAG چطور کار میکند؟
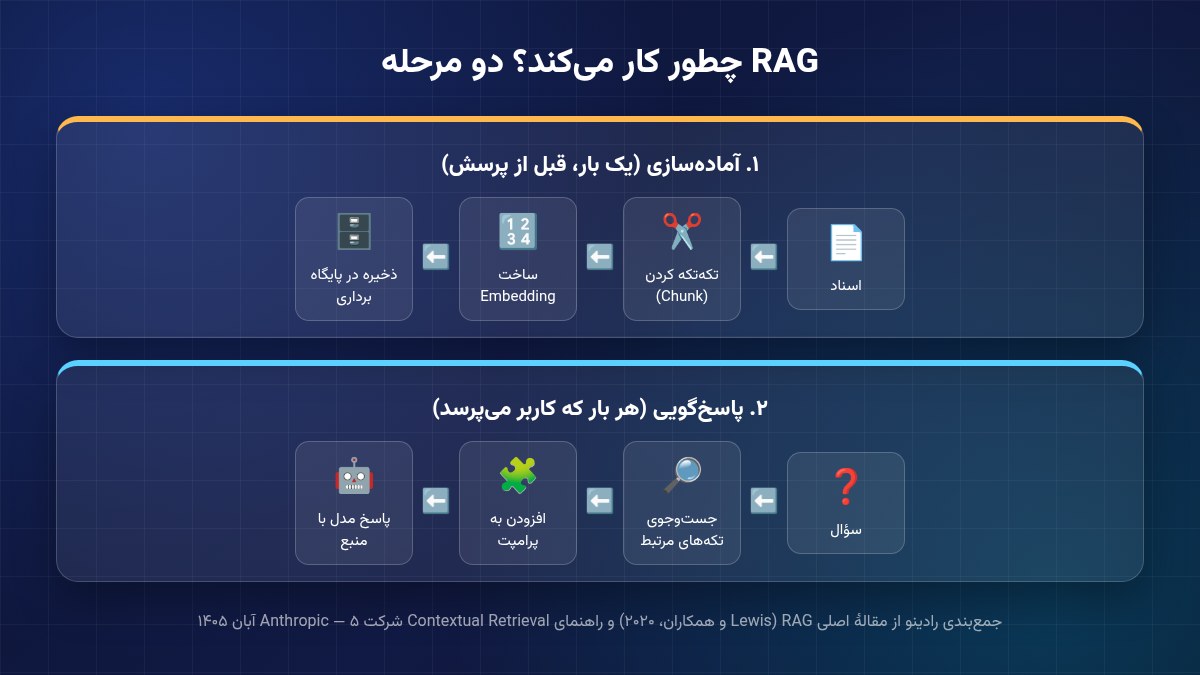
دو مرحلهٔ اصلی RAG: آمادهسازی اسناد و پاسخگویی به سؤال. منبع تصویر: تحریریه رادینو
هر سیستم RAG دو مرحلهٔ اصلی دارد:
مرحلهٔ ۱: آمادهسازی و نمایهسازی اسناد
تکهتکه کردن (Chunking): اسناد به تکههای کوچک تقسیم میشوند؛ به گفتهٔ Anthropic معمولاً هر تکه حداکثر چند صد توکن است.
ساخت Embedding: هر تکه با یک مدل Embedding به یک بردار عددی تبدیل میشود که معنای آن را نشان میدهد.
ذخیره در پایگاه داده برداری: بردارها در یک Vector Database ذخیره میشوند تا بعداً بتوان سریع در آنها جستوجو کرد.
مرحلهٔ ۲: بازیابی و تولید پاسخ
سؤال کاربر هم به بردار تبدیل میشود.
سیستم نزدیکترین تکهها از نظر معنایی را پیدا میکند (مثلاً ۵ یا ۲۰ تکهٔ اول).
این تکهها همراه سؤال در پرامپت قرار میگیرند.
مدل زبانی با تکیه بر همین متنها جواب میدهد و میتواند منبع را هم ذکر کند.
اجزای اصلی یک سیستم RAG
Embedding و مدلهای آن
Embedding یک بردار عددی است که معنای متن را نشان میدهد؛ متنهای هممعنی بردارهای نزدیک به هم دارند. برای مثال، طبق مستندات OpenAI:
مدل
طول بردار پیشفرض
حداکثر ورودی
امتیاز MTEB
صفحه به ازای هر دلار (تقریبی)
text-embedding-3-small
۱۵۳۶
۸۱۹۲ توکن
۶۲.۳٪
۶۲٬۵۰۰
text-embedding-3-large
۳۰۷۲
۸۱۹۲ توکن
۶۴.۶٪
۹٬۶۱۵
این مدلها پارامتر dimensions هم دارند که با آن میتوان طول بردار را کوتاه کرد و در ازای کمی افت دقت، در فضای ذخیرهسازی صرفهجویی کرد.
پایگاه داده برداری (Vector Database)
بردارها باید جایی ذخیره شوند که جستوجوی شباهت روی آنها سریع باشد. اگر از PostgreSQL استفاده میکنید، افزونهٔ متنباز pgvector جستوجوی دقیق و تقریبی نزدیکترین همسایه را با نمایههای HNSW و IVFFlat به خود Postgres اضافه میکند. سرویسهای آماده هم وجود دارند؛ مثلاً Vector Store در OpenAI که فایلها را خودکار تکهتکه، Embedding و نمایه میکند. اگر سایت شما با جنگو ساخته شده، مقالهٔ مدلها در جنگو برای درک لایهٔ داده مفید است.
بازیاب (Retriever) و رتبهبندی دوباره (Reranking)
بازیاب تکههای مرتبط را پیدا میکند. جستوجوی معنایی (با Embedding) گاهی کلمات دقیق مثل کد محصول یا اسم خاص را از دست میدهد؛ برای همین بسیاری از سیستمها آن را با جستوجوی کلیدواژهای مثل BM25 ترکیب میکنند (Hybrid Search). OpenAI هم در Retrieval API جستوجوی ترکیبی با روش Reciprocal Rank Fusion، آستانهٔ امتیاز (score_threshold)، فیلتر بر اساس ویژگیها و بازنویسی خودکار سؤال را ارائه میکند. در آخر، یک مدل Reranker نتایج را دوباره مرتب میکند تا بهترینها بالا بیایند.
Contextual Retrieval؛ RAG دقیقتر
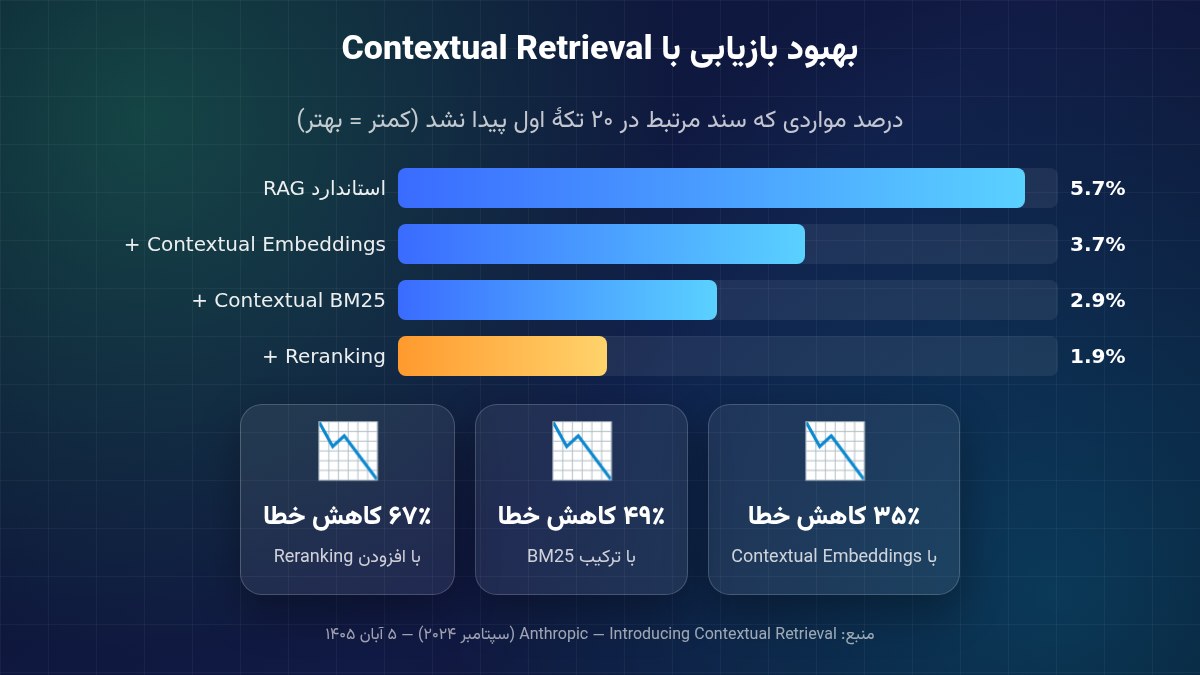
درصد شکست بازیابی در ۲۰ تکهٔ اول با روشهای مختلف؛ دادهها از Anthropic. منبع تصویر: تحریریه رادینو
یکی از مشکلات RAG این است که وقتی سند را تکهتکه میکنیم، هر تکه زمینهٔ خود را از دست میدهد. مثلاً جملهٔ «درآمد شرکت ۳٪ رشد کرد» معلوم نمیکند کدام شرکت و کدام فصل. Anthropic در پژوهشی با عنوان Contextual Retrieval پیشنهاد داد قبل از Embedding، یک توضیح کوتاه مخصوص هر تکه (معمولاً ۵۰ تا ۱۰۰ توکن) با کمک مدل زبانی تولید و به ابتدای آن اضافه شود. نتایج گزارششده:
روش
نرخ شکست بازیابی (۲۰ تکهٔ اول)
کاهش خطا
RAG استاندارد با Embedding
۵.۷٪
—
Contextual Embeddings
۳.۷٪
۳۵٪
Contextual Embeddings + Contextual BM25
۲.۹٪
۴۹٪
همان ترکیب + Reranking
۱.۹٪
۶۷٪
طبق برآورد Anthropic با فرضهای مشخص (تکههای ۸۰۰ توکنی و اسناد ۸ هزار توکنی)، هزینهٔ یکبارهٔ تولید این توضیحات حدود ۱.۰۲ دلار برای هر میلیون توکن سند است.
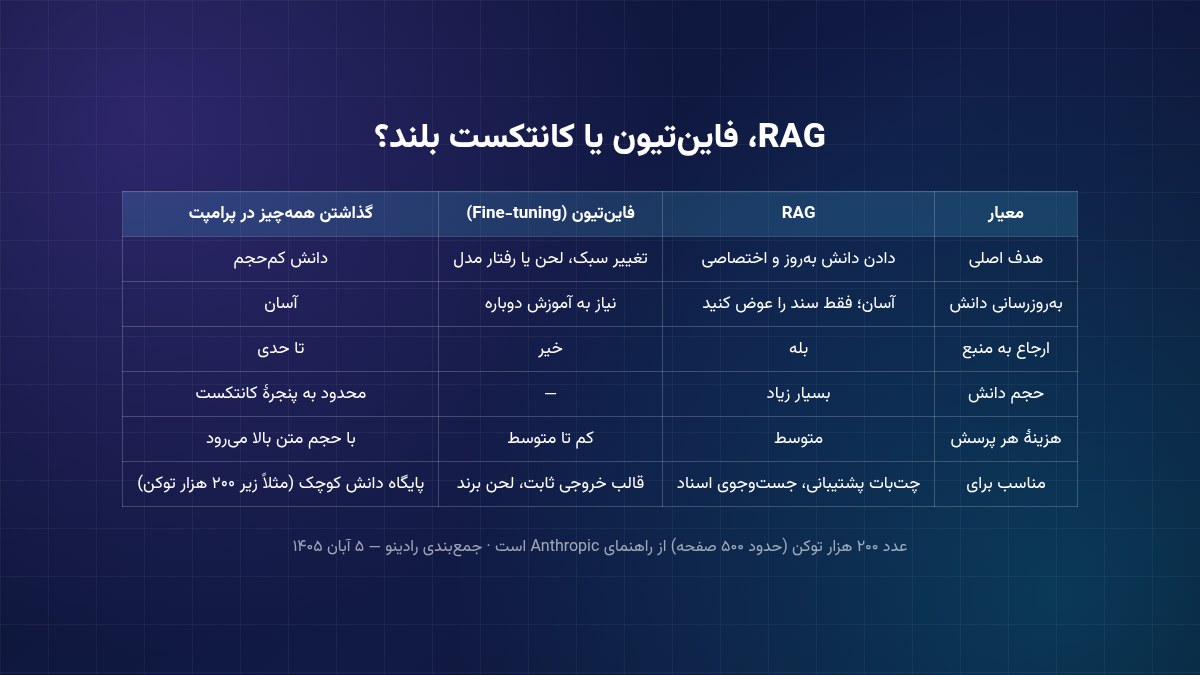
RAG، فاینتیون یا کانتکست بلند؟
مقایسهٔ سه روش دادن دانش به مدل زبانی. منبع تصویر: تحریریه رادینو
RAG تنها راه نیست. فاینتیون بیشتر برای تغییر سبک، لحن و قالب خروجی مدل مناسب است تا اضافه کردن دانش جدید، و هر بار که اطلاعات عوض شود باید دوباره انجام شود. از طرف دیگر، مدلهای امروزی کانتکست بسیار بزرگی دارند؛ مثلاً مدلهای Claude و GPT-6 حدود یک میلیون توکن.
Anthropic توصیهٔ سادهای دارد: اگر پایگاه دانش شما کمتر از ۲۰۰ هزار توکن (حدود ۵۰۰ صفحه) است، میتوانید کل آن را در پرامپت بگذارید و اصلاً به RAG نیاز ندارید. با کش پرامپت (Prompt Caching)، تأخیر بیش از ۲ برابر کمتر و هزینه تا ۹۰٪ کمتر میشود. RAG وقتی ضروری میشود که حجم اسناد زیاد باشد، دائم تغییر کند یا لازم باشد منبع هر جواب مشخص شود.
ساخت RAG با ابزارهای آماده
برای شروع لازم نیست همهچیز را از صفر بسازید. OpenAI ابزار File Search را در Responses API ارائه میکند: فایلها را در یک Vector Store بارگذاری میکنید و مدل خودش جستوجو و پاسخ میدهد. طبق مستندات، فایلها بهطور پیشفرض به تکههای ۸۰۰ توکنی با ۴۰۰ توکن همپوشانی تقسیم میشوند، تا ۱ گیگابایت ذخیرهسازی رایگان است و بیشتر از آن روزانه ۰.۱۰ دلار برای هر گیگابایت هزینه دارد. نمونهٔ ساده بر اساس مستندات OpenAI:
from openai import OpenAI

client = OpenAI()

# 1) Create a vector store and add an uploaded file
vector_store = client.vector_stores.create(name="knowledge_base")
client.vector_stores.files.create(
    vector_store_id=vector_store.id,
    file_id=file_id,  # ID of a file uploaded with client.files.create
)

# 2) Ask a question with the file_search tool
response = client.responses.create(
    model="gpt-6.1-sol",
    input="What is the return policy?",
    tools=[{
        "type": "file_search",
        "vector_store_ids": [vector_store.id],
        "max_num_results": 5,
    }],
)
print(response.output_text)
اگر میخواهید مدل علاوه بر اسناد، به ابزارها و پایگاههای داده هم دسترسی داشته باشد، مقالهٔ MCP چیست و برای ساخت ایجنتهایی که خودشان تصمیم میگیرند کی جستوجو کنند، معرفی ایجنتهای هوش مصنوعی را بخوانید. برای کدنویسی سریعتر این پروژهها هم آموزش Claude Code به کارتان میآید.
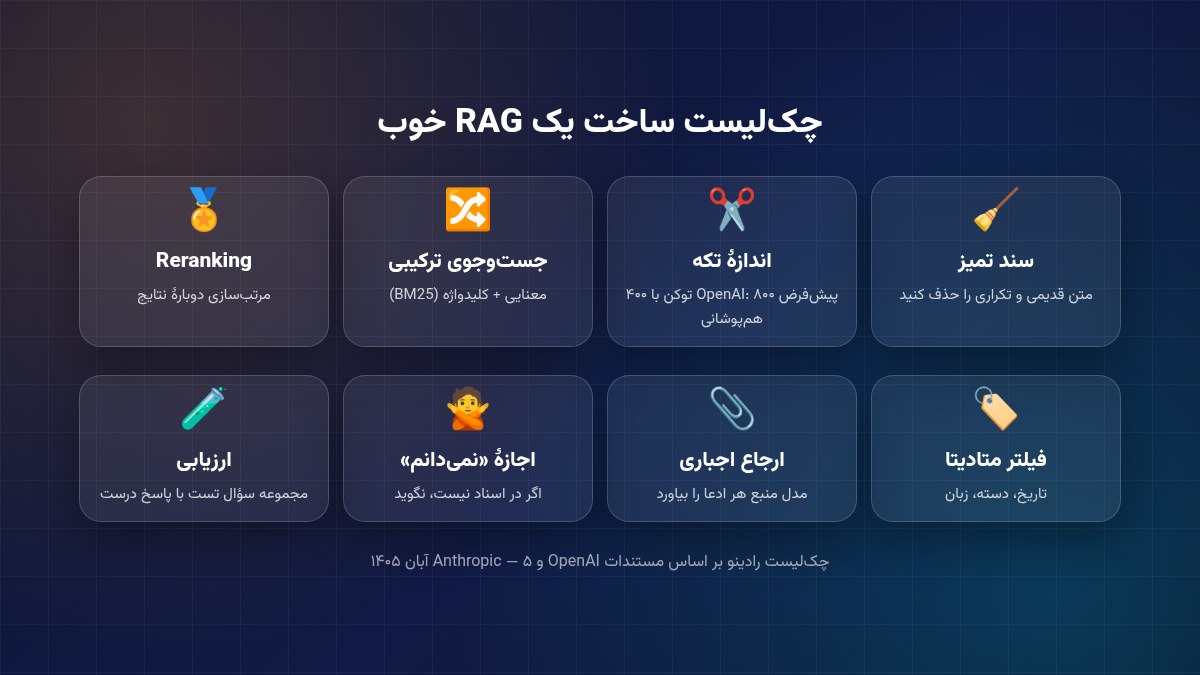
چکلیست ساخت یک RAG خوب
هشت نکتهٔ کلیدی برای ساخت یک سیستم RAG دقیق. منبع تصویر: تحریریه رادینو
اسناد تمیز: متنهای قدیمی، تکراری و متناقض را قبل از نمایهسازی حذف کنید.
اندازهٔ مناسب تکه: تکههای خیلی بزرگ دقت را پایین میآورند و تکههای خیلی کوچک زمینه را از دست میدهند؛ چند اندازه را تست کنید.
جستوجوی ترکیبی: معنایی + کلیدواژهای، بهخصوص برای اسامی خاص و کدها.
Reranking: در نتایج Anthropic، افزودن Reranking خطای بازیابی را از ۲.۹٪ به ۱.۹٪ رساند.
متادیتا: تاریخ، دسته و زبان سند را ذخیره کنید تا بتوانید فیلتر کنید.
ارجاع به منبع: از مدل بخواهید برای هر ادعا منبع بیاورد.
اجازهٔ «نمیدانم»: در پرامپت بگویید اگر جواب در اسناد نیست، حدس نزند.
ارزیابی: یک مجموعه سؤال با جواب درست بسازید و بعد از هر تغییر، دقت را بسنجید.
RAG یا Retrieval-Augmented Generation روشی است که در آن قبل از پاسخ مدل زبانی، مرتبطترین بخشهای اسناد شما جستوجو و همراه سؤال به مدل داده میشود تا پاسخ بر اساس اطلاعات واقعی و بهروز باشد.
آیا RAG توهم هوش مصنوعی را از بین میبرد؟
بهطور کامل نه، اما آن را کاهش میدهد؛ چون مدل از روی متن واقعی جواب میدهد. کیفیت بازیابی، پرامپت مناسب و اجازه دادن به مدل برای گفتن «نمیدانم» هم مهم است.
تفاوت RAG و فاینتیون چیست؟
RAG دانش را هنگام پرسش از اسناد بیرونی به مدل میدهد و با عوض کردن سند بهروز میشود؛ فاینتیون وزنهای مدل را با آموزش تغییر میدهد و بیشتر برای سبک و قالب خروجی مناسب است.
چه زمانی به RAG نیاز نداریم؟
طبق راهنمای Anthropic، اگر پایگاه دانش کمتر از ۲۰۰ هزار توکن (حدود ۵۰۰ صفحه) باشد، میتوان کل آن را در پرامپت گذاشت و با کش پرامپت هزینه و تأخیر را کم کرد.
Vector Database چیست؟
پایگاه دادهای است که بردارهای Embedding را ذخیره میکند و جستوجوی سریع بر اساس شباهت معنایی را ممکن میکند؛ مثل pgvector برای PostgreSQL یا Vector Store در OpenAI.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.