از ChatGPT میپرسید فلان قانون مالیاتی چه میگوید و پاسخی دقیق، مرتب و با اعتمادبهنفس کامل میگیرید؛ با شمارهٔ ماده و حتی تاریخ تصویب. فقط یک مشکل وجود دارد: چنین مادهای اصلاً وجود ندارد. به این پدیده توهم هوش مصنوعی یا Hallucination میگویند و یکی از جدیترین محدودیتهای مدلهای زبانی امروز است.
در این مقاله توضیح میدهیم توهم دقیقاً چیست، چرا اتفاق میافتد، چطور اندازهگیری میشود و بر اساس جدیدترین دادههای بنچمارک AA-Omniscience، کدام مدلها کمتر توهم میزنند. در پایان هم هفت روش عملی برای کاهش آن ارائه میدهیم. اگر با بنچمارکها آشنا نیستید، راهنمای بنچمارکهای هوش مصنوعی را ببینید.
آخرین بهروزرسانی: ۴ آبان ۱۴۰۵ — اعداد از جدول زندهٔ بنچمارک AA-Omniscience در سایت Artificial Analysis برداشته شدهاند.
⚡ پاسخ کوتاه
توهم هوش مصنوعی یعنی مدل زبانی اطلاعات نادرست یا ساختگی را با اطمینان بهعنوان واقعیت ارائه کند. دلیل اصلی این است که مدلها «محتملترین ادامهٔ متن» را تولید میکنند، نه لزوماً درستترین را، و در آموزش برای حدس زدن بیشتر از گفتن «نمیدانم» پاداش گرفتهاند. در بنچمارک AA-Omniscience، در میان مدلهای پرچمدار Gemini 4 Argon (High) با ۱۵.۱٪ کمترین نرخ توهم را دارد و Claude Opus 5.5 با شاخص ۴۶.۴ بهترین تعادل بین دانش و پرهیز از توهم را نشان میدهد. برای کاهش توهم، منبع بدهید، اجازهٔ «نمیدانم» بدهید و پاسخهای حساس را بررسی کنید.
توهم هوش مصنوعی یعنی چه؟
در ادبیات تخصصی، توهم به خروجیای گفته میشود که «روان و قانعکننده» است اما با واقعیت یا با منبعی که به مدل داده شده مطابقت ندارد. مقالهٔ مروری مشهور Huang و همکاران (arXiv:2311.05232) توهم را به دو دستهٔ اصلی تقسیم میکند:
- توهم واقعیتی (Factuality): پاسخ با واقعیتهای جهان نمیخواند؛ مثلاً نسبت دادن یک کتاب به نویسندهٔ اشتباه یا ساختن آمار و منبع.
- توهم وفاداری (Faithfulness): پاسخ با دستور کاربر یا متنی که در اختیار مدل قرار گرفته سازگار نیست؛ مثلاً خلاصهای که جملهای را اضافه میکند که در متن اصلی نبود.
نمونههای رایج توهم: ارجاع به مقاله یا لینکی که وجود ندارد، عدد و آمار ساختگی، نقلقول جعلی از افراد واقعی، و توضیح دربارهٔ تابع یا کتابخانهای در برنامهنویسی که هرگز ساخته نشده است. خطر اصلی اینجاست که لحن پاسخ غلط هیچ فرقی با پاسخ درست ندارد. این یکی از دلایلی است که در بررسی خطرهای هوش مصنوعی هم به آن پرداختهایم.
چرا مدلها توهم میزنند؟
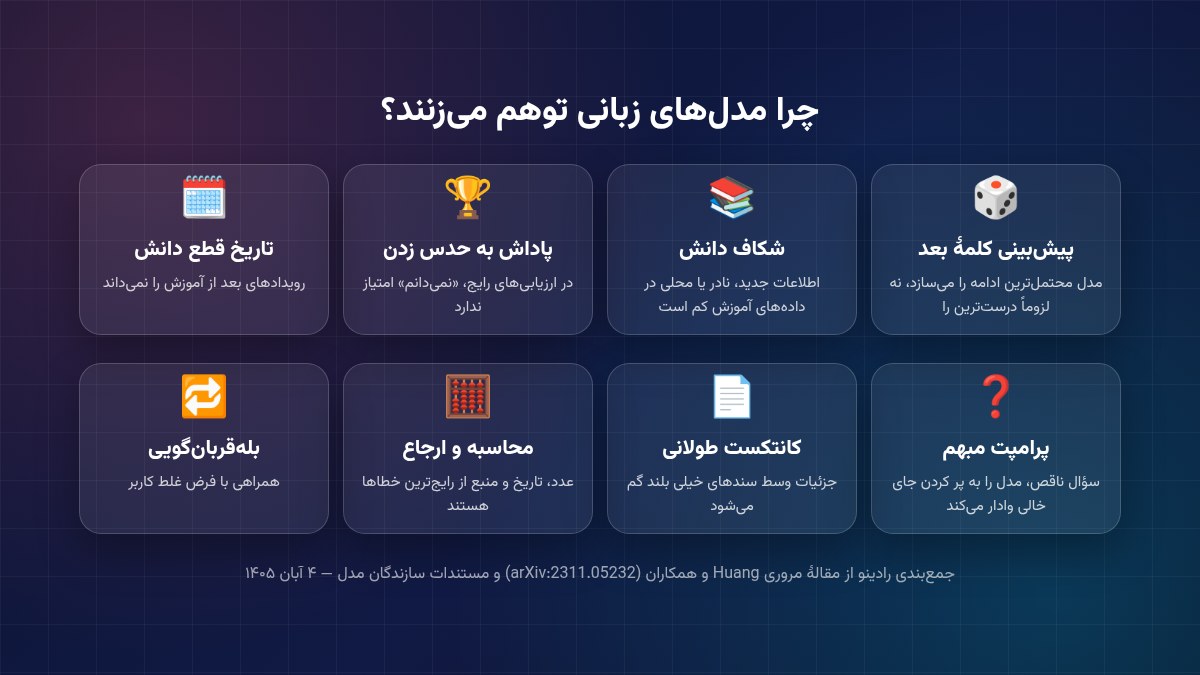
هشت دلیل رایج توهم در مدلهای زبانی؛ جمعبندی رادینو از مقالهٔ مروری Huang و همکاران. منبع تصویر: تحریریه رادینو
مدل زبانی بزرگ در اصل یک پیشبین بسیار پیشرفتهٔ «کلمهٔ بعدی» است. او یاد گرفته چه متنی معمولاً بعد از چه متنی میآید. وقتی دربارهٔ موضوعی اطلاعات کافی در دادههای آموزش نداشته باشد، باز هم متنی تولید میکند که «شبیه» پاسخ درست است. مهمترین دلایل:
- شکاف دانش: اطلاعات جدید، نادر یا محلی (مثلاً قوانین ایران یا شرکتهای کوچک) در دادههای آموزش کم است.
- تاریخ قطع دانش: مدل از رویدادهای بعد از پایان آموزش خبر ندارد، اما ممکن است دربارهٔ آنها حدس بزند.
- پاداش به حدس زدن: مقالهٔ «Why Language Models Hallucinate» از پژوهشگران OpenAI (arXiv:2509.04664) توضیح میدهد که بسیاری از روشهای ارزیابی فقط پاسخ درست را میشمارند و برای «نمیدانم» امتیازی نمیدهند؛ پس مدل یاد میگیرد حدس بزند، مثل دانشآموزی که در تست بدون نمرهٔ منفی همهٔ گزینهها را پر میکند.
- پرامپت مبهم یا القایی: سؤالی که پیشفرض غلط دارد («چرا انیشتین جایزهٔ نوبل شیمی گرفت؟») مدل را به همراهی وادار میکند.
- عدد، تاریخ و ارجاع: جزئیات دقیق، بهخصوص لینک و شمارهٔ صفحه، از رایجترین نقاط خطا هستند.
- کانتکست طولانی: در سندهای خیلی بلند ممکن است جزئیات میانی گم شود.
جالب است بدانید مدلهای استدلالی که قبل از پاسخ «فکر» میکنند، در بسیاری از کارها دقیقترند، اما لزوماً توهم کمتری ندارند. دربارهٔ این مدلها در راهنمای مدلهای استدلالی نوشتهایم.
AA-Omniscience: توهم را چطور اندازه میگیرند؟
بیشتر بنچمارکها فقط درصد پاسخ درست را میسنجند و برای پاسخ غلط و «نمیدانم» فرقی قائل نیستند. AA-Omniscience که شرکت مستقل Artificial Analysis ساخته، دقیقاً برای حل همین مشکل طراحی شده است. طبق مقالهٔ رسمی آن (arXiv:2511.13029):
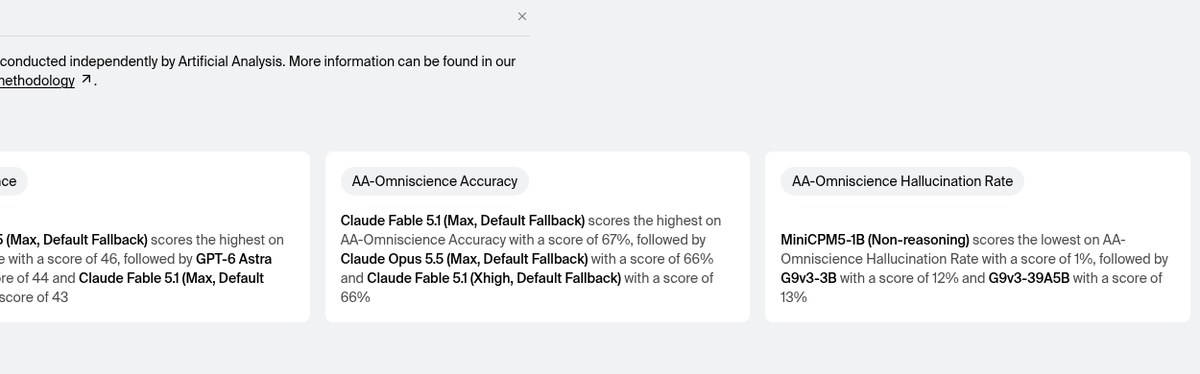
صفحهٔ بنچمارک دانش و توهم AA-Omniscience در سایت Artificial Analysis. منبع تصویر: Artificial Analysis
- شامل ۶٬۰۰۰ سؤال در ۴۲ موضوع اقتصادی مهم در شش حوزه است: کسبوکار، علوم انسانی و اجتماعی، علوم و مهندسی و ریاضی، سلامت، حقوق، و مهندسی نرمافزار.
- سؤالها از منابع معتبر دانشگاهی و صنعتی استخراج شدهاند.
- سه معیار اصلی گزارش میشود: شاخص Omniscience، دقت و نرخ توهم.
| معیار |
تعریف |
بهتر است |
| شاخص AA-Omniscience |
پاسخ درست را پاداش و پاسخ غلط را جریمه میکند؛ «نمیدانم» جریمه ندارد. بازه از ۱۰۰- تا ۱۰۰؛ صفر یعنی تعداد پاسخ درست و غلط برابر است |
بالاتر |
| دقت (Accuracy) |
درصد پاسخهای درست از کل سؤالها، چه مدل پاسخ داده باشد چه نه |
بالاتر |
| نرخ توهم |
پاسخ غلط ÷ (غلط + ناقص + بدون پاسخ)؛ یعنی وقتی مدل جواب را نمیداند، چقدر بهجای «نمیدانم» پاسخ غلط میدهد |
پایینتر |
برای آشنایی کامل با این سایت و شاخصهایش، راهنمای Artificial Analysis را بخوانید.
کدام مدل کمتر توهم میزند؟
نمودار زیر نرخ توهم مدلهای شناختهشده را در AA-Omniscience نشان میدهد (اعداد در تاریخ ۴ آبان ۱۴۰۵ از جدول زندهٔ سایت برداشته شدهاند):
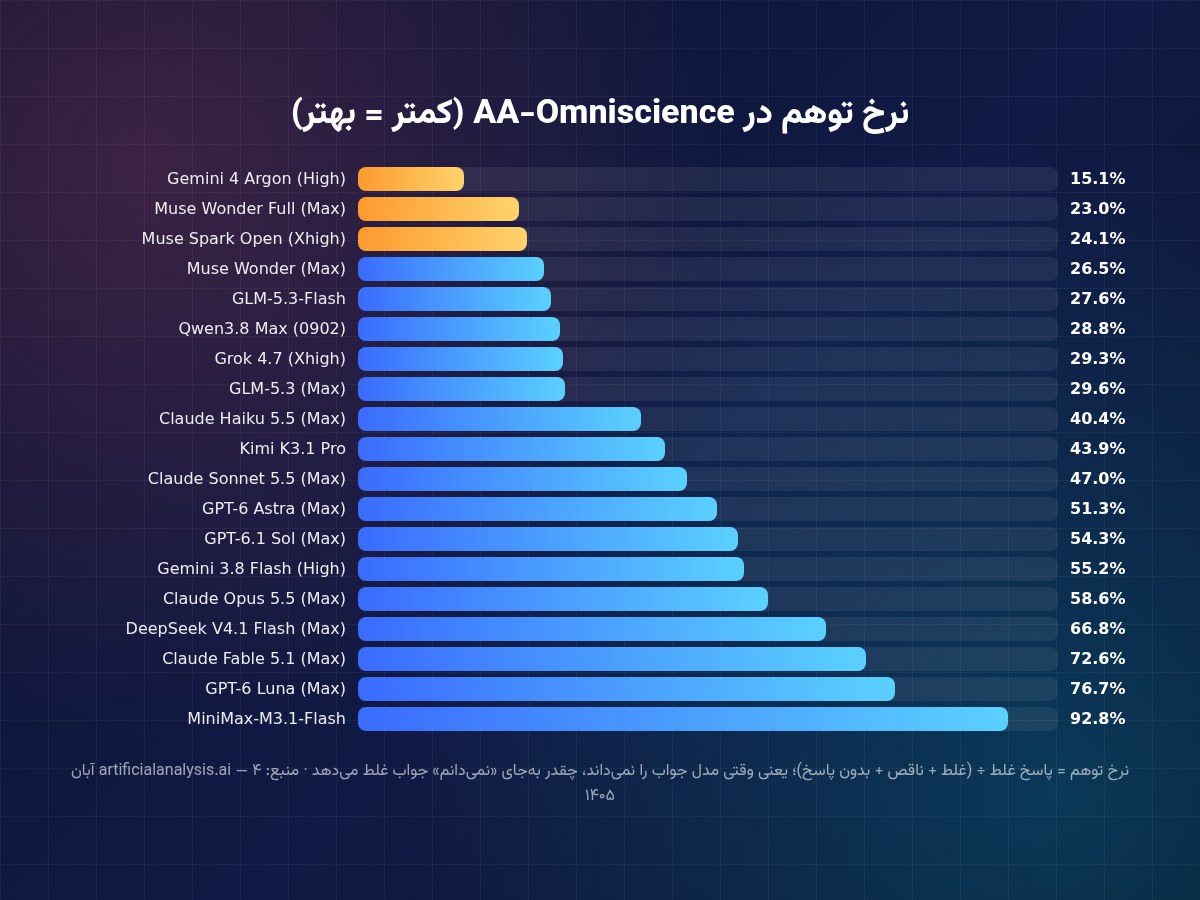
نرخ توهم مدلهای مطرح در AA-Omniscience؛ عدد کمتر یعنی مدل وقتی جواب را نمیداند، کمتر پاسخ غلط میسازد. منبع تصویر: تحریریه رادینو
| مدل |
نرخ توهم |
وضعیت |
| Gemini 4 Argon (High) |
۱۵.۱٪ |
کمترین در میان پرچمدارها |
| Muse Wonder Full (Max) |
۲۳.۰٪ |
بسیار خوب |
| Grok 4.7 (Xhigh) |
۲۹.۳٪ |
خوب |
| Claude Haiku 5.5 (Max) |
۴۰.۴٪ |
متوسط |
| Kimi K3.1 Pro |
۴۳.۹٪ |
متوسط |
| Claude Sonnet 5.5 (Max) |
۴۷.۰٪ |
متوسط |
| GPT-6 Astra (Max) |
۵۱.۳٪ |
متوسط |
| Claude Opus 5.5 (Max) |
۵۸.۶٪ |
بالا |
| Claude Fable 5.1 (Max) |
۷۲.۶٪ |
بالا |
| GPT-6 Luna (Max) |
۷۶.۷٪ |
خیلی بالا |
| MiniMax-M3.1-Flash |
۹۲.۸٪ |
خیلی بالا |
یک نکته در این جدول مهم است: در کل فهرست سایت، کمترین نرخ توهم متعلق به مدل کوچک MiniCPM5-1B با حدود ۱٪ است. دلیلش این نیست که این مدل خیلی باهوش است؛ بلکه تقریباً به هر سؤالی که نمیداند، پاسخ نمیدهد. به همین دلیل نرخ توهم را باید همیشه کنار دقت و شاخص کلی دید.
دقت در برابر صداقت
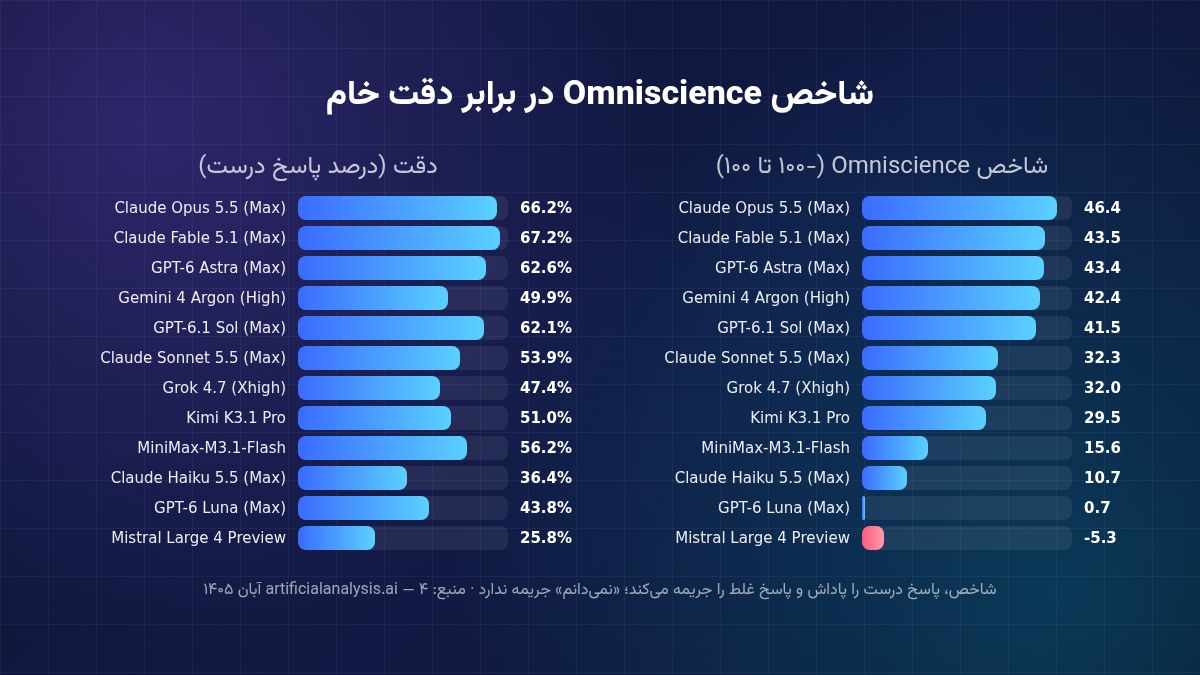
مقایسهٔ شاخص Omniscience (که توهم را جریمه میکند) با دقت خام مدلها. منبع تصویر: تحریریه رادینو
این نمودار نکتهٔ جالبی را نشان میدهد. Claude Fable 5.1 بالاترین دقت را دارد (۶۷.۲٪)، یعنی بیشترین پاسخ درست؛ اما چون وقتی نمیداند هم زیاد حدس میزند (نرخ توهم ۷۲.۶٪)، در شاخص Omniscience (۴۳.۵) از Claude Opus 5.5 (۴۶.۴) عقب میماند. در مقابل، Gemini 4 Argon با دقت کمتر (۴۹.۹٪) ولی نرخ توهم بسیار پایین، به شاخص ۴۲.۴ میرسد.
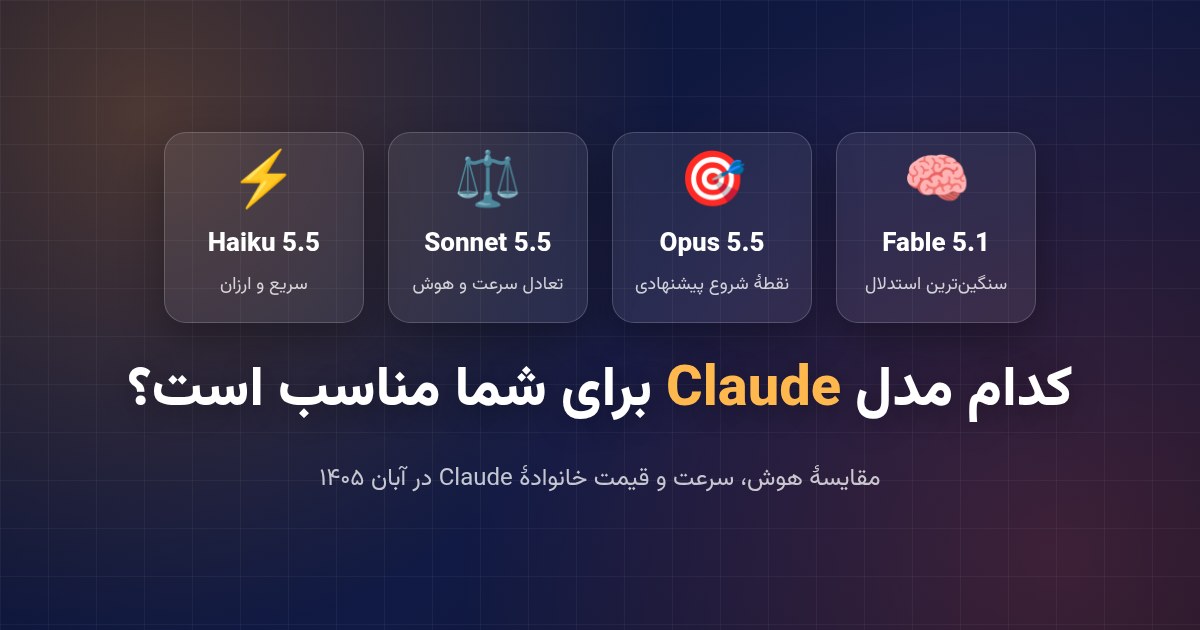
نتیجهٔ عملی: «مدلی که بیشتر میداند» با «مدلی که کمتر دروغ میگوید» یکی نیست. اگر کار شما حساس است (پزشکی، حقوقی، مالی)، مدلی که بیشتر «نمیدانم» میگوید ممکن است ارزشمندتر باشد. برای مقایسهٔ مدلهای Claude از این زاویه، راهنمای انتخاب مدلهای Claude و برای رتبهبندی کلی رتبهبندی مدلهای هوش مصنوعی را ببینید. نتایج مدلهای چینی مثل Kimi را هم در بنچمارکهای Kimi K3.1 Pro بررسی کردهایم.
حوزهها با هم فرق دارند
مقالهٔ AA-Omniscience تأکید میکند که عملکرد مدلها در حوزههای مختلف متفاوت است و در شش حوزه، مدلهایی از سه آزمایشگاه مختلف پیشتاز بودهاند. پیشنهاد نویسندگان این است که برای کارهای دانشمحور، مدل را بر اساس نیاز همان حوزه انتخاب کنید، نه فقط بر اساس امتیاز کلی.
آیا توهم همیشه بد است؟
همان سازوکاری که باعث توهم میشود، منبع خلاقیت مدل هم هست. وقتی از مدل میخواهید داستان، شعر، شعار تبلیغاتی یا ایدهٔ نام برند بسازد، دقیقاً میخواهید چیزی «تولید» کند که قبلاً وجود نداشته است. مشکل فقط زمانی پیش میآید که خروجی خیالی بهجای واقعیت ارائه شود یا کاربر آن را واقعیت فرض کند. پس قاعدهٔ ساده این است: در کارهای خلاقانه آزادی بدهید، اما در هر کاری که با واقعیت، عدد، قانون، سلامت یا پول سروکار دارد، مدل را به منبع ببندید و خروجی را بررسی کنید. این تفکیک را در سیاستهای داخلی تیمتان هم مشخص کنید تا همه بدانند خروجی کدام ابزار و برای چه کاری نیاز به بازبینی دارد.
روشهای کاهش توهم
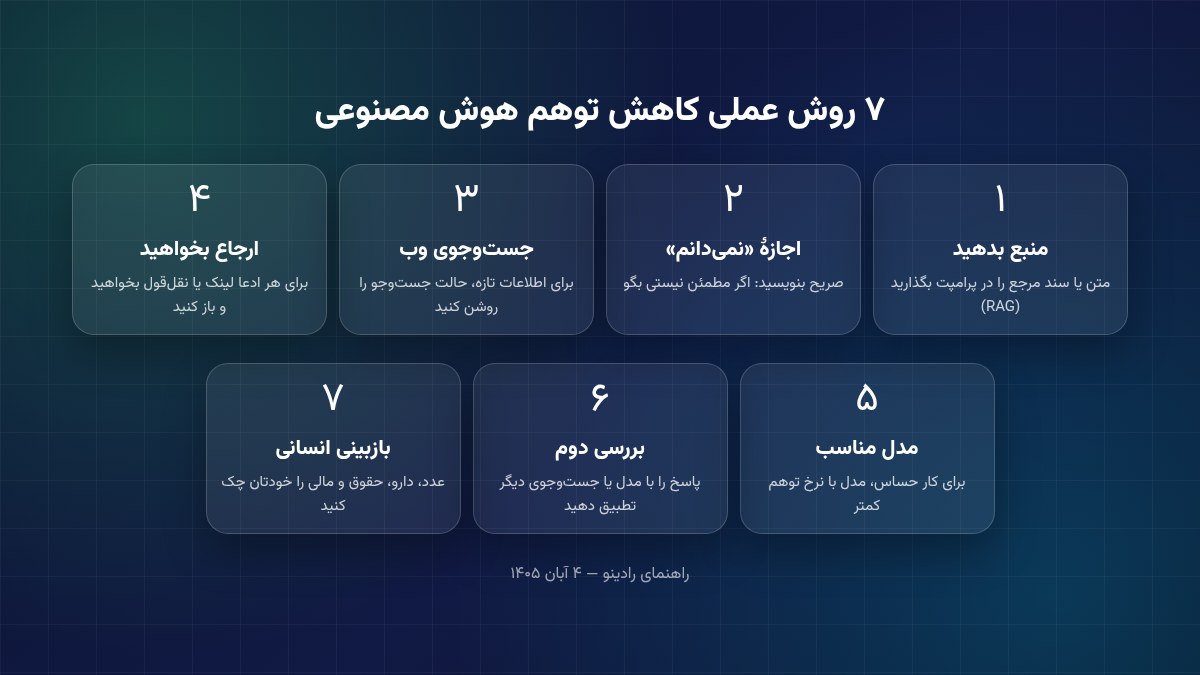
هفت روش عملی برای کاهش توهم در کار روزمره با چتباتها و مدلهای زبانی. منبع تصویر: تحریریه رادینو
- منبع بدهید (RAG): متن یا سند مرجع را در پرامپت بگذارید و بخواهید فقط بر اساس همان پاسخ دهد. این مؤثرترین روش است.
- اجازهٔ «نمیدانم» بدهید: صریح بنویسید «اگر مطمئن نیستی، بگو نمیدانم». مدلها به این دستور واکنش نشان میدهند.
- جستوجوی وب را روشن کنید: برای اطلاعات تازه، از حالت جستوجو استفاده کنید تا مدل به منابع روز دسترسی داشته باشد.
- ارجاع بخواهید و باز کنید: برای هر ادعای مهم لینک یا نقلقول بخواهید و خودتان آن را باز کنید؛ لینک ساختگی رایج است.
- مدل مناسب انتخاب کنید: برای کار حساس، مدلی با نرخ توهم کمتر یا شاخص Omniscience بالاتر.
- بررسی دوم: پاسخ را با یک مدل دیگر یا یک جستوجوی مستقل تطبیق دهید.
- بازبینی انسانی: عدد، دارو، حقوق و مسائل مالی را همیشه خودتان چک کنید.
یک پرامپت نمونه که چند روش را با هم ترکیب میکند:
فقط بر اساس متن زیر پاسخ بده. اگر پاسخ در متن نیست، بنویس «در متن نیامده».
برای هر ادعا، جملهای از متن را که از آن استفاده کردی نقل کن.
[متن مرجع]
سؤال: ...
اگر در سایت یا کسبوکارتان از محتوای تولیدشده با هوش مصنوعی استفاده میکنید، بازبینی انسانی برای سئو و اعتبار برند هم حیاتی است؛ تولید محتوای مفید و قابل اعتماد را ببینید. اگر هم ایجنتها را به دادههای واقعی سازمان وصل میکنید، استاندارد MCP راهی برای دادن منبع درست به مدل است؛ و در برنامهنویسی با ابزارهایی مثل Claude Code، اجرای تست بهترین سد در برابر کد توهمی است.
سؤالات متداول
توهم هوش مصنوعی چیست؟
توهم (Hallucination) یعنی مدل زبانی اطلاعات نادرست یا ساختگی، مثل آمار، منبع یا نقلقول جعلی، را با اطمینان بهعنوان واقعیت ارائه کند.
چرا ChatGPT اطلاعات غلط میدهد؟
چون مدلهای زبانی محتملترین ادامهٔ متن را تولید میکنند و در آموزش و ارزیابی برای حدس زدن بیشتر از گفتن «نمیدانم» پاداش گرفتهاند. کمبود داده دربارهٔ موضوعات نادر یا جدید و پرامپت مبهم هم احتمال خطا را بالا میبرد.
کدام مدل هوش مصنوعی کمتر توهم میزند؟
در بنچمارک AA-Omniscience و در میان مدلهای پرچمدار، Gemini 4 Argon (High) با ۱۵.۱٪ کمترین نرخ توهم را دارد. Claude Opus 5.5 با شاخص ۴۶.۴ بالاترین امتیاز Omniscience، یعنی بهترین تعادل بین دانش و پرهیز از پاسخ غلط، را دارد.
نرخ توهم در AA-Omniscience چطور محاسبه میشود؟
نرخ توهم برابر است با تعداد پاسخهای غلط تقسیم بر مجموع پاسخهای غلط، ناقص و بدون پاسخ؛ یعنی وقتی مدل جواب درست را نمیداند، چند درصد مواقع بهجای «نمیدانم» پاسخ غلط میدهد.
چطور توهم هوش مصنوعی را کاهش دهیم؟
متن مرجع در پرامپت بگذارید، صریحاً اجازهٔ «نمیدانم» بدهید، جستوجوی وب را روشن کنید، برای ادعاها منبع بخواهید و آن را باز کنید، و اطلاعات حساس را خودتان بررسی کنید.
منابع و مراجع





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.