Grok 4.7 تازهترین مدل پرچمدار خانوادهٔ Grok است که ۳۰ شهریور ۱۴۰۵ (۲۱ سپتامبر ۲۰۲۶) معرفی شد. سازندهاش همان xAI است که از بهمن ۱۴۰۴ به SpaceX پیوسته و حالا در سایت رسمی با نام SpaceXSI (SpaceX Super Intelligence) شناخته میشود. شعار معرفی این مدل هم جسورانه است: «دو برابر سریعتر، با نصف قیمت مدلهای همرده».
اما این ادعا در عمل چقدر درست است؟ در این مقاله میبینیم Grok 4.7 چه تغییراتی کرده، در بنچمارکهای خود سازنده و آزمونهای مستقل چه نمرهای گرفته، چقدر هزینه دارد و در برابر GPT-6، Claude Opus 5.5 و Gemini 4 کجا میایستد. اگر با خود گروک تازه آشنا شدهاید، اول مقالهٔ آشنایی با هوش مصنوعی گروک را بخوانید.
آخرین بهروزرسانی: ۷ آبان ۱۴۰۵ — اعداد بنچمارک، قیمت و سرعت از صفحهٔ معرفی Grok 4.7، مستندات API و لیدربورد مستقل Artificial Analysis در همین تاریخ برداشته شدهاند.
⚡ پاسخ کوتاه
Grok 4.7 مدل اصلی xAI برای کدنویسی و کارهای دانشی است: پنجرهٔ متنی ۵۰۰ هزار توکنی، قیمت ۲ دلار ورودی و ۶ دلار خروجی برای هر میلیون توکن و سرعت حدود ۱۰۶ توکن بر ثانیه دارد. در شاخص هوش مستقل Artificial Analysis امتیاز ۳۵ گرفته؛ یعنی از Gemini 4 Carbon (۵۹.۴)، Claude Opus 5.5 (۵۸.۴) و GPT-6 Astra (۵۶.۹) خیلی عقبتر است. نقطهٔ قوتش قیمت پایین، توهم کم، کار با اکسل و داده و کار اداری چندساعته است، نه کدنویسی سنگین در ترمینال.
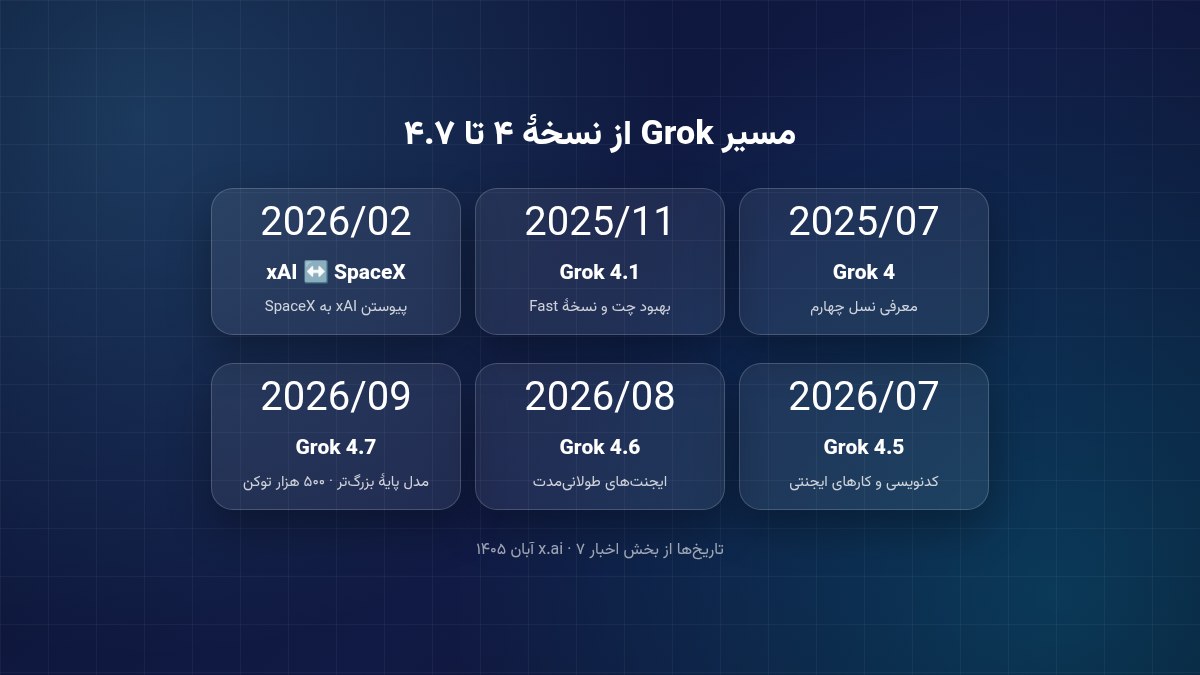
مسیر نسخههای Grok از Grok 4 در تیر ۱۴۰۴ تا Grok 4.7 در شهریور ۱۴۰۵. منبع تصویر: تحریریه رادینو
xAI در یک سال گذشته با سرعت زیادی نسخه داده است: Grok 4 در تیر ۱۴۰۴، Grok 4.1 در آبان ۱۴۰۴، Grok 4.5 در تیر ۱۴۰۵، Grok 4.6 در مرداد و حالا Grok 4.7 در شهریور ۱۴۰۵. طبق صفحهٔ معرفی، مهمترین تغییرات Grok 4.7 اینهاست:
مدل پایهٔ جدید و بزرگتر نسبت به Grok 4.6، با دورهٔ طولانیتر یادگیری تقویتی روی کارهایی که چند ساعت طول میکشند.
بررسی بهتر کار خودش و مدیریت بهتر متنهای طولانی.
ساخت بهتر سند و ارائه و بهبود در کارهای حرفهای مثل کار وکلا، پرستارها و تحلیلگران مالی.
سامانهٔ ایمنی کاملاً جدید؛ xAI میگوید در آزمون ایمنی زیستی LatchBio با ۶۲.۴٪ اول است و در بنچمارک داخلی HackerBench فقط ۳.۳٪ از درخواستهای پرخطر سایبری از فیلترش عبور میکنند.
همان قیمت و سرعت Grok 4.6، بهعلاوهٔ یک نسخهٔ سریع با دو برابر سرعت خروجی و دو برابر قیمت.
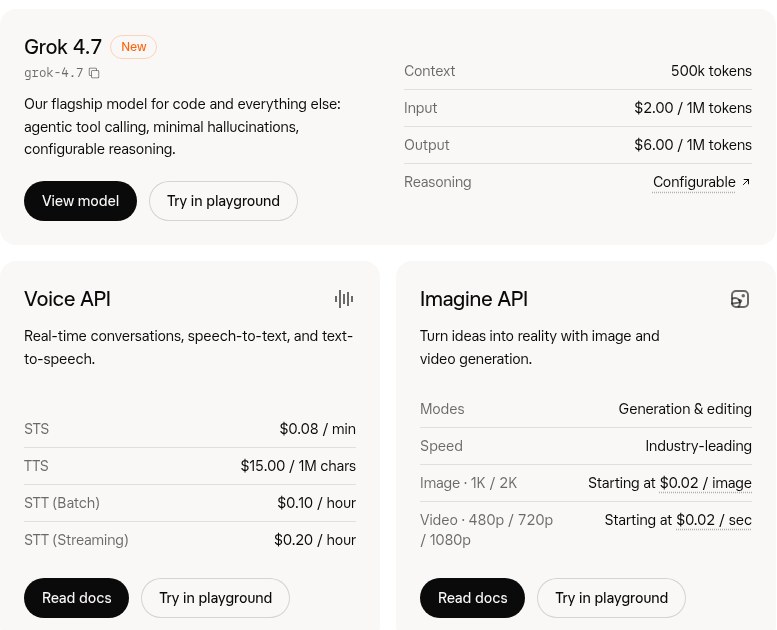
کارت Grok 4.7 در مستندات API؛ پنجرهٔ متنی ۵۰۰ هزار توکن و قیمت ۲ و ۶ دلار. منبع تصویر: xAI (SpaceXSI)
قیمت، سرعت و پنجرهٔ متنی Grok 4.7
طبق مستندات رسمی API، Grok 4.7 پنجرهٔ متنی ۵۰۰ هزار توکنی دارد و دانشش تا مه ۲۰۲۶ (حدود اردیبهشت ۱۴۰۵) بهروز است. قیمتگذاری آن دوپلهای است:
حجم درخواست
ورودی (هر ۱ میلیون توکن)
ورودی کششده
خروجی
کمتر از ۲۰۰ هزار توکن
۲ دلار
۰.۵ دلار
۶ دلار
۲۰۰ هزار توکن و بیشتر
۴ دلار
۱ دلار
۱۲ دلار
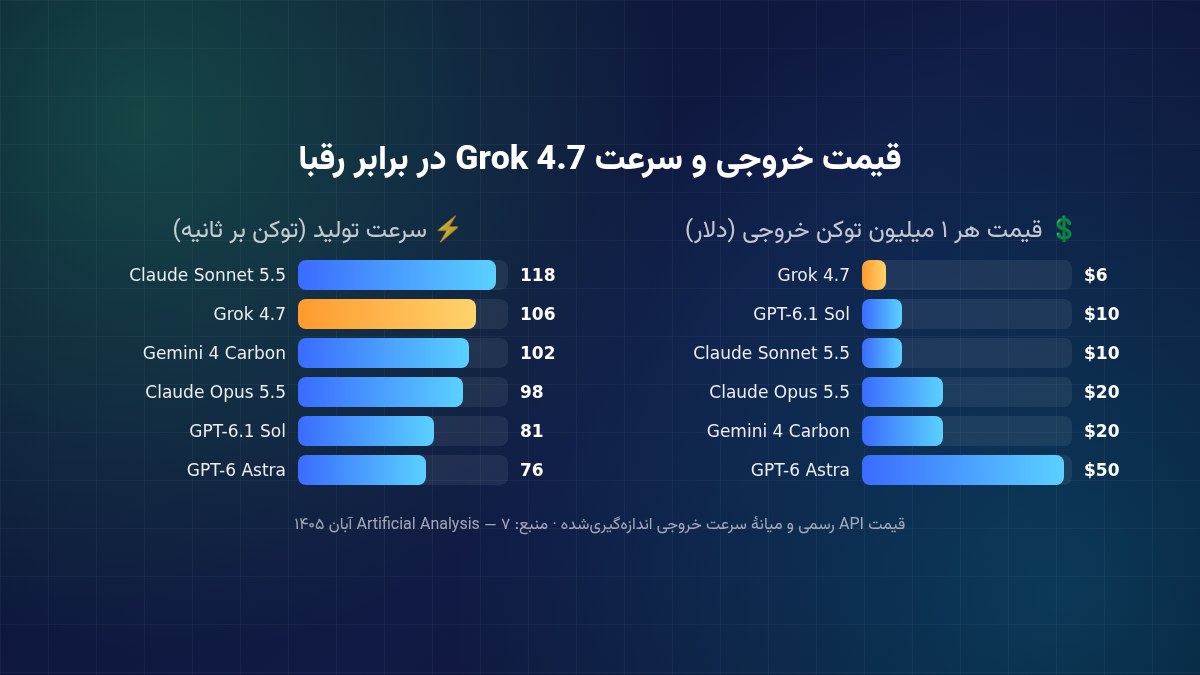
این قیمت در میان مدلهای پرچمدار واقعاً پایین است. برای مقایسه، قیمت خروجی Claude Opus 5.5 و Gemini 4 Carbon برای هر میلیون توکن ۲۰ دلار و GPT-6 Astra ۵۰ دلار است. اگر میخواهید هزینهٔ همهٔ مدلها را کنار هم ببینید، مقالهٔ مقایسهٔ قیمت API مدلهای هوش مصنوعی را بخوانید.
قیمت خروجی و سرعت تولید Grok 4.7 در کنار مدلهای رقیب. منبع تصویر: تحریریه رادینو
از نظر سرعت، Artificial Analysis میانهٔ سرعت خروجی Grok 4.7 (high) را حدود ۱۰۶ توکن بر ثانیه اندازه گرفته؛ سریعتر از Claude Opus 5.5 (۹۸) و GPT-6 Astra (۷۶) و کمی کندتر از Claude Sonnet 5.5 (۱۱۸). اما چون مدل استدلالی است و قبل از پاسخ فکر میکند، زمان رسیدن اولین توکن پاسخ در اندازهگیری AA حدود ۲۰ ثانیه است. یعنی برای چت سریع و کوتاه، تجربهاش آنقدرها «فوری» نیست. فرق سرعت تولید و زمان اولین توکن را در مقالهٔ سرعت مدلهای هوش مصنوعی توضیح دادهایم.
هزینهٔ واقعی؛ قیمت توکن همهچیز نیست
قیمت هر توکن فقط نیمی از ماجراست؛ مدلی که بیشتر فکر کند توکن بیشتری مصرف میکند. Artificial Analysis هزینهٔ اجرای کل آزمونهایش را بهازای هر تسک حساب کرده است: Grok 4.7 (high) حدود ۶.۱۸ دلار، GPT-6 Astra حدود ۶.۲۴، Gemini 4 Carbon حدود ۷.۷۶ و Claude Opus 5.5 حدود ۱۰.۰۴ دلار. پس با وجود قیمت توکن خیلی پایینتر، هزینهٔ نهایی Grok 4.7 در این آزمونها تقریباً هماندازهٔ GPT-6 Astra است و GPT-6.1 Sol با حدود ۱.۲۷ دلار از همه بهصرفهتر درآمده است.
بنچمارکها؛ ادعای xAI در برابر آزمون مستقل
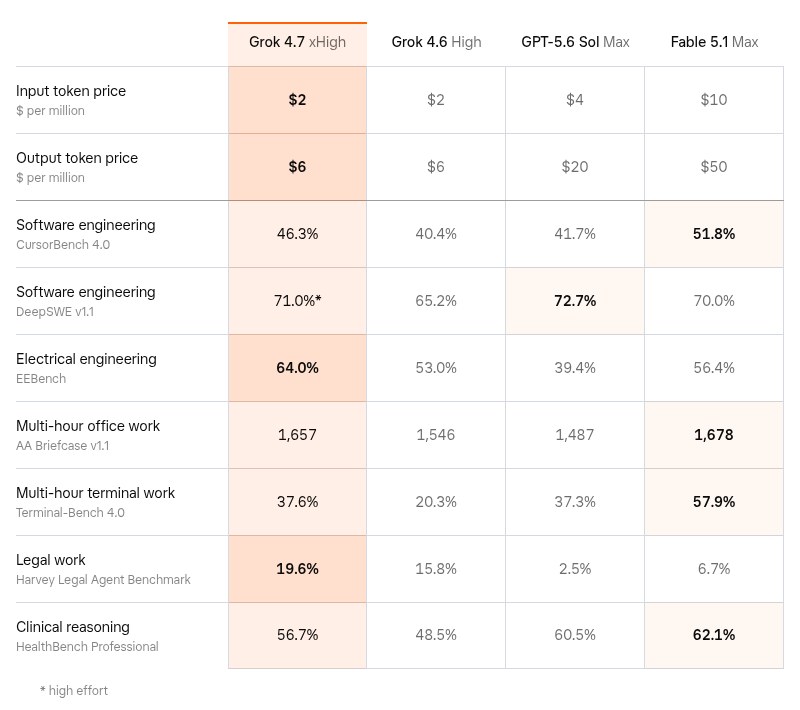
xAI در صفحهٔ معرفی، Grok 4.7 را با Grok 4.6، GPT-5.6 Sol و Fable 5.1 مقایسه کرده است. نکتهٔ جالب این است که رقبای انتخابشده نسخههای جدیدتر مثل GPT-6 و Claude Opus 5.5 نیستند:
جدول بنچمارکهای اعلامشده توسط سازنده در صفحهٔ معرفی Grok 4.7. منبع تصویر: xAI (SpaceXSI)
در این جدول Grok 4.7 در مهندسی برق (EEBench با ۶۴٪) و کار حقوقی (Harvey با ۱۹.۶٪) اول است، در CursorBench 4.0 با ۴۶.۳٪ و در Terminal-Bench 4.0 با ۳۷.۶٪ پشت Fable 5.1 میماند. در آزمون GDPval هم امتیاز Elo آن ۱۶۹۵ اعلام شده که از GPT-6 Astra (۱۵۴۲) بالاتر و از Fable 5.1 (۱۷۳۵) پایینتر است.
⚠️ اختلاف عدد سازنده و آزمون مستقل: xAI نمرهٔ Terminal-Bench 4.0 را برای نسخهٔ xHigh برابر ۳۷.۶٪ اعلام کرده، اما Artificial Analysis در اجرای مستقل خودش برای Grok 4.7 (high) به ۲۴.۷٪ رسیده است. تفاوت تنظیمات و محیط اجرا میتواند دلیلش باشد، ولی همین مثال نشان میدهد چرا نباید فقط به جدول سازندهها تکیه کرد.
جایگاه Grok 4.7 در شاخص هوش Artificial Analysis
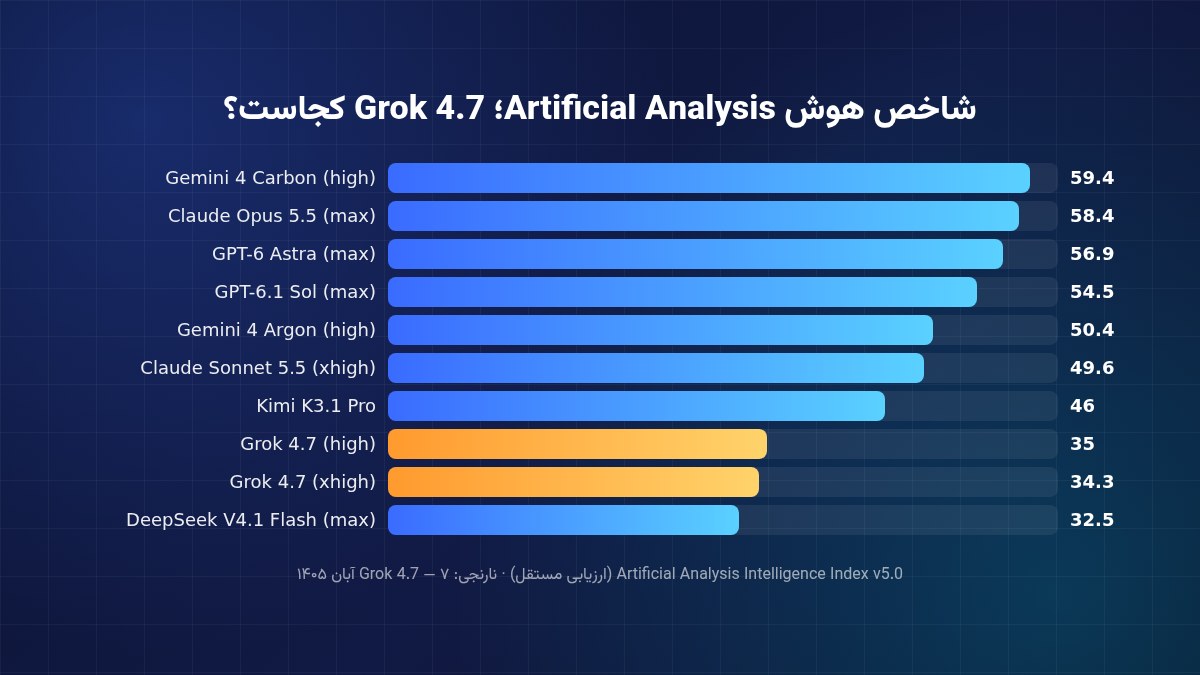
شاخص هوش Artificial Analysis (نسخهٔ ۵)؛ Grok 4.7 با فاصلهٔ زیاد پشت مدلهای پرچمدار است. منبع تصویر: تحریریه رادینو
شاخص هوش Artificial Analysis ترکیبی از مجموعهای از آزمونهای سخت در کدنویسی، استدلال، دانش و کار ایجنتی است. در این شاخص Grok 4.7 (high) امتیاز ۳۵ و نسخهٔ xhigh امتیاز ۳۴.۳ گرفتهاند؛ پایینتر از Kimi K3.1 Pro (۴۶) و Claude Sonnet 5.5 (۴۹.۶) و تنها کمی بالاتر از DeepSeek V4.1 Flash (۳۲.۵). این عددها مربوط به نسخهٔ ۵.۰ شاخصاند و مقیاس آن با نسخههای قبلی فرق دارد؛ پس با عددهای نسخههای قبلی شاخص که در مقالههای قدیمیتر میبینید قابل مقایسه نیستند و فقط جایگاه نسبی مدلها مهم است. برای دیدن جدول کامل، رتبهبندی مدلهای هوش مصنوعی را ببینید.
کجا قوی است و کجا ضعیف؟
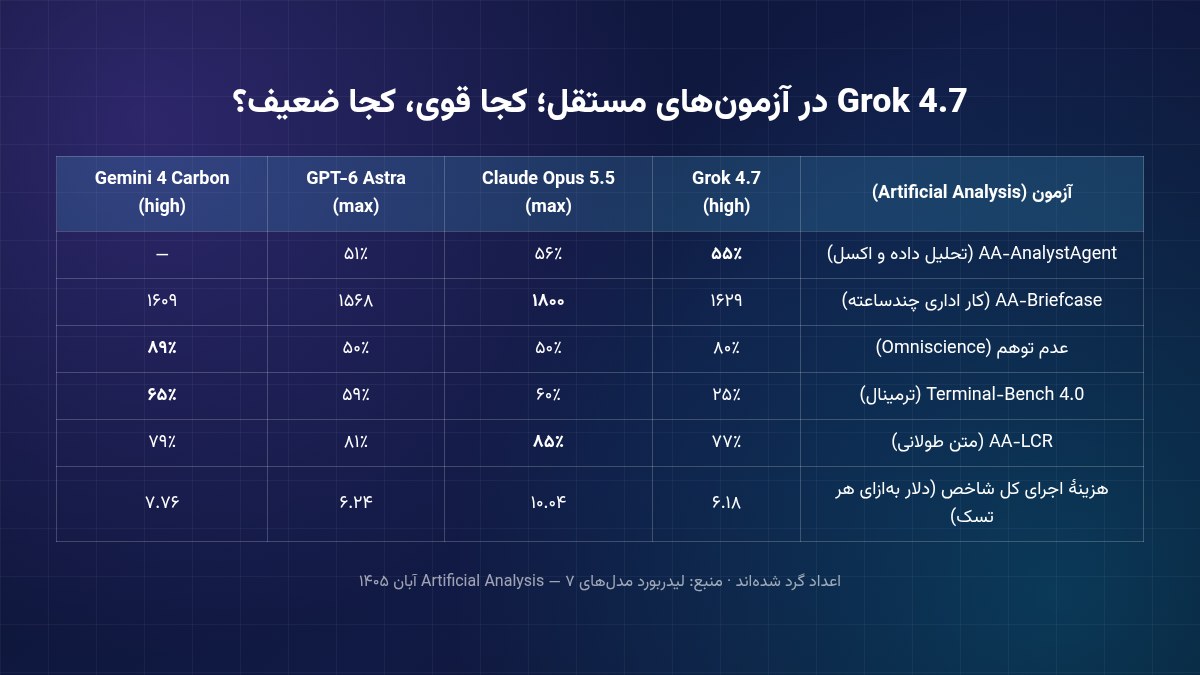
نمرهٔ Grok 4.7 در چند آزمون مستقل Artificial Analysis در کنار رقبا. منبع تصویر: تحریریه رادینو
عدد کلی همهٔ داستان را نمیگوید. Grok 4.7 در چند حوزه واقعاً رقابتی است:
تحلیل داده و اکسل: در آزمون AA-AnalystAgent با ۵۵٪ تقریباً همسطح Claude Opus 5.5 (۵۶.۲۵٪) و بالاتر از GPT-6 Astra (۵۱.۲۵٪) است.
توهم کمتر: در آزمون Omniscience حدود ۸۰٪ نرخ عدم توهم دارد؛ یعنی وقتی جواب را نمیداند، کمتر از رقبای OpenAI و Anthropic جواب ساختگی میدهد. البته Gemini 4 Carbon با حدود ۸۹٪ بهتر است.
کار اداری چندساعته: امتیاز ۱۶۲۹ در AA-Briefcase، بالاتر از GPT-6 Astra و Gemini 4 Carbon و پایینتر از Claude Opus 5.5.
در مقابل، نقطهٔ ضعف اصلیاش کار طولانی در ترمینال و کدنویسی ایجنتی است؛ با ۲۴.۷٪ در Terminal-Bench 4.0، فاصلهٔ زیادی با Claude Opus 5.5 و Gemini 4 Carbon (حدود ۶۰ تا ۶۵٪) دارد. در درک متن طولانی (AA-LCR) هم با ۷۷٪ پشت Claude Opus 5.5 است.
Grok 4.7 در برابر GPT و Claude
ویژگی
Grok 4.7 (high)
Claude Opus 5.5 (max)
GPT-6 Astra (max)
شاخص هوش AA
۳۵
۵۸.۴
۵۶.۹
قیمت ورودی / خروجی (دلار در میلیون توکن)
۲ / ۶
۴ / ۲۰
۱۰ / ۵۰
هزینه بهازای هر تسک در آزمون AA
۶.۱۸ دلار
۱۰.۰۴ دلار
۶.۲۴ دلار
سرعت خروجی (توکن بر ثانیه)
۱۰۶
۹۸
۷۶
پنجرهٔ متنی
۵۰۰ هزار
۱ میلیون
۱ میلیون
جمعبندی ساده این است: اگر قویترین مدل را برای کدنویسی پیچیده یا استدلال سخت میخواهید، Claude Opus 5.5 یا GPT-6 هنوز انتخاب بهتریاند؛ مقایسهٔ این دو را در مقالهٔ Claude Opus در برابر GPT-6 و معرفی نسخههای GPT را در مقالهٔ مدلهای GPT-6 ببینید. اما اگر روی کارهای اداری، اکسل، اسناد و حجم بالای درخواست با بودجهٔ محدود کار میکنید، Grok 4.7 گزینهٔ ارزان و قابلقبولی است.
کجا میتوان از Grok 4.7 استفاده کرد؟
طبق صفحهٔ معرفی، Grok 4.7 در Grok Build، ویرایشگر Cursor، API رسمی و پلتفرمهای ابری و روترهای مدل در دسترس است. اپ و سایت Grok و افزونههای Grok برای Excel و Google Workspace هم بخشی از اکوسیستم این شرکتاند. دسترسی از ایران معمولاً با محدودیت تحریم و پرداخت ارزی همراه است؛ پس پیش از برنامهریزی برای استفادهٔ کاری، شرایط دسترسی را بررسی کنید.
اگر میخواهید یاد بگیرید از این مدلها در کارهای روزمره درست استفاده کنید، دورهٔ کپسول هوش مصنوعی رادینو نقطهٔ شروع خوبی است.
سؤالات متداول
Grok 4.7 چه زمانی منتشر شد؟
صفحهٔ معرفی رسمی Grok 4.7 تاریخ ۲۱ سپتامبر ۲۰۲۶ (۳۰ شهریور ۱۴۰۵) را نشان میدهد.
قیمت API گروک ۴.۷ چقدر است؟
برای درخواستهای کمتر از ۲۰۰ هزار توکن، ۲ دلار برای هر میلیون توکن ورودی و ۶ دلار برای خروجی؛ برای درخواستهای بزرگتر قیمت دو برابر میشود. ورودی کششده ۰.۵ دلار است.
پنجرهٔ متنی Grok 4.7 چقدر است؟
طبق مستندات API، ۵۰۰ هزار توکن؛ نصف یک میلیون توکنی که Claude Opus 5.5، Gemini 4 و GPT-6 Astra دارند.
Grok 4.7 بهتر است یا ChatGPT؟
در شاخص هوش مستقل Artificial Analysis، GPT-6 Astra با ۵۶.۹ امتیاز بهمراتب جلوتر از Grok 4.7 با ۳۵ است. Grok 4.7 ارزانتر است و در تحلیل داده و توهم کمتر رقابتی است، اما برای کارهای سخت ChatGPT با مدلهای GPT-6 قویتر است.
آیا نمرههای اعلامشده توسط xAI قابل اعتمادند؟
بخشی از آنها با آزمون مستقل فاصله دارد؛ مثلاً Terminal-Bench 4.0 که xAI ۳۷.۶٪ اعلام کرده، در اجرای Artificial Analysis ۲۴.۷٪ شده است. بهتر است همیشه نتایج مستقل را هم ببینید.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.