سالها بنچمارکهایی مثل MMLU معیار اصلی سنجش هوش مدلهای زبانی بودند. اما مدلها آنقدر پیشرفت کردند که دقتشان در این آزمونها از ۹۰٪ گذشت و دیگر نمیشد بهترینها را از هم تشخیص داد. جواب این مشکل آزمونی بود با نامی جسورانه: Humanity's Last Exam یا «آخرین امتحان بشریت».
در این مقاله توضیح میدهیم HLE چیست، چه کسانی آن را ساختهاند، سؤالهایش چه شکلی است، بهترین مدلها امروز چه نمرهای میگیرند و چرا نسخهٔ تازهای به نام HLE-Diamond جای آن را در شاخصها گرفته است. اگر با مفهوم بنچمارک آشنا نیستید، اول راهنمای بنچمارکهای هوش مصنوعی را بخوانید.
آخرین بهروزرسانی: ۶ آبان ۱۴۰۵ — نمرهها از Artificial Analysis و سایت رسمی lastexam.ai در همین تاریخ برداشته شدهاند.
⚡ پاسخ کوتاه
Humanity's Last Exam (HLE) یک آزمون ۲۵۰۰ سؤالی در بیش از ۱۰۰ موضوع است که مرکز ایمنی هوش مصنوعی (CAIS) و Scale AI با کمک نزدیک به ۱۰۰۰ متخصص از بیش از ۵۰۰ مؤسسه در ۵۰ کشور ساختهاند. هر سؤال طوری انتخاب شده که مدلهای پیشرو هنگام ساخت آزمون نتوانند آن را حل کنند. در ژانویهٔ ۲۰۲۵ بهترین مدل فقط ۱۳.۴٪ گرفت؛ امروز در سنجش Artificial Analysis، Claude Opus 5.5 (Max) با ۶۱.۴٪ اول است. در سپتامبر ۲۰۲۶ نسخهٔ پالایششدهٔ ۱۰۰۰ سؤالی HLE-Diamond منتشر شد.
ایدهٔ HLE ساده بود: آزمونی بسازیم که در مرز دانش بشری باشد. سازندگان، یعنی Center for AI Safety به سرپرستی دن هندریکس و Scale AI، در مقالهای که ابتدا ژانویهٔ ۲۰۲۵ در arXiv و سپس ژانویهٔ ۲۰۲۶ در مجلهٔ Nature منتشر شد، دلیل کار را اینطور توضیح میدهند: مدلها در بنچمارکهای محبوب به دقت بالای ۹۰٪ رسیدهاند و این بنچمارکها دیگر تواناییهای واقعی مدلهای پیشرفته را نشان نمیدهند.
چند ویژگی HLE را از بقیهٔ آزمونها جدا میکند:
۲۵۰۰ سؤال در بیش از صد موضوع، از ریاضی و فیزیک تا زبانشناسی و تاریخ.
چندوجهی: حدود ۱۴٪ سؤالها تصویر هم دارند.
جواب دقیق: ۲۴٪ سؤالها چندگزینهای و بقیه با جواب کوتاه و دقیق (exact-match) هستند تا تصحیح خودکار ممکن باشد.
بسته (closed-ended): جواب با جستوجوی ساده در اینترنت پیدا نمیشود.
جایزه برای طراحان: صندوق جایزهٔ ۵۰۰ هزار دلاری؛ ۵۰۰۰ دلار برای هر کدام از ۵۰ سؤال برتر و ۵۰۰ دلار برای ۵۰۰ سؤال بعدی.
سؤالها چطور انتخاب شدند؟
هر سؤال پیشنهادی ابتدا به چند مدل پیشرو آن زمان (مثل GPT-4o، Gemini 1.5 Pro، Claude 3.5 Sonnet و o1) داده شد. فقط سؤالهایی که مدلها نتوانستند حل کنند به مرحلهٔ بعد رفتند. طبق مقاله، بیش از ۷۰ هزار تلاش مدل ثبت شد و حدود ۱۳ هزار سؤال که مدلها را شکست دادند، برای بازبینی متخصصان فرستاده شدند. بازبینها مدرک تحصیلات تکمیلی در رشتهٔ خود داشتند و سؤالها در دو مرحله بازبینی شدند.
⚠️ یک نکتهٔ روششناسی: چون سؤالها با شکست دادن همین مدلها انتخاب شدهاند، Artificial Analysis توصیه میکند نمرهٔ این مدلها را مستقیم با مدلهایی که در فرایند انتخاب سؤال نبودهاند مقایسه نکنید؛ آزمون ممکن است علیه آنها سوگیری داشته باشد.
نمونه سؤالها و حوزهها
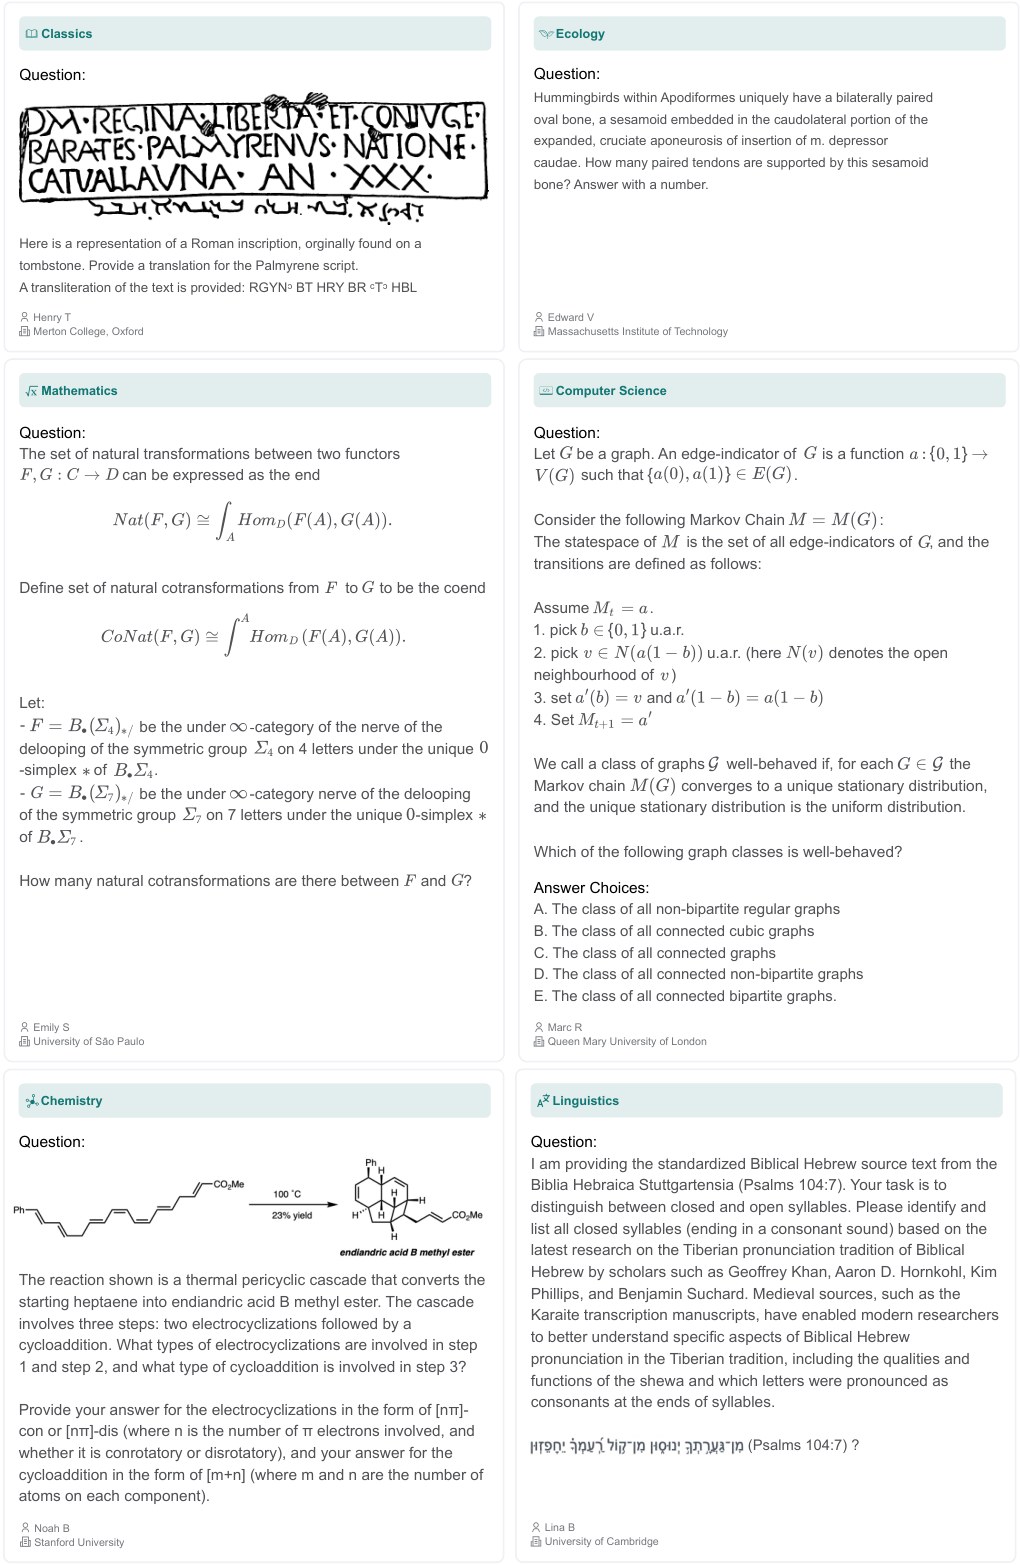
چند نمونه از سؤالهای HLE در حوزههای مختلف، از مقالهٔ اصلی آزمون. منبع تصویر: CAIS و Scale AI (arXiv:2501.14249)
سؤالهای HLE برای متخصص همان رشته هم سختاند. در نمونههایی که خود سازندگان منتشر کردهاند، مثلاً سؤالهایی مثل رمزگشایی یک رمز جانشینی دومرحلهای، بررسی پروتئینهای خرس آبی (تاردیگرید) که هنگام آبگیری هیدروژل میسازند و پیدا کردن هجای تکیهدار در واژههای روسی قدیم دیده میشود.
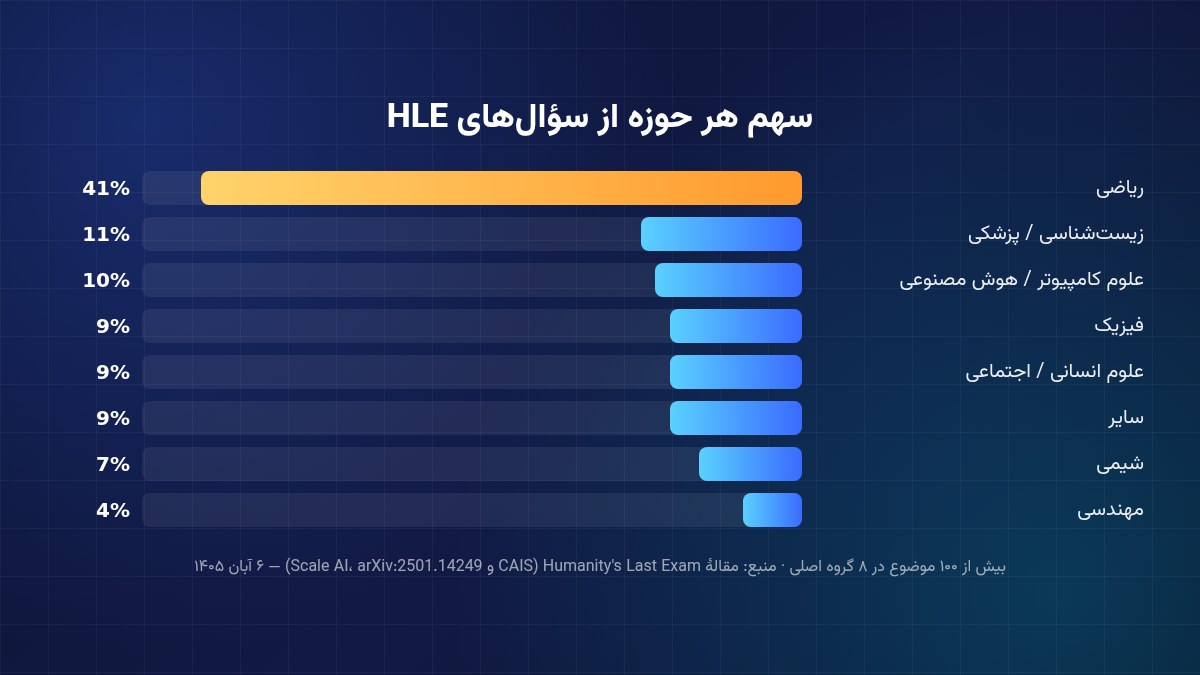
سهم هر حوزه از ۲۵۰۰ سؤال HLE طبق مقالهٔ اصلی. منبع تصویر: تحریریه رادینو
ریاضی با ۴۱٪ بزرگترین سهم را دارد. بعد از آن زیستشناسی و پزشکی (۱۱٪)، علوم کامپیوتر و هوش مصنوعی (۱۰٪)، فیزیک (۹٪)، علوم انسانی و اجتماعی (۹٪)، سایر حوزهها (۹٪)، شیمی (۷٪) و مهندسی (۴٪) قرار دارند. سنگینی ریاضی یعنی HLE بیش از هر چیز توانایی استدلال چندمرحلهای را میسنجد؛ همان چیزی که {L("reasoning-models","مدلهای استدلالی")} برایش ساخته شدهاند.
نمرهٔ مدلهای برتر در HLE
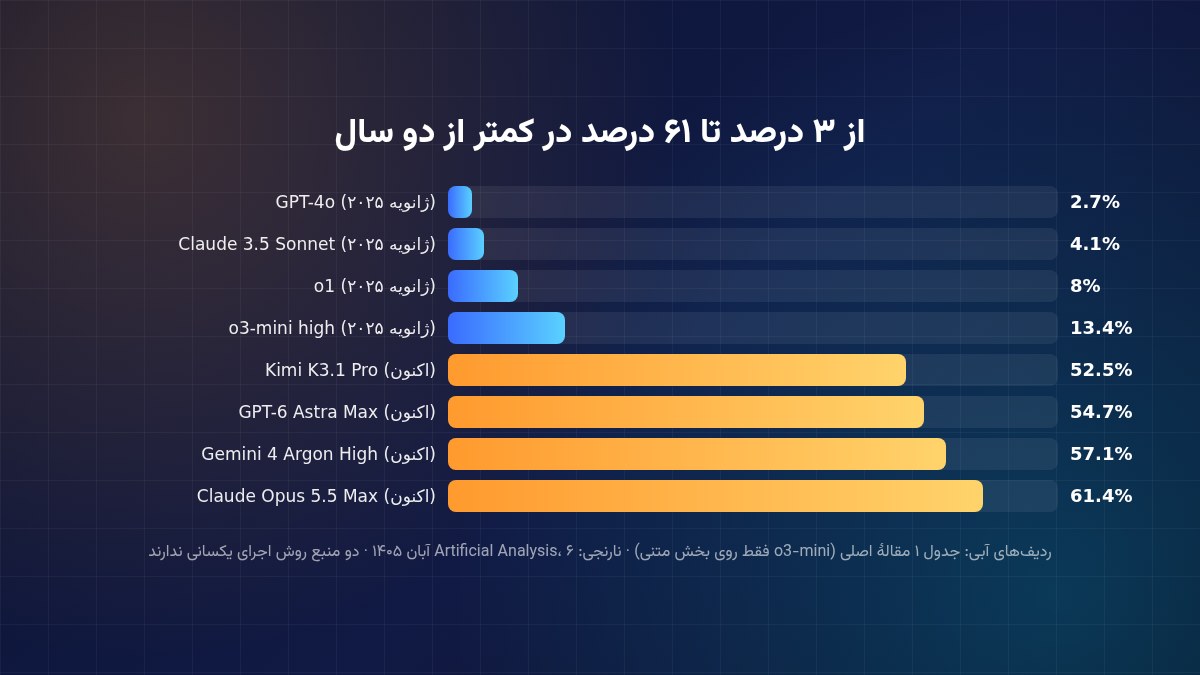
پیشرفت نمرهٔ مدلها: نتایج مقالهٔ اصلی در ژانویهٔ ۲۰۲۵ در برابر سنجش امروز Artificial Analysis. منبع تصویر: تحریریه رادینو
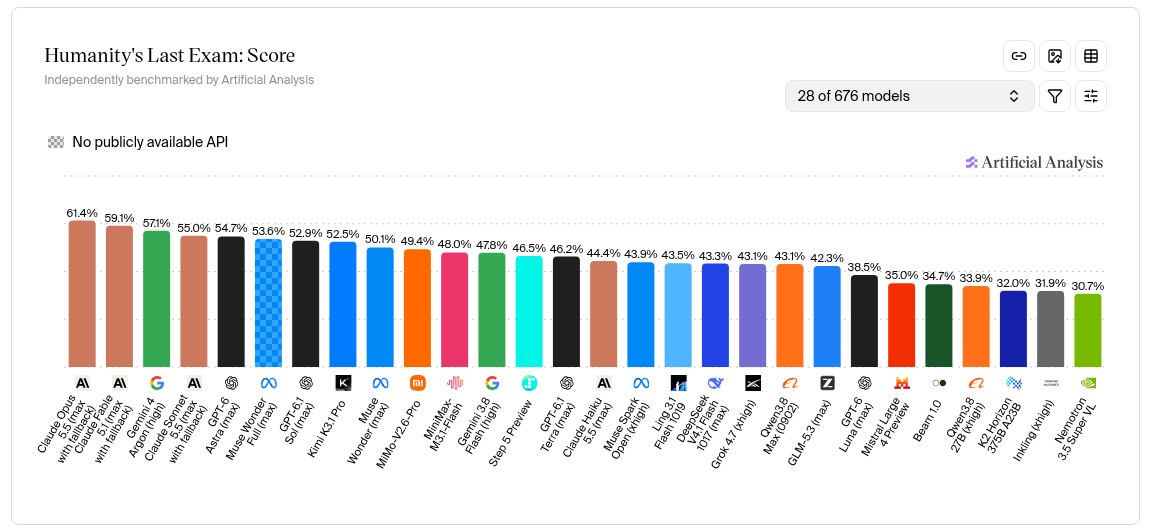
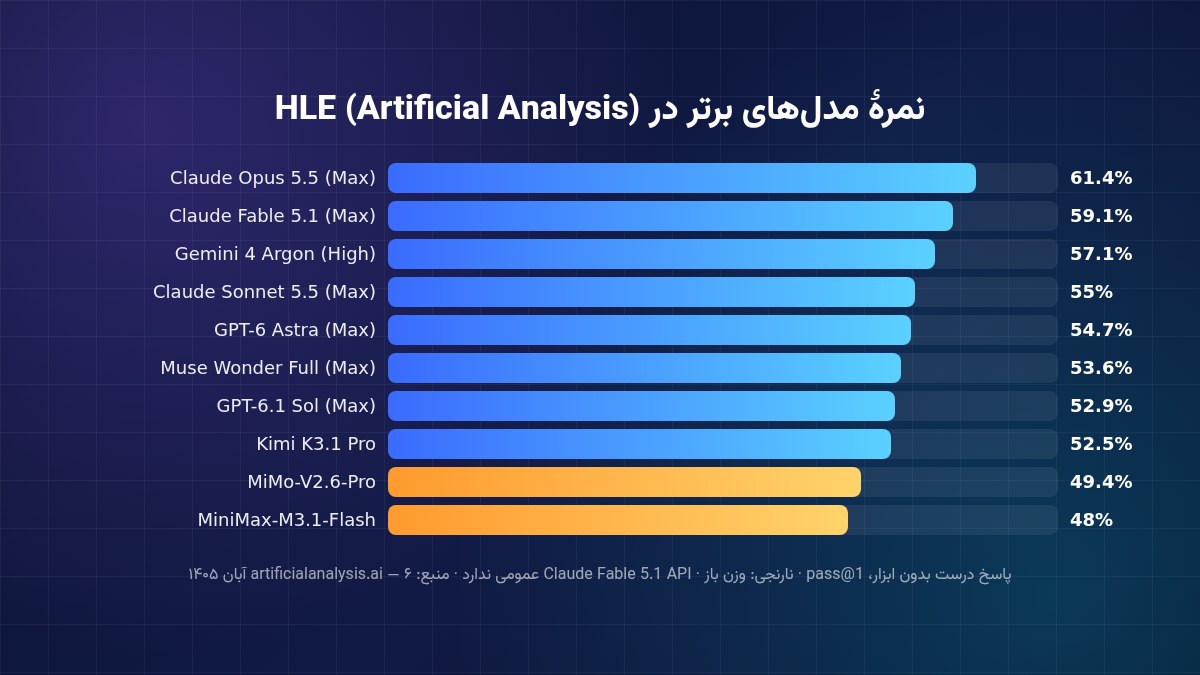
وقتی HLE معرفی شد، نتیجه تحقیرآمیز بود: GPT-4o فقط ۲.۷٪، Claude 3.5 Sonnet ۴.۱٪، o1 ۸٪ و بهترین مدل، o3-mini (high)، ۱۳.۴٪ (فقط روی سؤالهای متنی). اما مدلها سریعتر از انتظار پیشرفت کردند. جدول زیر نمرهٔ امروز مدلهای برتر را در سنجش مستقل Artificial Analysis نشان میدهد:
نمودار نمرهٔ مدلها در صفحهٔ HLE سایت Artificial Analysis. منبع تصویر: Artificial Analysisده مدل برتر در HLE اصلی طبق سنجش Artificial Analysis (آبان ۱۴۰۵). منبع تصویر: تحریریه رادینو
در HLE، اینکه مدل چقدر «فکر کند» تأثیر بزرگی دارد. Claude Opus 5.5 در سطح تلاش Low نمرهٔ ۴۸.۳٪، در Medium ۵۴.۷٪، در High ۵۵.۶٪، در Xhigh ۵۷.۵٪ و در Max ۶۱.۴٪ میگیرد. در GPT-6 Astra این اختلاف کمتر است: از ۴۹.۲٪ در Low تا ۵۴.۷٪ در Max. پس وقتی نمرهٔ HLE یک مدل را میبینید، حتماً به سطح تلاش آن هم نگاه کنید.
HLE-Diamond؛ نسل تازهٔ آخرین امتحان
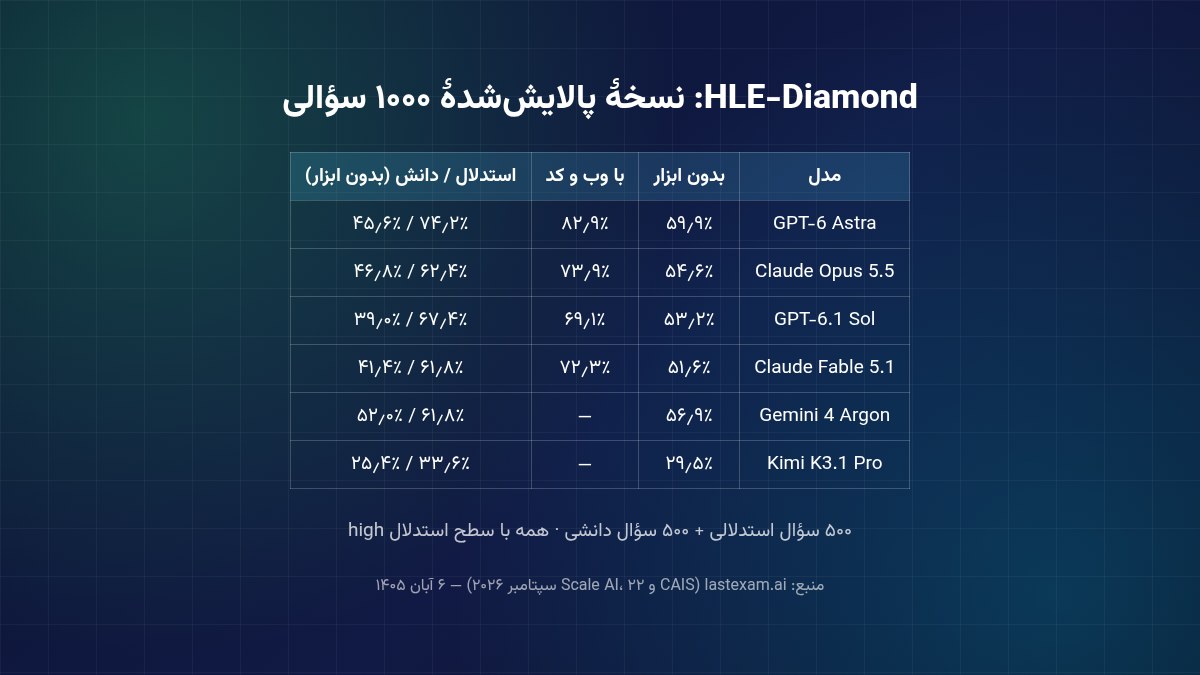
نمرهٔ مدلها در HLE-Diamond بدون ابزار و با ابزار، طبق سایت رسمی lastexam.ai. منبع تصویر: تحریریه رادینو
HLE بینقص نبود. گروهی از پژوهشگران ادعا کردند بخشی از جوابهای شیمی و زیستشناسی احتمالاً غلط است و خود سازندگان هم در بازبینی هدفمند روی زیرمجموعهٔ زیست، شیمی و سلامت به نرخ اختلافنظر حدود ۱۸٪ بین متخصصان رسیدند. سازندگان یک نسخهٔ پویا به نام HLE-Rolling هم در اکتبر ۲۰۲۵ راه انداختند.
حاصل یک سال پاکسازی و بازبینی، HLE-Diamond است که ۲۲ سپتامبر ۲۰۲۶ منتشر شد: ۱۰۰۰ سؤال که بهطور مساوی به ۵۰۰ سؤال استدلالی و ۵۰۰ سؤال دانشی تقسیم شدهاند. طبق سایت رسمی، با سطح استدلال high و بدون ابزار، GPT-6 Astra با ۵۹.۹٪ اول است و بعد Gemini 4 Argon (۵۶.۹٪) و Claude Opus 5.5 (۵۴.۶٪) قرار دارند. با دسترسی به وب و اجرای کد، نمرهٔ GPT-6 Astra به ۸۲.۹٪ میرسد.
Artificial Analysis هم در نسخهٔ ۵.۰ شاخص هوش خود، HLE اصلی را کنار گذاشته و HLE-Diamond را با وزن ۱۰٪ جایگزین کرده است. در سنجش خود این سایت (با سطح تلاش Max)، Claude Opus 5.5 با ۶۷.۹٪ در HLE-Diamond اول است و GPT-6 Astra با ۶۳.۸٪ بعد از آن قرار دارد. اختلاف این عدد با جدول سایت رسمی بهخاطر سطح تلاش متفاوت است. Artificial Analysis تأکید میکند نمرهٔ HLE اصلی (۲۱۵۸ سؤال متنی) و HLE-Diamond (شامل ۲۷۲ سؤال تصویری) مستقیم قابل مقایسه نیستند.
نمرهٔ HLE برای شما چه معنایی دارد؟
نمرهٔ ۶۱٪ در HLE یعنی مدل بیش از نیمی از سؤالهایی را حل میکند که برای متخصصان هم سختاند. اما این به معنی «هوشمندتر از انسان» نیست. چند نکته را در نظر بگیرید:
HLE دانش و استدلال علمی را میسنجد، نه توانایی انجام کار واقعی مثل کدنویسی، نوشتن یا کار با ابزارها.
اطمینان کاذب: در مقالهٔ اصلی، خطای کالیبراسیون همهٔ مدلها بالای ۷۰٪ بود؛ یعنی مدلها با اطمینان بالا جواب غلط میدادند. این همان مشکل توهم هوش مصنوعی است.
هزینه و زمان: بالاترین نمرهها در سطح تلاش Max به دست میآید که بسیار کند و گران است.
یک بنچمارک کافی نیست: برای انتخاب مدل، شاخصهای ترکیبی مثل شاخص هوش Artificial Analysis را ببینید؛ راهنمای Artificial Analysis را بخوانید.
آیندهٔ بنچمارکهای سخت
سرعت اشباع شدن HLE، از ۱۳٪ به بیش از ۶۰٪ در کمتر از دو سال، نشان میدهد ساختن آزمونی که «آخرین» بماند چقدر سخت است. به همین دلیل روند بنچمارکها به سمت نسخههای پالایششده و پویا (مثل HLE-Diamond و HLE-Rolling) و آزمونهای عملیتر مثل کار ایجنتها در محیط واقعی رفته است. سؤال قدیمی هم سر جایش است: هوش مصنوعی واقعاً چقدر باهوش است؟
🎓 یادگیری عملی: برای شناخت بهتر مدلهای هوش مصنوعی و استفادهٔ درست از آنها، دورهٔ کپسول هوش مصنوعی رادینو را ببینید.
سؤالات متداول
Humanity's Last Exam چیست؟
یک بنچمارک ۲۵۰۰ سؤالی در مرز دانش بشری که CAIS و Scale AI با کمک نزدیک به ۱۰۰۰ متخصص ساختهاند. سؤالها در بیش از ۱۰۰ موضوع هستند و طوری انتخاب شدهاند که مدلهای پیشرو هنگام ساخت آزمون نتوانند آنها را حل کنند.
بالاترین نمره در HLE مال کدام مدل است؟
در سنجش Artificial Analysis در آبان ۱۴۰۵، Claude Opus 5.5 (Max) با ۶۱.۴٪ اول است و Claude Fable 5.1 (Max) با ۵۹.۱٪ دوم.
HLE-Diamond چه فرقی با HLE دارد؟
HLE-Diamond نسخهٔ پالایششدهٔ ۱۰۰۰ سؤالی است که ۲۲ سپتامبر ۲۰۲۶ منتشر شد و به ۵۰۰ سؤال استدلالی و ۵۰۰ سؤال دانشی تقسیم میشود. Artificial Analysis آن را جایگزین HLE اصلی در شاخص هوش نسخهٔ ۵.۰ کرده است.
سؤالهای HLE در چه حوزههایی است؟
ریاضی ۴۱٪، زیستشناسی و پزشکی ۱۱٪، علوم کامپیوتر و هوش مصنوعی ۱۰٪، فیزیک ۹٪، علوم انسانی و اجتماعی ۹٪، سایر ۹٪، شیمی ۷٪ و مهندسی ۴٪.
آیا نمرهٔ بالا در HLE یعنی مدل از انسان باهوشتر است؟
نه. HLE فقط دانش و استدلال علمی را در سؤالهای بسته میسنجد. توانایی انجام کار واقعی، خلاقیت و قابلیت اعتماد به جوابها چیزهای دیگری هستند.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.