وقتی خبر میرسد «مدل تازهٔ گوگل در LMArena اول شد»، منظور یک آزمون چندگزینهای یا مسئلهٔ ریاضی نیست. منظور این است که میلیونها کاربر، بدون اینکه بدانند با کدام مدل حرف میزنند، پاسخها را مقایسه کردهاند و این مدل بیشتر از بقیه برنده شده است. LMArena، که حالا با نام کوتاهتر Arena شناخته میشود، معروفترین رتبهبندی مدلهای هوش مصنوعی بر اساس رأی کاربران است.
در این مقاله توضیح میدهیم آرنا چطور کار میکند، امتیازی که شبیه امتیاز Elo شطرنج است دقیقاً چه معنایی دارد، آرناهای تصویر و ویدیو چه فرقی با آرنای متن دارند، و چرا رتبهٔ یک مدل در آرنا گاهی با رتبهاش در بنچمارکهای خودکار فرق میکند. اگر با بنچمارکها تازه آشنا شدهاید، پیش از این مطلب راهنمای بنچمارکهای هوش مصنوعی را بخوانید.
آخرین بهروزرسانی: ۳ آبان ۱۴۰۵ — عددها از جدولهای رسمی arena.ai (Text، WebDev، Text-to-Image و Text-to-Video)، صفحههای FAQ و How it works و مقالهٔ پژوهشی Chatbot Arena برداشته شدهاند (بررسی: ۳ آبان ۱۴۰۵).
⚡ پاسخ کوتاه
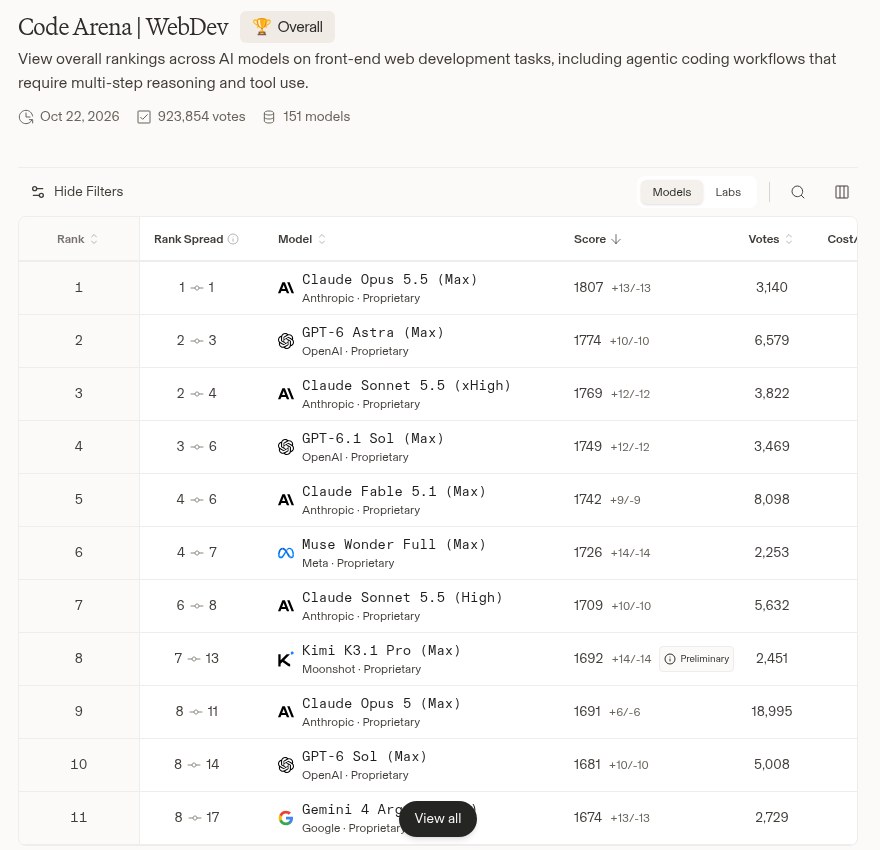
LMArena (نام فعلی: Arena، در گذشته Chatbot Arena) سایتی است که در آن کاربر یک سؤال میپرسد، دو مدل ناشناس جواب میدهند و کاربر پاسخ بهتر را انتخاب میکند. از میلیونها رأی، با مدل آماری Bradley-Terry که شبیه سیستم Elo شطرنج است، برای هر مدل یک امتیاز ساخته میشود. اختلاف امتیاز احتمال برد را نشان میدهد: ۱۰۰ امتیاز اختلاف یعنی مدل قویتر در حدود ۶۴ درصد مقایسهها برنده میشود. در ۳ آبان ۱۴۰۵، صدر Text Arena با Gemini 4 Argon (High) و امتیاز ۱۵۱۷ است و صدر WebDev با Claude Opus 5.5 (Max) و امتیاز ۱۸۰۷. آرنا «ترجیح انسانی» را میسنجد، نه لزوماً درستی پاسخ را؛ برای همین باید کنار بنچمارکهای خودکار خوانده شود.
Chatbot Arena در بهار ۱۴۰۲ (۲۰۲۳) بهعنوان یک پروژهٔ پژوهشی دکتری در دانشگاه برکلی (UC Berkeley) راه افتاد. ایدهاش ساده بود: بهجای اینکه مدلها را با مجموعهای ثابت از سؤالها بسنجیم، بگذاریم مردم سؤالهای واقعی خودشان را بپرسند و پاسخ بهتر را انتخاب کنند. روش علمی آن در مقالهٔ «Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference» منتشر و در کنفرانس ICML 2024 پذیرفته شد.
پروژه بعدها با نام LMArena به دامنهٔ lmarena.ai رفت و به یک شرکت مستقل تبدیل شد. در ۸ بهمن ۱۴۰۴ (۲۸ ژانویهٔ ۲۰۲۶) نامش را از LMArena به Arena تغییر داد و به آدرس arena.ai منتقل شد. طبق اعلام خود Arena در زمان تغییر نام، بیش از ۵ میلیون کاربر ماهانه از ۱۵۰ کشور و ماهانه حدود ۶۰ میلیون گفتوگو در این سایت ثبت میشد.
Arena امروز چه جدولهایی دارد؟
آرنا دیگر فقط چتباتها را مقایسه نمیکند. در منوی Leaderboard این جدولها را میبینید: Text (متن)، WebDev و Image-to-WebDev (ساخت وبسایت)، Vision (درک تصویر)، Document (اسناد)، Search (جستوجو)، Agent (ایجنتها)، Text-to-Image و Image Edit (تصویر)، Text-to-Video، Image-to-Video و Video Edit (ویدیو)، بهعلاوهٔ یک جدول کلی (Overall) و شاخصی به نام Alignment Index.
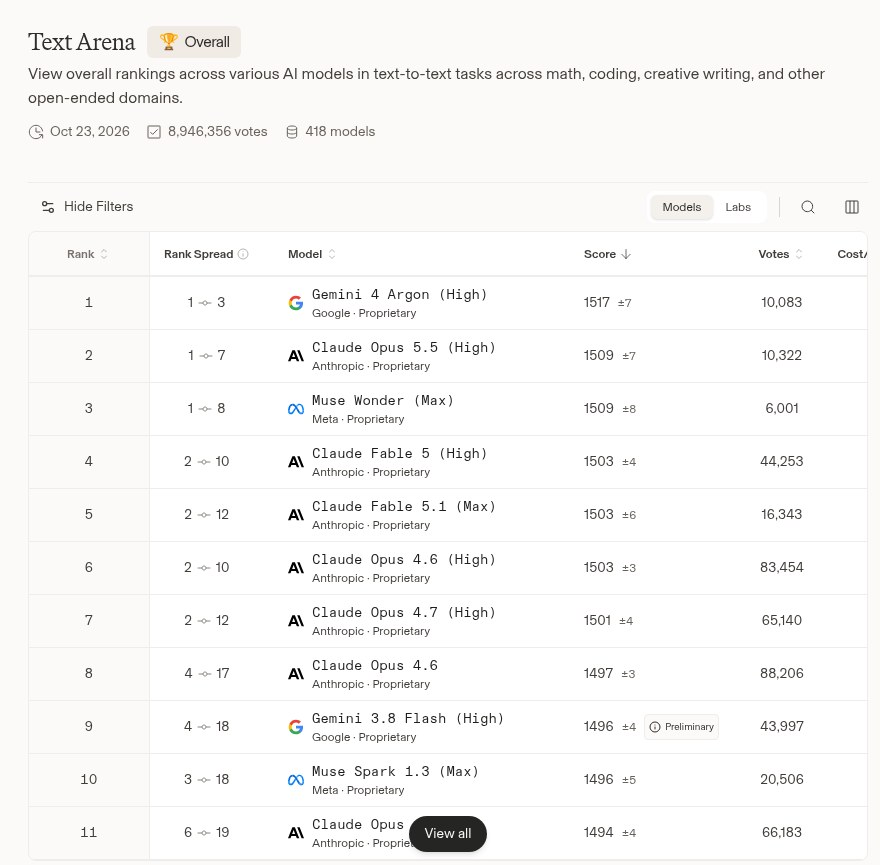
جدول Text Arena با ۸,۹۴۶,۳۵۶ رأی و ۴۱۸ مدل؛ ستونهای امتیاز، بازهٔ اطمینان، بازهٔ رتبه و تعداد رأی (۳ آبان ۱۴۰۵). منبع تصویر: Arena
یک نبرد چطور انجام میشود؟
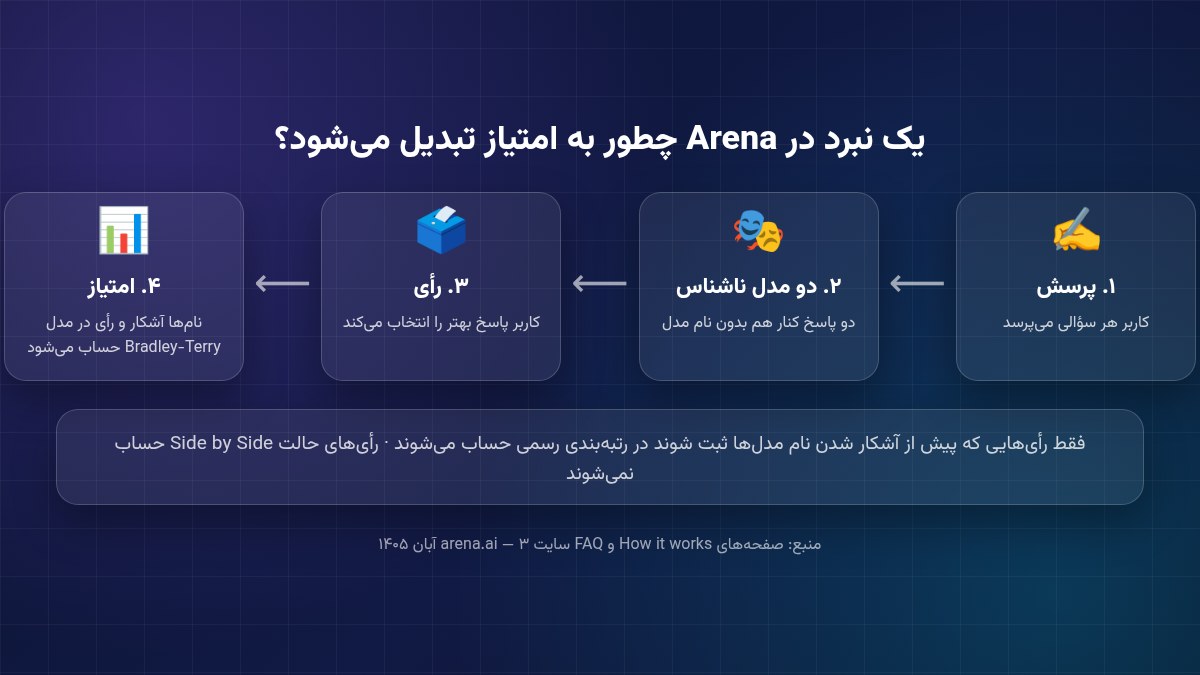
در حالت Battle، کاربر پرامپت خودش را مینویسد و دو مدل ناشناس، که با برچسبهایی مثل A و B نمایش داده میشوند، پاسخ میدهند. کاربر پاسخها را میخواند و پاسخ بهتر را انتخاب میکند. در جدولها هم برای حساب کردن نسبت بردها، نتیجههای مساوی (Ties) جدا شدهاند. بلافاصله پس از رأی، نام مدلها آشکار میشود. چند قاعدهٔ مهم طبق FAQ رسمی Arena:
فقط رأیهای ناشناس حساب میشوند. رأیی که بعد از آشکار شدن نام مدلها داده شود، در رتبهبندی رسمی اثری ندارد.
حالت Side by Side در جدول حساب نمیشود. در این حالت خودتان مدلها را انتخاب میکنید، پس مقایسه کور نیست. رأیها فقط برای پژوهش جمعآوری میشوند.
مدلهای پیش از انتشار با نام رمز میآیند. شرکتها نسخههای آزمایشی را پیش از عرضهٔ رسمی با نامهای مستعار در Battle قرار میدهند.
دادهها باز است. بخشی از گفتوگوها، پس از حذف اطلاعات هویتی، بهصورت دیتاست عمومی در Hugging Face منتشر میشود.
چهار مرحلهٔ یک نبرد در Arena، از پرسش تا محاسبهٔ امتیاز. منبع تصویر: تحریریه رادینو
امتیاز Elo به زبان ساده
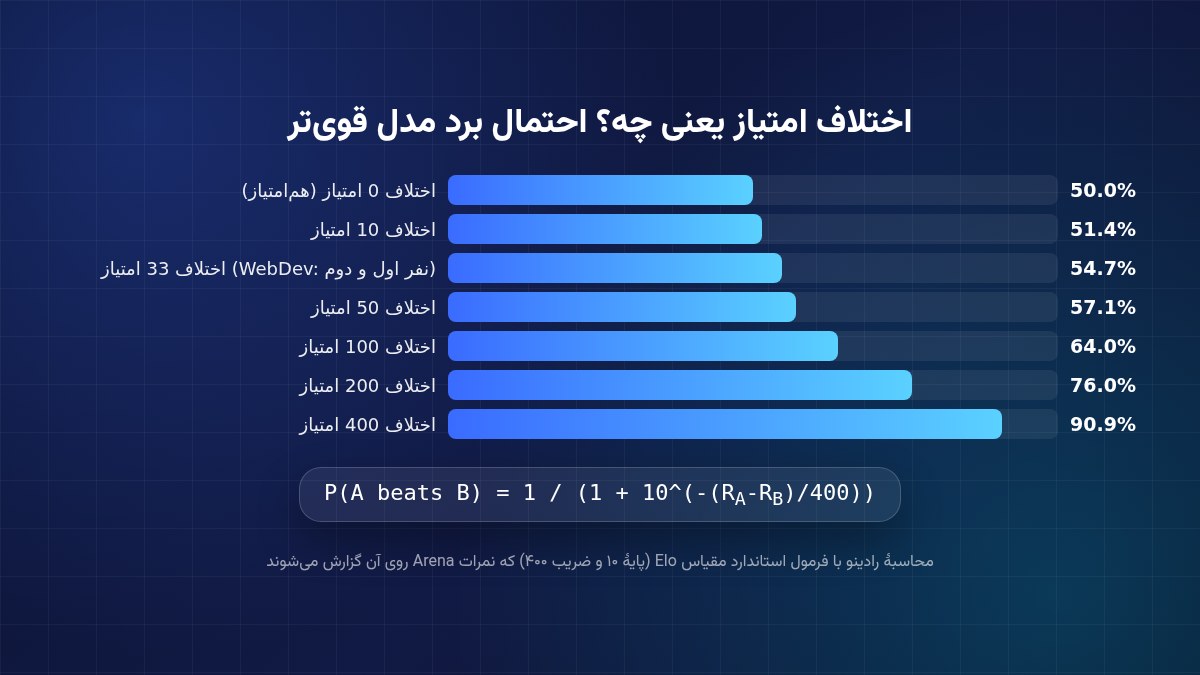
سیستم Elo را آرپاد اِلو برای رتبهبندی شطرنجبازها ساخت. منطقش این است که اگر بازیکن قوی از ضعیف ببرد، امتیازش کمی بالا میرود. اما اگر ضعیف از قوی ببرد، امتیاز هر دو زیاد جابهجا میشود. نکتهٔ مهم این است که خود عدد معنای مطلق ندارد؛ آنچه معنا دارد اختلاف دو امتیاز است، چون احتمال برد را تعیین میکند:
P(A beats B) = 1 / (1 + 10−(RA − RB)/400)
اختلاف امتیاز
احتمال برد مدل قویتر
مثال واقعی (۳ آبان ۱۴۰۵)
۰
۵۰٪
Claude Opus 5.5 (High) و Muse Wonder (Max)، هر دو ۱۵۰۹ در Text Arena
۸
حدود ۵۱٪
Gemini 4 Argon (۱۵۱۷) در برابر Claude Opus 5.5 (۱۵۰۹)
۳۳
حدود ۵۵٪
Claude Opus 5.5 (Max) با ۱۸۰۷ در برابر GPT-6 Astra (Max) با ۱۷۷۴ در WebDev
۱۰۰
حدود ۶۴٪
—
۲۰۰
حدود ۷۶٪
—
۴۰۰
حدود ۹۱٪
—
یعنی اختلاف چندامتیازی در صدر جدول عملاً به معنی «تقریباً همسطح» است. حتی نفر اول WebDev، با ۳۳ امتیاز فاصله، فقط در حدود ۵۵ درصد مقایسهها از نفر دوم بهتر شناخته میشود.
احتمال برد مدل قویتر بر اساس اختلاف امتیاز در مقیاس Elo. منبع تصویر: تحریریه رادینو
Bradley-Terry؛ همان Elo، ولی دقیقتر
Arena در FAQ خود میگوید رتبهها را با مدل آماری Bradley-Terry محاسبه میکند. این مدل برای آزمایشهای مقایسهٔ زوجی ساخته شده و «شبیه سیستم Elo» است. تفاوت اصلی این است که Elo امتیاز را بعد از هر بازی و به ترتیب زمان بهروز میکند، پس نتیجه به ترتیب رأیها حساس است. Bradley-Terry اما همهٔ رأیها را با هم در نظر میگیرد و پایدارترین امتیاز ممکن را برای همهٔ مدلها تخمین میزند. امتیاز نهایی همچنان روی همان مقیاس آشنای Elo گزارش میشود و برای همین بیشتر رسانهها هنوز میگویند «امتیاز Elo در LMArena».
بازهٔ اطمینان و بازهٔ رتبه
کنار هر امتیاز یک عدد ± میبینید، مثلاً ۱۵۱۷ ±۷ برای Gemini 4 Argon. این عدد بازهٔ اطمینان آماری است که با روش بوتاسترپ محاسبه میشود. هرچه رأیهای یک مدل کمتر باشد، این بازه پهنتر است. ستون Rank Spread نشان میدهد با توجه به این عدم قطعیت، مدل ممکن است در چه بازهای از رتبهها باشد. مثلاً Gemini 4 Argon بین رتبهٔ ۱ تا ۳ و Claude Opus 5.5 (High) بین ۱ تا ۷ است. مدلهای تازه با رأی کم هم برچسب Preliminary (مقدماتی) میگیرند، مثل Kimi K3.1 Pro در WebDev.
کنترل سبک (Style Control)
یکی از نقدهای قدیمی به آرنا این بود که کاربران پاسخهای بلندتر و پر از تیتر و فهرست را بیشتر میپسندند، حتی اگر محتوایشان بهتر نباشد. Arena برای حل این مشکل مدل Bradley-Terry را با «کنترل سبک» گسترش داد. در این روش، اثر ویژگیهایی مثل طول پاسخ و میزان قالببندی Markdown از امتیاز جدا میشود. امتیازهای پیشفرض جدول با کنترل سبک محاسبه میشوند. Arena اخیراً سنجش درستی پاسخ (Factuality) را هم به کارش اضافه کرده است، چون به گفتهٔ خودش «پاسخی که مردم ترجیح میدهند همیشه پاسخ درست نیست».
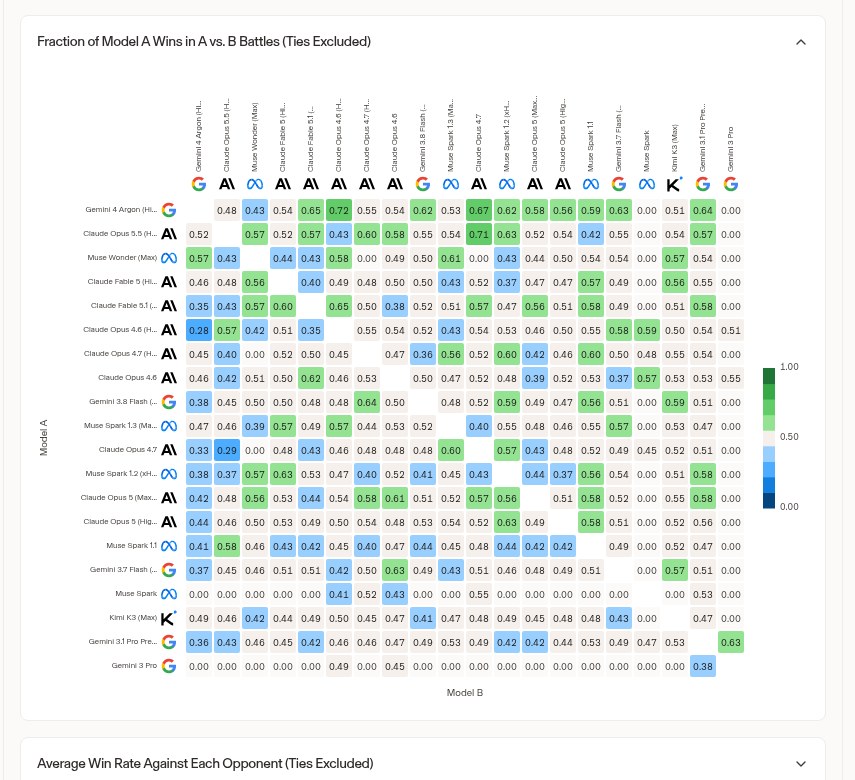
نقشهٔ حرارتی نسبت بردهای دوبهدوی مدلهای صدر Text Arena (بدون احتساب مساویها). منبع تصویر: Arena
آرناهای تصویر، ویدیو و صدا
همین روش رأی کور برای مدلهای تصویر و ویدیو هم کار میکند. کاربر یک پرامپت مینویسد، دو تصویر یا ویدیو میبیند و بهتر را انتخاب میکند. در ۳ آبان ۱۴۰۵:
جدول Arena
رتبهٔ ۱
رتبهٔ ۲
رتبهٔ ۳
حجم داده
Text Arena
Gemini 4 Argon (High) · ۱۵۱۷
Claude Opus 5.5 (High) · ۱۵۰۹
Muse Wonder (Max) · ۱۵۰۹
۸.۹ میلیون رأی، ۴۱۸ مدل
WebDev
Claude Opus 5.5 (Max) · ۱۸۰۷
GPT-6 Astra (Max) · ۱۷۷۴
Claude Sonnet 5.5 (xHigh) · ۱۷۶۹
۹۲۳ هزار رأی، ۱۵۱ مدل
Text-to-Image
GPT-Image-2.5 Sunburst · ۱۴۲۵
GPT-Image-2.5 Flare · ۱۳۹۸
GPT-Image-2 (Medium) · ۱۳۸۳
۶.۶ میلیون رأی، ۸۲ مدل
Text-to-Video
Gemini Omni 1.1 Flash · ۱۵۱۶
gemini-omni-flash · ۱۵۱۳
FLUX 3 Video · ۱۴۹۳
۷۱۸ هزار رأی، ۴۸ مدل
تاریخ آخرین بهروزرسانی هر جدول در خود سایت فرق میکند: Text در ۱ آبان، WebDev در ۳۰ مهر، Text-to-Image در ۱۵ مهر و Text-to-Video در ۳۰ شهریور ۱۴۰۵.
جدول Code Arena | WebDev؛ مقایسهٔ مدلها در ساخت وبسایت و کدنویسی ایجنتی فرانتاند (۳ آبان ۱۴۰۵). منبع تصویر: Arena
Arena تنها آرنای رسانهای نیست. Artificial Analysis هم برای تصویر، ویدیو و گفتار آرنای رأیگیری خودش را دارد. جالب است که نتیجهها همیشه یکی نیستند: GPT Image 2.5 Sunburst در هر دو آرنا اول است، اما Wan 3.0 که در آرنای ویدیوی Artificial Analysis رتبهٔ اول را داشت، در Arena ششم است. علتش تفاوت پرامپتها، جامعهٔ رأیدهنده و تنظیمات تولید است. دربارهٔ آرناهای Artificial Analysis در راهنمای Artificial Analysis نوشتهایم. برای مدلهای صوتی، فعلاً جدولهای گفتار Artificial Analysis مرجع رایجتری هستند، چون فهرست جدولهای Arena بخش جداگانهای برای صدا ندارد.
مزایا و ضعفهای رتبهبندی با رأی کاربران
مزایا
پرسشهای واقعی و تازه: سؤالها را مردم مینویسند و مدام عوض میشوند، پس حفظ کردن جوابها یا «نشت داده» تقریباً بیاثر است.
سنجش چیزی که بنچمارک نمیسنجد: لحن، وضوح، مفید بودن و حس کلی کیفیت؛ همان چیزهایی که کاربر عادی تجربه میکند.
پوشش گسترده: به تعبیر خود صفحهٔ Text Arena، از ریاضی و کدنویسی تا نویسندگی خلاق و دیگر حوزههای باز؛ بهعلاوهٔ جدولهای جدا برای وب، تصویر، ویدیو، جستوجو و ایجنتها.
شفافیت: روش منتشر شده، دادهها تا حدی باز است و هر کسی میتواند رأی بدهد.
ضعفها
ترجیح، نه درستی: کاربر عادی همیشه نمیتواند خطای یک پاسخ پزشکی یا حقوقی را تشخیص دهد. پاسخی که مطمئنتر و زیباتر نوشته شده ممکن است برنده شود، حتی اگر اشتباه باشد.
اثر سبک: کنترل سبک بخشی از این مشکل را حل میکند، اما نه همهاش را.
جامعهٔ رأیدهنده: رأیدهندگان بیشتر علاقهمندان فناوری و انگلیسیزباناند. پس نتیجه لزوماً نمایندهٔ همهٔ کاربران، از جمله کاربران فارسیزبان، نیست.
آزمایش نسخههای متعدد: FAQ خود Arena میگوید شرکتها پیش از عرضه «نسخههای زیادی» را با نام رمز آزمایش میکنند. منتقدان میگویند این کار به شرکتهای بزرگ امکان میدهد بهترین نسخه را برای جدول انتخاب کنند.
نیاز به رأی زیاد: مدل تازه تا چند هزار رأی نگیرد، بازهٔ اطمینانش پهن است و رتبهاش قطعی نیست.
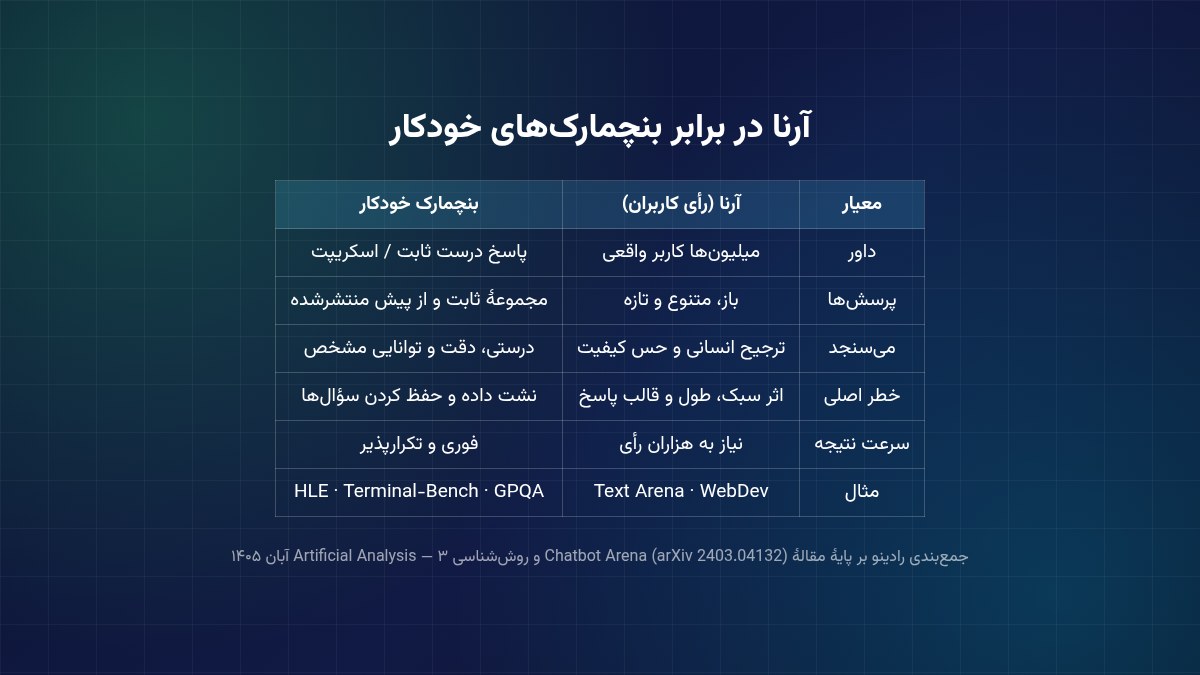
مقایسه با بنچمارکهای خودکار
بنچمارکهای خودکار مثل Humanity's Last Exam، Terminal-Bench یا شاخص هوش Artificial Analysis پاسخ درست مشخص دارند و نتیجهشان قابل تکرار است. آرنا در مقابل، چیزی را میسنجد که پاسخ درست ندارد: اینکه آدمها کدام پاسخ را ترجیح میدهند. این دو مکمل هماند، نه رقیب.
یک مثال روشن: در شاخص هوش Artificial Analysis، Claude Opus 5.5 با امتیاز ۵۷.۶ اول است و Gemini 4 Argon با ۵۲.۶ در رتبههای پایینتر قرار دارد. اما در Text Arena، Gemini 4 Argon با ۱۵۱۷ اول است و Opus 5.5 (High) با ۱۵۰۹ دوم. Kimi K3.1 Pro هم در شاخص Artificial Analysis چهارم است، ولی در WebDev با برچسب مقدماتی هشتم. تحلیل کامل این تفاوت را در بنچمارک Kimi K3.1 Pro آوردهایم. برای دیدن هر دو نوع داده کنار هم، جدول رتبهبندی مدلهای هوش مصنوعی را ببینید.
💡 قاعدهٔ عملی: برای کارهایی که «درست و غلط» دارند، مثل کدنویسی، محاسبه و استخراج اطلاعات، به بنچمارکهای خودکار وزن بیشتری بدهید. برای کارهایی که کیفیت در آنها سلیقهای است، مثل نویسندگی، گفتوگو و طراحی، رتبهٔ آرنا راهنمای بهتری است. در هر دو حالت، تصمیم نهایی را با آزمایش روی کار خودتان بگیرید.
سؤالات متداول
LMArena همان Chatbot Arena است؟
بله. پروژه در سال ۲۰۲۳ با نام Chatbot Arena شروع شد، بعدها با نام LMArena به lmarena.ai رفت و در ۸ بهمن ۱۴۰۴ (ژانویهٔ ۲۰۲۶) نامش به Arena تغییر کرد. آدرس فعلی آن arena.ai است.
امتیاز Elo در LMArena چطور حساب میشود؟
Arena از مدل آماری Bradley-Terry استفاده میکند که شبیه Elo است، اما بهجای بهروزرسانی بعد از هر رأی، همهٔ رأیها را با هم برازش میدهد. امتیاز روی مقیاس Elo گزارش میشود: ۱۰۰ امتیاز اختلاف یعنی حدود ۶۴ درصد احتمال برد. اثر طول و قالببندی پاسخ هم با کنترل سبک تعدیل میشود.
چرا رتبهٔ مدلها در LMArena با بنچمارکها فرق دارد؟
چون چیز متفاوتی میسنجند. بنچمارک خودکار درستی پاسخ را در مجموعهای ثابت از سؤالها میسنجد، اما آرنا ترجیح کاربران را روی سؤالهای واقعی و متنوع. لحن، وضوح و سبک پاسخ در آرنا اثر بیشتری دارند.
چطور در LMArena رأی بدهم؟
به arena.ai بروید، حالت Battle را انتخاب کنید، پرسش خود را بنویسید و از بین دو پاسخ ناشناس، پاسخ بهتر را انتخاب کنید. فقط رأیهایی که پیش از آشکار شدن نام مدلها داده شوند در جدول حساب میشوند.
آرنای تصویر و ویدیو هم وجود دارد؟
بله. Arena جدولهای Text-to-Image، Image Edit، Text-to-Video، Image-to-Video و Video Edit دارد. در ۳ آبان ۱۴۰۵ صدر جدول متن به تصویر GPT-Image-2.5 Sunburst با ۱۴۲۵ امتیاز و صدر جدول متن به ویدیو Gemini Omni 1.1 Flash با ۱۵۱۶ امتیاز بود.
جمعبندی
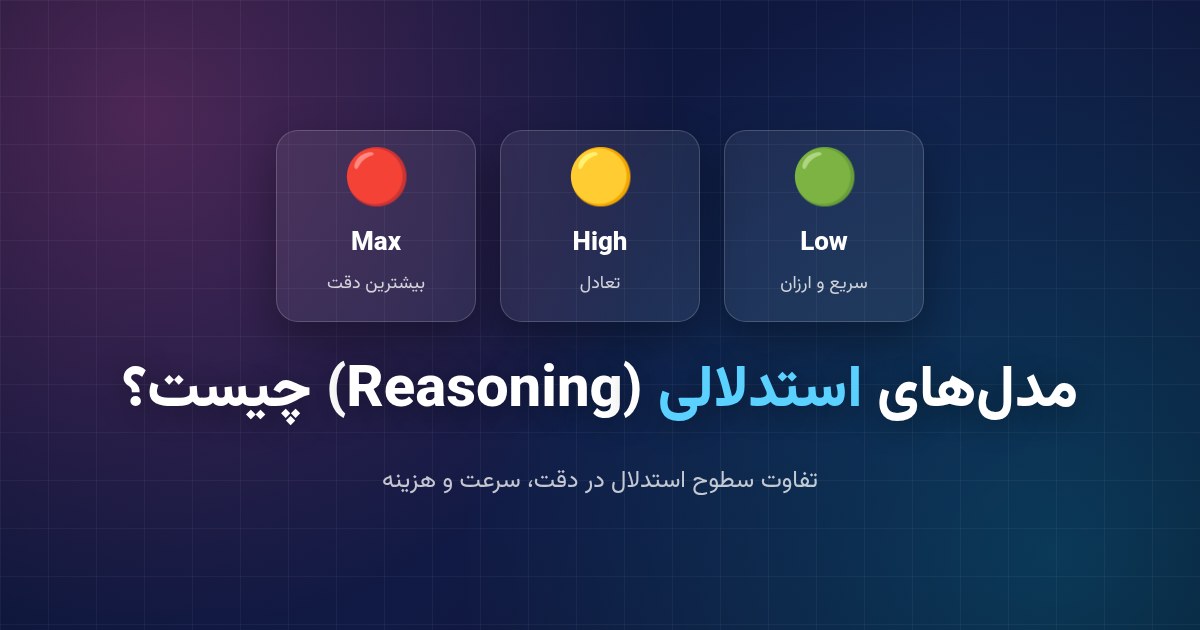
Arena (همان LMArena و Chatbot Arena سابق) با میلیونها رأی کور، تصویری از چیزی میدهد که بنچمارکهای خودکار نمیتوانند بسنجند: اینکه آدمها در عمل کدام پاسخ را بیشتر میپسندند. امتیازهای آن روی مقیاس Elo گزارش میشوند، با مدل Bradley-Terry محاسبه میشوند و با کنترل سبک تعدیل میشوند. اختلافهای چندامتیازی در صدر جدول هم تقریباً معنایی ندارند. بهترین استفاده از آرنا این است که آن را کنار شاخصهای خودکار مثل Artificial Analysis بخوانید و فهرست کوتاه نهایی را روی کار خودتان امتحان کنید. برای فهم برچسبهایی مثل High و Max کنار نام مدلها، مدلهای استدلالی چیست؟ را بخوانید.



نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.