وقتی مدل تازهای منتشر میشود، سازندهاش معمولاً جدولهایی پر از رتبهٔ اول منتشر میکند. سؤال اصلی اما این است که داوران مستقل چه میگویند. در این مقاله بنچمارک Kimi K3.1 Pro را عدد به عدد بررسی میکنیم: شاخص هوش Artificial Analysis، سرعت و هزینه، LMArena، SWE-bench، GPQA، Humanity's Last Exam و بنچمارکهای ایجنت کدنویسی. این مدل را با Claude Opus 5.5، GPT-6.1 Sol، Gemini 4 Argon، DeepSeek V4.1 Flash، Qwen3.8 Max و MiMo-V2.6-Pro مقایسه میکنیم و توضیح میدهیم هر عدد واقعاً چه معنایی دارد.
اگر دنبال معرفی مدل، قیمت پلنها و کاربردهای آن هستید، اول بررسی Kimi K3.1 Pro را بخوانید. این مقاله فقط روی عددها تمرکز دارد. یک یادآوری هم دربارهٔ نام: مدلی به اسم «Kimi K3 Pro» وجود ندارد و همهٔ عددهای این مقاله مربوط به Kimi K3.1 Pro است که ۱ آبان ۱۴۰۵ منتشر شد.
آخرین بهروزرسانی: ۲ آبان ۱۴۰۵ — امتیازهای مستقل از Artificial Analysis (شاخص هوش v4.3.2) و LMArena، و امتیازهای رسمی از بلاگ Moonshot AI برداشته شدهاند (دریافت: ۲ آبان ۱۴۰۵).
⚡ پاسخ کوتاه
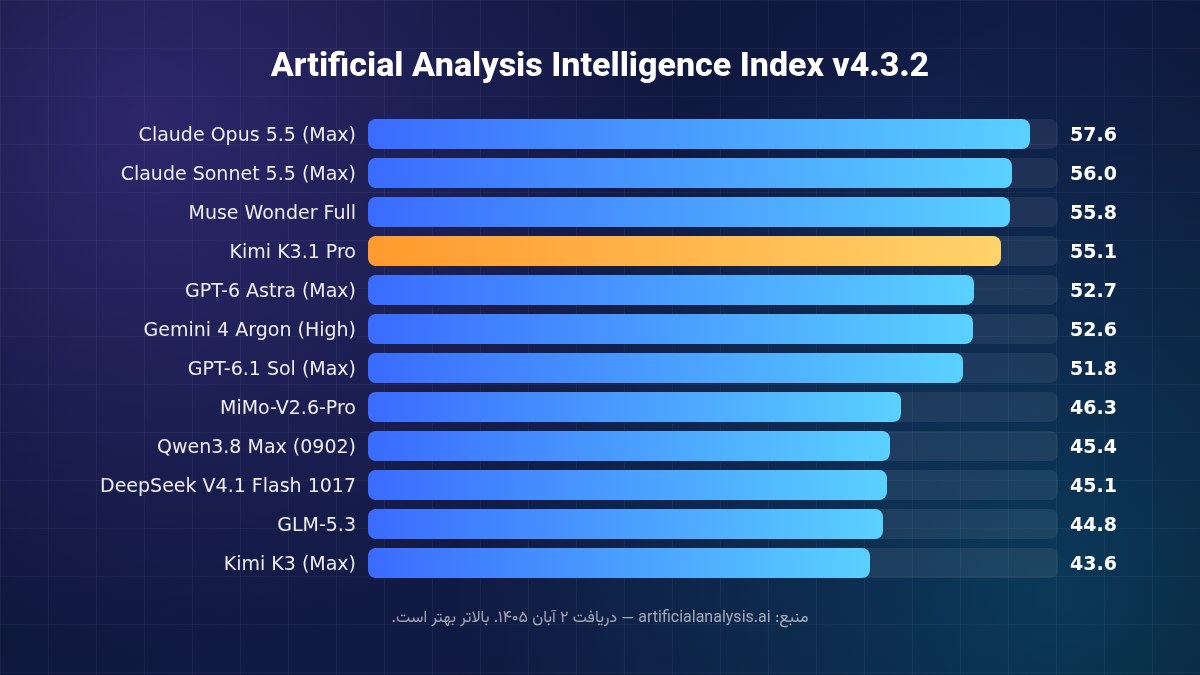
Kimi K3.1 Pro در شاخص هوش Artificial Analysis امتیاز ۵۵.۱ گرفته و چهارم است. فقط Claude Opus 5.5 (۵۷.۶)، Claude Sonnet 5.5 (۵۶.۰) و Muse Wonder Full (۵۵.۸) از آن جلوترند و از GPT-6.1 Sol (۵۱.۸) و Gemini 4 Argon (۵۲.۶) بالاتر است. در Terminal-Bench 4.0 با ۶۷.۲ درصد بالاترین امتیاز ثبتشده را دارد. در مقابل، هزینهٔ هر تسک آن (۲.۱۱ دلار) سه برابر GPT-6.1 Sol است، سرعتش متوسط است (۷۳.۵ توکن در ثانیه) و در LMArena، جدول SWE-bench و شاخص Coding Agent هنوز ثبت نشده است.
هر عدد بنچمارک به سه چیز بستگی دارد: خود مدل، تنظیمات اجرا (سطح استدلال، دما، تعداد تلاش) و «هارنس»، یعنی نرمافزاری که مدل را به ابزارها وصل میکند. سازندهها معمولاً بهترین تنظیمات را برای مدل خودشان انتخاب میکنند. ارزیاب مستقل اما همهٔ مدلها را با یک روش ثابت اجرا میکند. برای همین عددهای رسمی و مستقل برای یک بنچمارک یکسان هم ممکن است فرق کنند. در راهنمای بنچمارکهای هوش مصنوعی این مفاهیم را مفصل توضیح دادهایم.
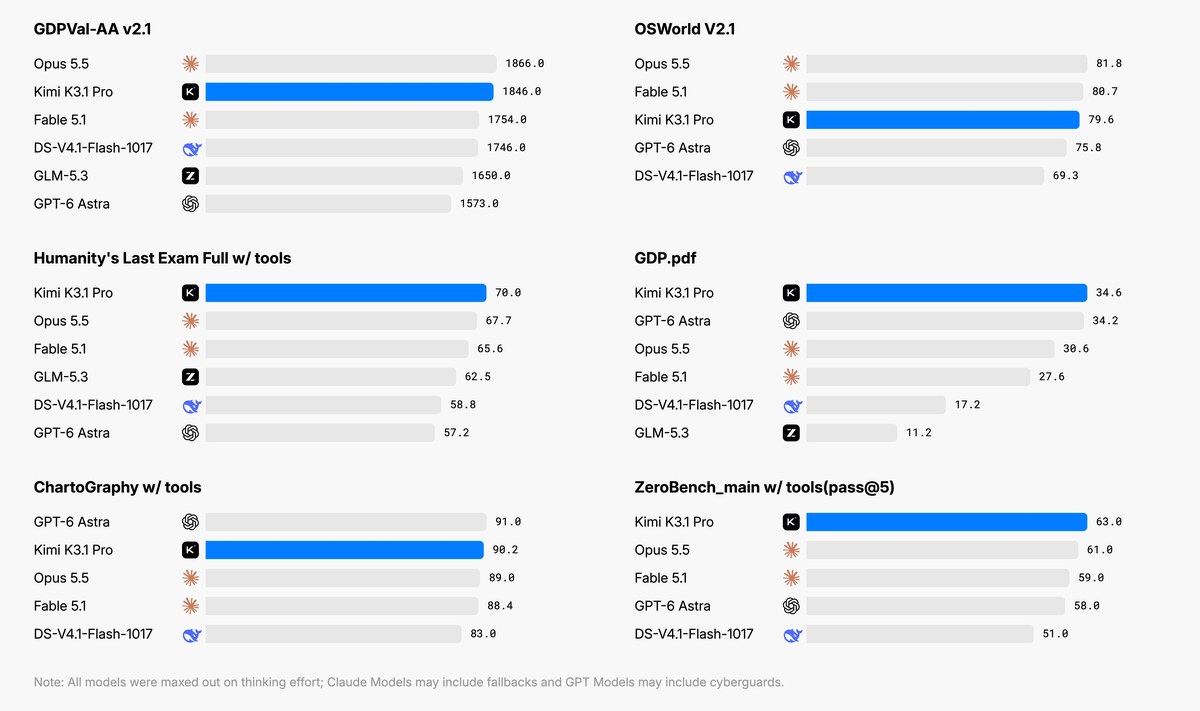
در مورد K3.1 Pro، Moonshot خودش در پانویس نمودارها نوشته است: «همهٔ مدلها با بیشترین سطح استدلال اجرا شدند؛ مدلهای Claude ممکن است شامل fallback و مدلهای GPT شامل محافظهای سایبری باشند.» بنچمارک داخلی Kimi Code Bench با هارنس Claude Code، OSWorld با هارنس Kimi Agent و BrowseComp با دمای ۱.۰ و top-p ۱.۰ اجرا شدهاند.
شاخص هوش Artificial Analysis
شاخص هوش Artificial Analysis (نسخهٔ ۴.۳.۲) میانگین وزنی ۱۰ ارزیابی در چهار دسته است: ایجنتها ۳۰ درصد، کدنویسی ۲۰ درصد، استدلال علمی ۲۰ درصد و عمومی ۳۰ درصد. ارزیابیها اینها هستند: AA-Briefcase، GDPval-AA، AutomationBench-AA، Terminal-Bench 4.0، SciCode، AA-Omniscience، GDP.pdf، AA-LCR، Humanity's Last Exam و CritPt. توضیح کامل روش را در آموزش Artificial Analysis آوردهایم.
امتیاز شاخص هوش Artificial Analysis v4.3.2؛ Kimi K3.1 Pro با ۵۵.۱ چهارم است (۲ آبان ۱۴۰۵). منبع تصویر: تحریریه رادینو
مدل
شاخص هوش
وزنباز؟
قیمت ورودی/خروجی (دلار)
هزینهٔ هر تسک
Claude Opus 5.5 (Max)
۵۷.۶
خیر
۴ / ۲۰
۵.۹۸ دلار
Claude Sonnet 5.5 (Max)
۵۶.۰
خیر
۲ / ۱۰
۵.۴۶ دلار
Kimi K3.1 Pro
۵۵.۱
هنوز نه (وعده: ۱۳ آبان)
۲ / ۱۰
۲.۱۱ دلار
GPT-6 Astra (Max)
۵۲.۷
خیر
۱۰ / ۵۰
۳.۲۶ دلار
Gemini 4 Argon (High)
۵۲.۶
خیر
۲ / ۱۰
۱.۹۹ دلار
GPT-6.1 Sol (Max)
۵۱.۸
خیر
۲ / ۱۰
۰.۷۲ دلار
MiMo-V2.6-Pro
۴۶.۳
بله
۰.۴۳۵ / ۰.۸۷
۰.۱۳ دلار
Qwen3.8 Max (0902)
۴۵.۴
خیر
۲ / ۶
۵.۴۱ دلار
DeepSeek V4.1 Flash 1017 (Max)
۴۵.۱
بله
۰.۳۰ / ۱.۲۰
۰.۲۶ دلار
Kimi K3 (Max)
۴۳.۶
بله
۳ / ۱۵
۲.۰۰ دلار
این عدد چه معنایی دارد؟
فاصلهٔ ۲.۵ امتیازی با صدر: فاصلهٔ K3.1 Pro با Opus 5.5 کمتر از فاصلهٔ Opus 5.5 با GPT-6.1 Sol است. به بیان ساده، K3.1 Pro در ردهٔ اول مدلهای جهان قرار دارد.
جهش ۱۱.۵ امتیازی نسبت به K3: فقط با پسآموزش بیشتر و بدون تغییر مدل پایه، امتیاز از ۴۳.۶ به ۵۵.۱ رسیده است. این بزرگترین جهش یک نسخهٔ میانی در این جدول است.
بستن فاصلهٔ مدلهای باز و بسته: Artificial Analysis نوشته که وقتی وزنها منتشر شوند، فاصلهٔ بهترین مدل وزنباز با بهترین مدل اختصاصی از ۱۲ امتیاز به ۳ امتیاز میرسد. امروز بهترین مدل وزنباز این جدول MiMo-V2.6-Pro با ۴۶.۳ است.
اختصاصی تا اطلاع ثانوی: تا ۲ آبان ۱۴۰۵ وزنها منتشر نشده و Artificial Analysis مدل را «Proprietary» ثبت کرده است.
سرعت، تأخیر و هزینهٔ واقعی
شاخص هوش فقط یک بُعد است. در محیط واقعی، اینکه پاسخ چقدر طول میکشد و اجرای یک کار واقعاً چقدر هزینه دارد، به همان اندازه مهم است. Artificial Analysis اینها را جداگانه اندازه میگیرد. سرعت میانهٔ توکنهای خروجی روی API رسمی هر سازنده محاسبه میشود.
مدل
سرعت خروجی (توکن/ثانیه)
توکن خروجی برای کل شاخص
هزینهٔ هر تسک
Kimi K3.1 Pro
۷۳.۵
۱۴۸ میلیون
۲.۱۱ دلار
Claude Opus 5.5 (Max)
۹۶.۳
۲۶۰ میلیون
۵.۹۸ دلار
GPT-6.1 Sol (Max)
۵۷.۳
۶۷ میلیون
۰.۷۲ دلار
Gemini 4 Argon (High)
۷۹.۱
۱۱۳ میلیون
۱.۹۹ دلار
DeepSeek V4.1 Flash 1017 (Max)
۱۹۵.۲
۲۱۱ میلیون
۰.۲۶ دلار
Qwen3.8 Max (0902)
۴۱.۸
۱۹۲ میلیون
۵.۴۱ دلار
MiMo-V2.6-Pro
۵۴.۸
۱۴۴ میلیون
۰.۱۳ دلار
Kimi K3 (Max)
۴۰.۶
۱۶۱ میلیون
۲.۰۰ دلار
سه نکته از این جدول بیرون میآید:
K3.1 Pro نسبت به K3 تقریباً دو برابر سریعتر شده است (از ۴۰.۶ به ۷۳.۵ توکن در ثانیه). با این حال هنوز از Opus 5.5 و Gemini 4 Argon کندتر است و DeepSeek V4.1 Flash بیش از ۲.۵ برابر از آن سریعتر است.
قیمت اسمی برابر، هزینهٔ واقعی متفاوت: K3.1 Pro، GPT-6.1 Sol و Gemini 4 Argon همه ۲/۱۰ دلار قیمت دارند. اما هزینهٔ هر تسک بهترتیب ۲.۱۱، ۰.۷۲ و ۱.۹۹ دلار است. دلیلش تعداد توکنهایی است که هر مدل برای فکر کردن و پاسخ دادن مصرف میکند. K3.1 Pro بهطور میانگین برای هر تسک ۵۵ هزار توکن خروجی تولید میکند و GPT-6.1 Sol حدود ۳۸ هزار توکن.
زمان تا اولین توکن پاسخ: K3.1 Pro بهطور میانگین بعد از ۲.۹۷ ثانیه اولین توکن را میفرستد، اما چون ابتدا فکر میکند، اولین توکن پاسخ واقعی حدود ۳۰.۲ ثانیه بعد میرسد.
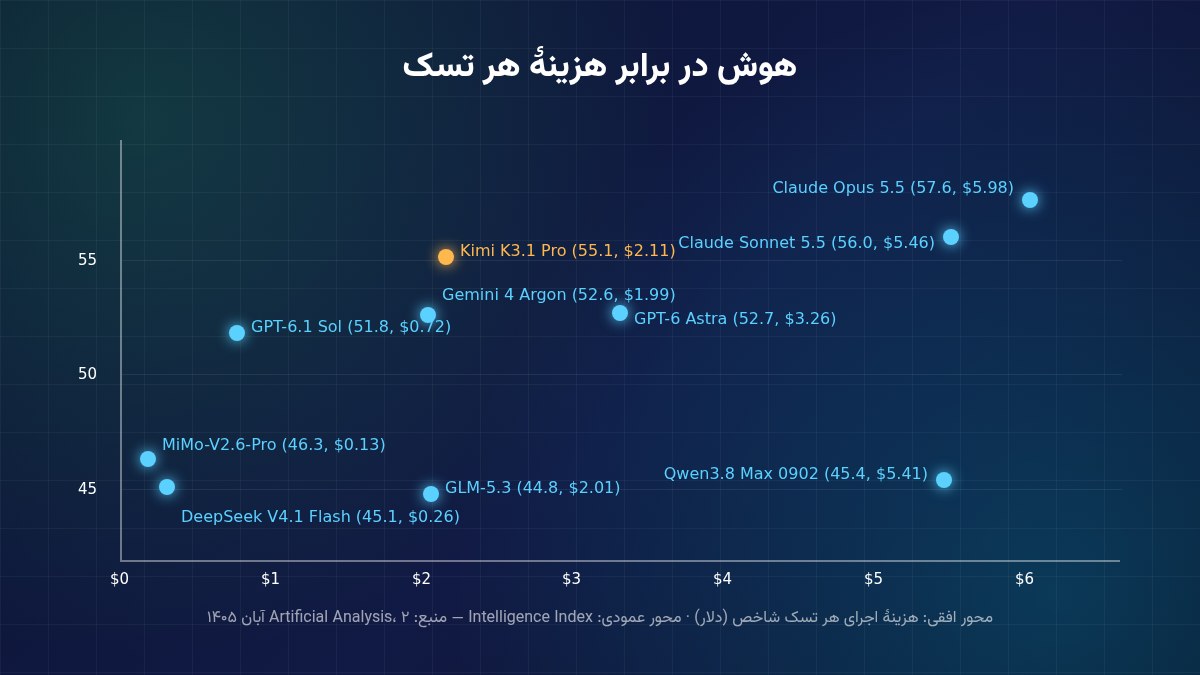
هوش در برابر هزینهٔ هر تسک؛ مدلهای بالا-چپ نمودار بهترین نسبت هوش به هزینه را دارند. منبع تصویر: تحریریه رادینو
در نمودار بالا، K3.1 Pro در میانهٔ بالایی قرار دارد. با هزینهای نزدیک Gemini 4 Argon، هوش بیشتری میدهد و با کمتر از نصف هزینهٔ Opus 5.5، فقط ۲.۵ امتیاز کمتر است. اگر اولویت شما کمترین هزینه است، GPT-6.1 Sol، MiMo-V2.6-Pro و DeepSeek V4.1 Flash کارآمدترند. برای محاسبهٔ دقیق هزینه با حجم کار خودتان، راهنمای قیمت API مدلهای هوش مصنوعی را ببینید. یک نکته هم دربارهٔ اختلاف عددها: مقالهٔ معرفی Artificial Analysis در روز انتشار هزینهٔ هر تسک را ۱.۹۸ دلار نوشته بود، اما صفحهٔ مدل در ۲ آبان ۱۴۰۵ عدد ۲.۱۱ دلار را نشان میدهد. احتمالاً دلیلش بهروزرسانی نرخ کش است. ما عدد صفحهٔ مدل را استفاده کردهایم.
ادعای رسمی در برابر سنجش مستقل
حالا ببینیم عددهای Moonshot وقتی Artificial Analysis همان بنچمارکها را اجرا میکند چقدر تأیید میشوند. فقط بنچمارکهایی را آوردهایم که هر دو طرف اجرا کردهاند.
بنچمارک
عدد رسمی Moonshot
عدد Artificial Analysis
تفسیر
Terminal-Bench 4.0
۶۵.۷٪
۶۷.۲٪
تأیید شد؛ حتی کمی بالاتر
GDPval-AA (Elo)
۱۸۴۶
۱۸۴۶
کاملاً یکسان (Moonshot عدد AA را نقل کرده است)
Humanity's Last Exam
۷۰.۰ (با ابزار)
۵۲.۵ (بدون ابزار)
تنظیمات متفاوت؛ قابل مقایسه نیست
Terminal-Bench Science
۳۸.۱٪
۳۴.۳٪
نزدیک؛ نقطهضعف تأیید شد
GDP.pdf
۳۴.۶
۳۱.۴
کمی پایینتر در سنجش مستقل
توهم
۸.۳٪ (Kimi Hallu Bench Hard)
۴۳.۹٪ (AA-Omniscience)
دو آزمون کاملاً متفاوت
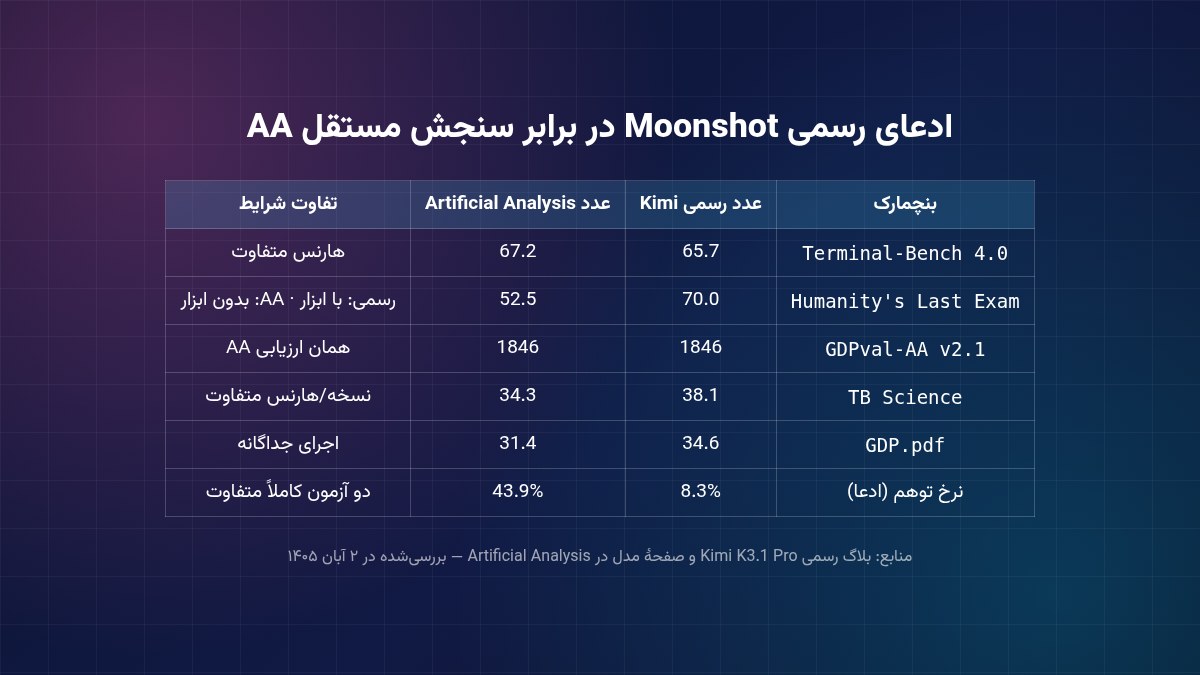
ادعاهای رسمی Moonshot در کنار سنجش مستقل Artificial Analysis. منبع تصویر: تحریریه رادینو
جمعبندی این بخش: ادعاهای اصلی Moonshot دربارهٔ کدنویسی ترمینالی و کارهای دانشی با سنجش مستقل تأیید میشوند. اختلاف HLE بهخاطر ابزار است. با ابزار جستوجو و کد، امتیاز همهٔ مدلها بالا میرود، و Artificial Analysis این آزمون را بدون ابزار اجرا میکند. اختلاف بزرگ عدد توهم هم به این خاطر است که دو آزمون کاملاً متفاوت چیزهای متفاوتی میسنجند.
کدنویسی: Terminal-Bench، SWE-bench و ایجنتها
Terminal-Bench 4.0
Terminal-Bench وظایف واقعی را در محیط ترمینال لینوکس میسنجد: نصب، دیباگ، ساخت و اجرای پروژه. در اجرای Artificial Analysis، K3.1 Pro با ۶۷.۲ درصد بالاترین امتیاز بین همهٔ مدلها را دارد. Claude Sonnet 5.5 با ۶۳.۶، Claude Opus 5.5 با ۵۹.۶، GPT-6 Astra با ۵۹.۱، Gemini 4 Argon با ۵۷.۱ و GPT-6.1 Sol با ۵۶.۱ بعد از آن قرار دارند. K3 نسل قبل فقط ۱۲.۶ درصد گرفته بود و این بزرگترین جهش در کل گزارش است.
مدل
Terminal-Bench 4.0 (AA)
Terminal-Bench Science (AA)
SciCode (AA)
Kimi K3.1 Pro
۶۷.۲٪
۳۴.۳٪
۶۰.۸٪
Claude Opus 5.5
۵۹.۶٪
۵۹.۰٪
۶۶.۹٪
GPT-6.1 Sol
۵۶.۱٪
۵۸.۱٪
۵۴.۲٪
Gemini 4 Argon
۵۷.۱٪
۵۲.۹٪
۶۱.۸٪
DeepSeek V4.1 Flash 1017
۳۳.۸٪
۱۲.۹٪
۵۵.۹٪
Qwen3.8 Max (0902)
۳۸.۹٪
۱۱.۹٪
۵۲.۱٪
MiMo-V2.6-Pro
۳۴.۸٪
۵.۷٪
۶۰.۹٪
تصویر کاملتر این است: K3.1 Pro در کارهای مهندسی نرمافزار ترمینالی پیشتاز است، اما در Terminal-Bench Science که شامل وظایف علمی (زیست، فیزیک، ریاضی) در ترمینال است، با ۳۴.۳ درصد فاصلهٔ زیادی با Opus 5.5 (۵۹.۰) و GPT-6.1 Sol (۵۸.۱) دارد. در SciCode هم پشت Opus 5.5 و Gemini 4 Argon است.
SWE-bench
SWE-bench معروفترین بنچمارک رفع باگ در مخزنهای واقعی گیتهاب است. تا ۲ آبان ۱۴۰۵ در جدول رسمی SWE-bench فقط مدلهای قدیمیتر Kimi (سری K2 و K2.5) ثبت شده بودند و امتیازی برای K3.1 Pro منتشر نشده بود. Moonshot هم در بلاگ معرفی عدد SWE-bench Verified اعلام نکرده است. به جای آن، روی SWE Marathon (کارهای طولانی مهندسی) تمرکز کرده و امتیاز ۵۱.۷ درصد را گزارش کرده که از Opus 5.5 (۴۶.۳) بالاتر است. این عدد را هنوز ارزیاب مستقلی تأیید نکرده است.
شاخص ایجنت کدنویسی (Coding Agent Index)
Artificial Analysis در شاخص ایجنتهای کدنویسی ترکیب «ابزار + مدل» را میسنجد، مثلاً Claude Code با Opus یا Codex با GPT. در ۲ آبان ۱۴۰۵ صدر این جدول Claude Code با Claude Opus 5.5 با امتیاز ۶۱.۷ بود. تنها ورودی Kimi در این جدول Kimi Code CLI با مدل نسل قبل (K3) است که امتیاز ۴۱.۴ و هزینهٔ میانگین ۵.۱۷ دلار برای هر تسک دارد. K3.1 Pro هنوز در این شاخص ارزیابی نشده است. با توجه به جهش Terminal-Bench انتظار میرود امتیاز آن بالاتر برود، اما تا عدد رسمی منتشر نشده، نمیشود دربارهاش قضاوت کرد. اگر ابزار کدنویسی انتخاب میکنید، مقالهٔ بهترین هوش مصنوعی برای برنامهنویسی را ببینید.
⚠️ بهروزرسانی نسبت به مقالههای قبلی رادینو: دادههای ۲۷ مهر ۱۴۰۵ صدر این شاخص را Sonnet 5.5 با ۶۸.۴ نشان میداد. در ۲ آبان ۱۴۰۵ ترکیب Claude Code + Opus 5.5 با ۶۱.۷ در صدر است. این جدول با اضافه شدن ترکیبهای جدید و نسخههای جدید بنچمارکها مرتب تغییر میکند. همیشه تاریخ داده را کنار عدد ببینید.
استدلال و دانش: HLE، GPQA و توهم
Humanity's Last Exam (HLE)
HLE مجموعهای از ۲,۱۵۸ پرسش بسیار سخت در رشتههای مختلف است که Artificial Analysis آن را بدون ابزار اجرا میکند. K3.1 Pro در این آزمون ۵۲.۵ درصد گرفته است (K3: ۴۶.۹). Opus 5.5 با ۶۱.۴، Gemini 4 Argon با ۵۷.۱ و GPT-6.1 Sol با ۵۲.۹ جلوترند. DeepSeek V4.1 Flash 1017 ۴۳.۳ و Qwen3.8 Max (0902) ۴۳.۱ گرفتهاند و MiMo-V2.6-Pro ۴۹.۴. یعنی در استدلال خالص بدون ابزار، K3.1 Pro همردهٔ GPT-6.1 Sol است، اما از صدر فاصله دارد. عدد ۷۰.۰ رسمی Moonshot «با ابزار» است و نباید آن را با این عددها مقایسه کرد.
GPQA Diamond
GPQA Diamond شامل ۱۹۸ پرسش تخصصی زیست، فیزیک و شیمی است. Artificial Analysis این آزمون را به بخش «ارزیابیهای قدیمی» (Legacy) منتقل کرده و در شاخص v4.3.2 حساب نمیکند. برای K3.1 Pro هم عدد GPQA مستقلی منتشر نشده است. Moonshot برای K3.1 Pro عدد GPQA اعلام نکرده است. فقط برای K3 در کارت مدل Hugging Face عدد ۹۳.۵ ثبت شده است. دلیل کنار گذاشتن این آزمون ساده است: مدلهای پیشرو همه بالای ۹۰ درصد میگیرند و GPQA دیگر آنها را از هم تفکیک نمیکند.
توهم و دانش واقعی (AA-Omniscience)
AA-Omniscience شامل ۶,۰۰۰ پرسش دانشی است و دو چیز را جداگانه میسنجد: دقت، و نرخ توهم، یعنی اینکه مدل وقتی جواب را نمیداند، چقدر بهجای «نمیدانم» جواب غلط میدهد.
مدل
دقت
نرخ توهم (کمتر بهتر)
شاخص Omniscience
Kimi K3.1 Pro
۵۱.۰٪
۴۳.۹٪
۲۹.۵
Claude Opus 5.5
۶۶.۲٪
۵۸.۶٪
۴۶.۴
GPT-6.1 Sol
۶۲.۱٪
۵۴.۳٪
۴۱.۵
Gemini 4 Argon
۴۹.۹٪
۱۵.۱٪
۴۲.۴
DeepSeek V4.1 Flash 1017
۴۲.۸٪
۶۶.۸٪
۴.۷
Qwen3.8 Max (0902)
۳۱.۷٪
۲۸.۸٪
۱۲.۰
MiMo-V2.6-Pro
۳۴.۸٪
۴۰.۶٪
۸.۴
Kimi K3 (Max)
۴۷.۶٪
۵۳.۲٪
۱۹.۷
نتیجه این است که K3.1 Pro نسبت به K3 کمتر توهم میزند (از ۵۳ درصد به ۴۴ درصد)، اما هنوز با Gemini 4 Argon (۱۵ درصد) فاصلهٔ زیادی دارد. نرخ توهم Opus 5.5 و GPT-6.1 Sol بالاتر است، ولی دقت آنها هم خیلی بیشتر است. ادعای ۸.۳ درصدی Moonshot مربوط به آزمون داخلی دیگری است و با این عدد قابل مقایسه نیست.
کارهای دانشی و ایجنتی
شاید مهمترین پیشرفت K3.1 Pro در کارهای دانشی ایجنتی باشد، یعنی کارهایی که مدل باید فایل بسازد، با ابزار کار کند و خروجی حرفهای تحویل بدهد. در GDPval-AA، که خروجی مدلها را در کارهای واقعی اقتصادی بهصورت زوجی مقایسه میکند، K3.1 Pro با Elo ۱۸۴۶ سوم است. این امتیاز ۳۱۲ واحد بالاتر از K3 است و فقط Opus 5.5 (۱۸۶۶) و Muse Wonder Full (۱۸۵۷) جلوترند. GPT-6.1 Sol در این آزمون ۱۵۹۶ و Gemini 4 Argon ۱۶۲۴ گرفتهاند. در AutomationBench-AA، که خودکارسازی گردشکار SaaS را میسنجد، امتیاز از ۵۸ به ۷۳ درصد رسیده است.
نتایج رسمی Moonshot در کارهای دانشی و ایجنتی؛ همهٔ مدلها با بیشترین سطح استدلال اجرا شدهاند. منبع تصویر: Moonshot AI / Kimi
در نمودار رسمی بالا، K3.1 Pro در OSWorld V2.1، که کار با رابط گرافیکی کامپیوتر است، ۷۹.۶ گرفته و پشت Opus 5.5 (۸۱.۸) و Fable 5.1 (۸۰.۷) است. در ZeroBench با ابزار هم با ۶۳.۰ اول است. چند بنچمارک دیگر مثل DeepSWE، PostTrainBench، ProgramBench، MCP Atlas، BrowseComp و HLE-Diamond در پانویس بلاگ نام برده شدهاند، اما در نمودارهای منتشرشده عددی برایشان نیامده است. پس ما هم عددی برایشان گزارش نمیکنیم.
LMArena: نظر کاربران چیست؟
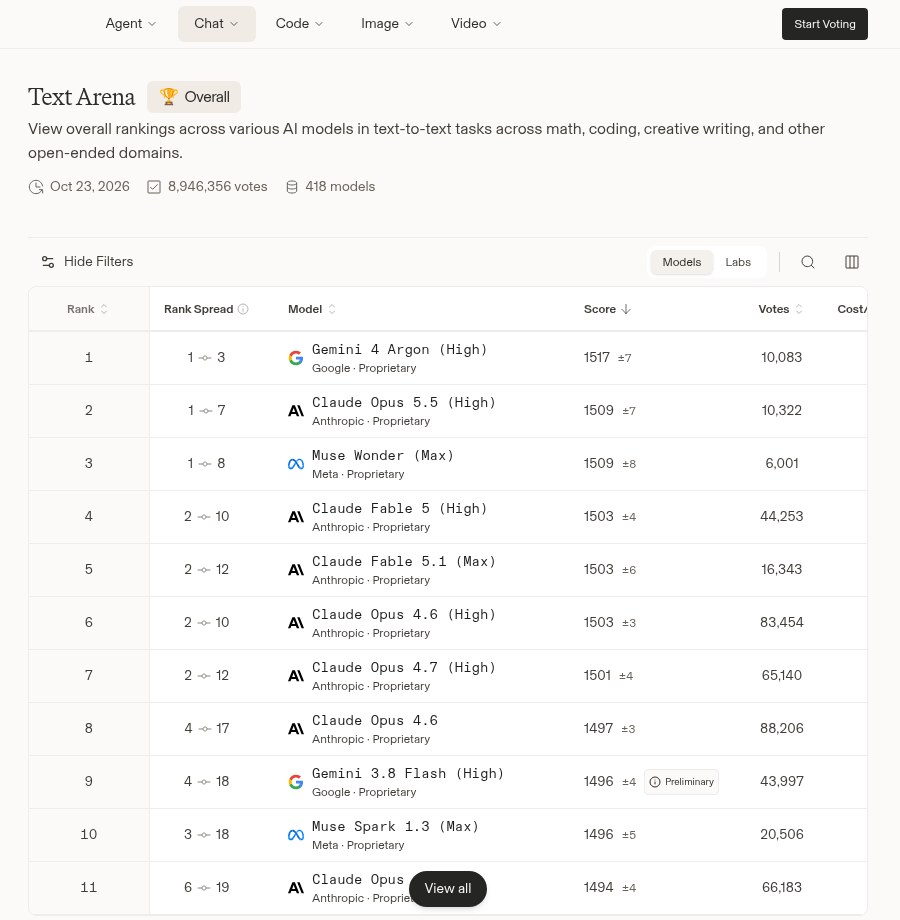
LMArena برخلاف بنچمارکهای خودکار، از رأی کاربران واقعی در مقایسههای کور دوبهدو استفاده میکند. جدول Text Arena در تاریخ ۱ آبان ۱۴۰۵ (۲۳ اکتبر ۲۰۲۶) بر اساس ۸,۹۴۶,۳۵۶ رأی و ۴۱۸ مدل بهروز شده بود. صدر جدول Gemini 4 Argon (High) با ۱۵۱۷ امتیاز است و Claude Opus 5.5 (High) و Muse Wonder (Max) هر دو با ۱۵۰۹ بعد از آن قرار دارند.
جدول Text Arena در LMArena؛ Kimi K3.1 Pro هنوز در این جدول ثبت نشده است (۲ آبان ۱۴۰۵). منبع تصویر: LMArena
K3.1 Pro هنوز در LMArena نیست. رسیدن به تعداد رأی کافی برای ثبت امتیاز پایدار معمولاً زمان میبرد. بهترین مدل Kimi در جدول فعلی Kimi K3 (Max) است که رتبهٔ ۱۸ را با امتیاز ۱۴۸۷ (±۴) دارد. اگر K3.1 Pro هم مثل شاخص AA جهش کند، میتواند وارد ده مدل اول شود، اما این فقط یک گمان است. وقتی امتیاز منتشر شد، این بخش را بهروز میکنیم.
جدول خلاصه: Kimi K3.1 Pro در برابر رقبا
معیار
Kimi K3.1 Pro
Claude Opus 5.5
GPT-6.1 Sol
Gemini 4 Argon
DeepSeek V4.1 Flash
MiMo-V2.6-Pro
شاخص هوش AA
۵۵.۱
۵۷.۶
۵۱.۸
۵۲.۶
۴۵.۱
۴۶.۳
Terminal-Bench 4.0
۶۷.۲٪
۵۹.۶٪
۵۶.۱٪
۵۷.۱٪
۳۳.۸٪
۳۴.۸٪
HLE (بدون ابزار)
۵۲.۵٪
۶۱.۴٪
۵۲.۹٪
۵۷.۱٪
۴۳.۳٪
۴۹.۴٪
GDPval-AA (Elo)
۱۸۴۶
۱۸۶۶
۱۵۹۶
۱۶۲۴
۱۷۴۶
۱۶۸۳
AA-LCR (زمینهٔ طولانی)
۸۶.۳٪
۸۴.۷٪
۸۳.۰٪
۷۹.۷٪
۸۲.۷٪
۸۶.۳٪
نرخ توهم
۴۳.۹٪
۵۸.۶٪
۵۴.۳٪
۱۵.۱٪
۶۶.۸٪
۴۰.۶٪
سرعت (توکن/ث)
۷۳.۵
۹۶.۳
۵۷.۳
۷۹.۱
۱۹۵.۲
۵۴.۸
هزینهٔ هر تسک
۲.۱۱$
۵.۹۸$
۰.۷۲$
۱.۹۹$
۰.۲۶$
۰.۱۳$
LMArena Text
ثبت نشده
۱۵۰۹
—
۱۵۱۷
—
—
در ردیف LMArena، خط تیره یعنی ما امتیاز آن مدل را در بخش دیدهشدهٔ جدول در ۲ آبان ثبت نکردیم، نه اینکه مدل حتماً در آرنا نیست. ستون DeepSeek مربوط به نسخهٔ V4.1 Flash 1017 (Max) است.
خوانش نهایی عددها
برای ایجنتهای کدنویسی ترمینالی: K3.1 Pro بهترین امتیاز مستقل را دارد و نصف Opus 5.5 قیمت دارد. باید منتظر ثبتش در Coding Agent Index ماند تا ترکیب ابزار و مدل هم سنجیده شود.
برای کارهای دانشی و اسناد: رتبهٔ سوم GDPval و امتیاز ۸۶.۳ در AA-LCR آن را کنار بهترینها قرار میدهد.
برای استدلال علمی بدون ابزار: Opus 5.5 و Gemini 4 Argon برتری روشنی دارند.
برای حجم بالا و هزینهٔ کم: GPT-6.1 Sol، MiMo-V2.6-Pro و DeepSeek V4.1 Flash اقتصادیترند.
برای دقت اطلاعات: Gemini 4 Argon کمترین توهم را دارد. برای مقایسهٔ کلی مدلها، رتبهبندی مدلهای هوش مصنوعی را هم ببینید.
سؤالات متداول
Kimi K3.1 Pro در Artificial Analysis چه رتبهای دارد؟
رتبهٔ ۴ با امتیاز ۵۵.۱ در شاخص هوش v4.3.2 (۲ آبان ۱۴۰۵)، پشت Claude Opus 5.5، Claude Sonnet 5.5 و Muse Wonder Full.
امتیاز SWE-bench مدل Kimi K3.1 Pro چقدر است؟
تا ۲ آبان ۱۴۰۵ امتیازی منتشر نشده است. نه Moonshot عدد SWE-bench Verified اعلام کرده و نه جدول رسمی SWE-bench آن را ثبت کرده است. Moonshot به جای آن عدد ۵۱.۷ درصد در SWE Marathon را گزارش کرده است.
آیا Kimi K3.1 Pro از GPT-6.1 Sol بهتر است؟
در شاخص هوش AA (۵۵.۱ در برابر ۵۱.۸)، Terminal-Bench 4.0 (۶۷.۲ در برابر ۵۶.۱) و GDPval بله. در HLE تقریباً برابرند. اما GPT-6.1 Sol با هزینهٔ ۰.۷۲ دلار برای هر تسک حدود یکسوم K3.1 Pro خرج دارد.
Kimi K3.1 Pro در LMArena چه رتبهای دارد؟
هنوز ثبت نشده است. بهترین مدل Kimi در Text Arena، یعنی Kimi K3 (Max)، با امتیاز ۱۴۸۷ رتبهٔ ۱۸ را دارد.
چرا عدد HLE رسمی ۷۰ است ولی Artificial Analysis ۵۲.۵ گزارش میکند؟
عدد ۷۰.۰ رسمی Moonshot با ابزار (جستوجو و اجرای کد) گرفته شده است. Artificial Analysis این آزمون را بدون ابزار اجرا میکند. این دو عدد قابل مقایسه نیستند.
سرعت Kimi K3.1 Pro چقدر است؟
طبق Artificial Analysis، سرعت میانهٔ خروجی روی API رسمی ۷۳.۵ توکن در ثانیه است. نسخهٔ Highspeed به گفتهٔ Moonshot ۲ تا ۳ برابر سریعتر است، اما Artificial Analysis هنوز آن را جداگانه اندازه نگرفته است.
جمعبندی
بنچمارکهای مستقل ادعای اصلی Moonshot را تأیید میکنند: Kimi K3.1 Pro در ردهٔ اول مدلهای جهان است، در کدنویسی ترمینالی بالاترین امتیاز ثبتشده را دارد و در کارهای دانشی سوم است. در مقابل، در استدلال علمی بدون ابزار و دقت اطلاعات از بهترینها عقبتر است و هزینهٔ هر تسک آن بهخاطر پرحرفی از قیمت اسمیاش بیشتر است. دادههای LMArena، SWE-bench و Coding Agent Index هنوز منتشر نشدهاند و تصویر کامل چند هفتهٔ دیگر روشن میشود. برای شناخت مدل، قیمت پلنها و نحوهٔ استفاده، بررسی کامل Kimi K3.1 Pro را بخوانید. اگر میخواهید کار با این مدلها را عملی یاد بگیرید، دورهٔ کپسول هوش مصنوعی رادینو را ببینید.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.