وقتی میخواهید یک مدل متنباز مثل DeepSeek V4.1 Flash یا gpt-oss-120b را در محصولتان استفاده کنید، با یک سؤال غافلگیرکننده روبهرو میشوید: از کدام شرکت؟ همین یک مدل را دهها ارائهدهندهٔ API مثل Groq، Cerebras، Together AI، Fireworks، DeepInfra و Baseten سرو میکنند و سرعت و قیمتشان گاهی دهها برابر با هم فرق دارد. سرویسهایی مثل OpenRouter هم آمدهاند که همهٔ اینها را پشت یک API واحد جمع میکنند.
در این مقاله میبینیم ارائهدهندهٔ API (Inference Provider) دقیقاً چیست، چرا یک مدل اینقدر متفاوت اجرا میشود، OpenRouter چطور کار میکند و چطور ارائهدهندهٔ مناسب پروژهتان را انتخاب کنید. برای جدول قیمت خود مدلها، راهنمای قیمت API مدلهای هوش مصنوعی را ببینید؛ اینجا تمرکز روی شرکتهایی است که مدل را اجرا میکنند.
آخرین بهروزرسانی: ۹ آبان ۱۴۰۵ — دادههای سرعت و هزینهٔ هر تسک از جدول ارائهدهندگان Artificial Analysis و قیمتها از صفحههای رسمی Groq، Together AI و OpenRouter در همین تاریخ برداشته شدهاند. اعداد به دلار هستند و مرتب تغییر میکنند.
⚡ پاسخ کوتاه
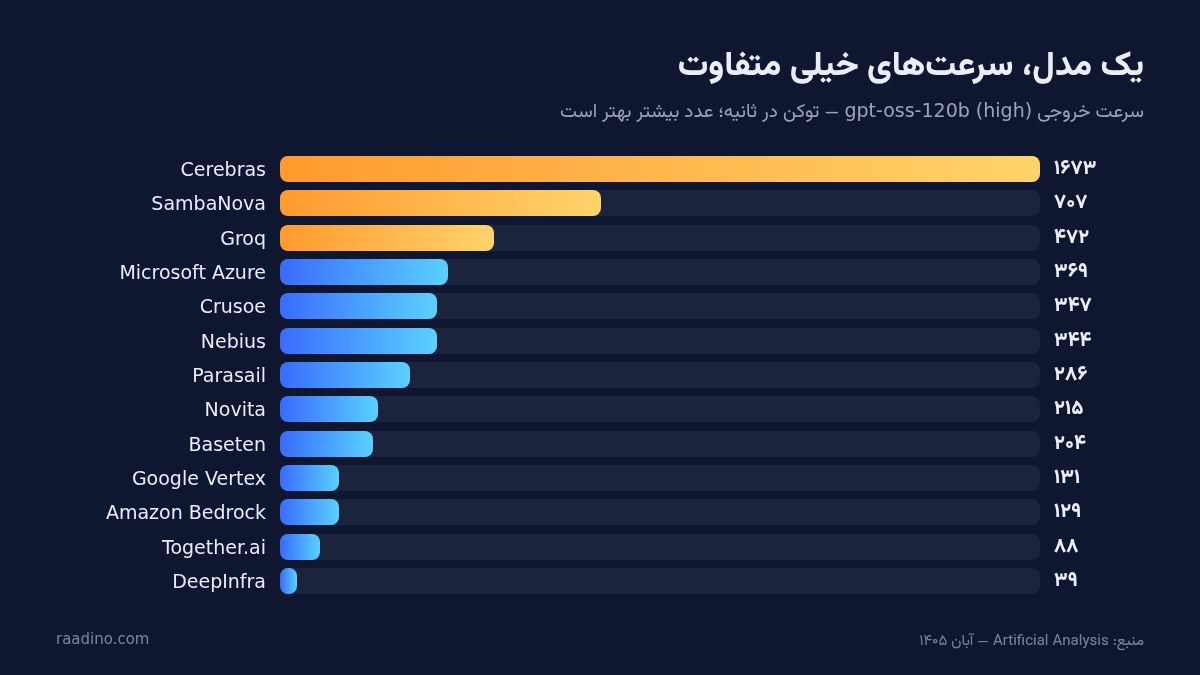
ارائهدهندهٔ API شرکتی است که مدل (معمولاً متنباز) را روی سختافزار خودش اجرا میکند و از طریق API میفروشد. طبق Artificial Analysis، مدل gpt-oss-120b روی Cerebras حدود ۱٬۶۷۳ توکن در ثانیه خروجی میدهد، روی Groq حدود ۴۷۲ و روی برخی ارائهدهندههای GPU زیر ۱۰۰. OpenRouter یک واسط است که بیش از ۶۰۰ مدل از ۸۰+ ارائهدهنده را با یک کلید و API سازگار با OpenAI میدهد؛ روی قیمت توکن سود نمیکشد و ۵٫۵ درصد کارمزد خرید اعتبار میگیرد. برای انتخاب، سه چیز را با هم بسنجید: سرعت، هزینهٔ واقعی هر تسک و پایداری؛ نه فقط قیمت روی کاغذ.
در دنیای مدلهای زبانی سه نقش را باید از هم جدا کرد:
سازندهٔ مدل: شرکتی که مدل را آموزش میدهد؛ مثل OpenAI، DeepSeek یا Alibaba.
ارائهدهندهٔ استنتاج (Inference Provider): شرکتی که مدل را روی سرورهایش اجرا میکند و به ازای هر توکن پول میگیرد؛ مثل Groq، Cerebras، Together AI، Fireworks، DeepInfra، Baseten یا Nebius.
واسط یا روتر (Aggregator): سرویسی که چند ارائهدهنده را پشت یک API جمع میکند و درخواست شما را به یکی از آنها میفرستد؛ مثل OpenRouter.
مدلهای بسته مثل Claude یا GPT-6 معمولاً فقط از طریق خود سازنده یا ابرهای بزرگ (مثل Amazon Bedrock، Google Vertex و Microsoft Azure) در دسترساند. اما مدلهای متنباز را هر کسی میتواند اجرا کند و همین باعث شده بازار ارائهدهندهها شلوغ شود. برای آشنایی با خود این مدلها، بهترین مدلهای متنباز هوش مصنوعی را ببینید.
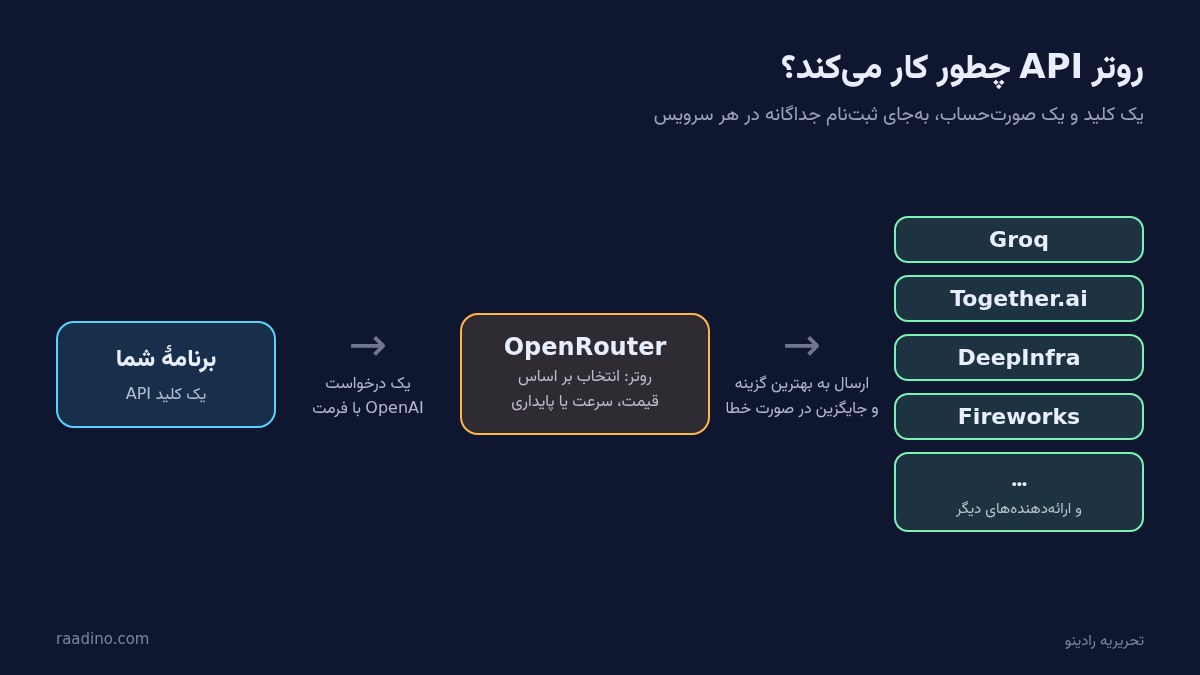
برنامهٔ شما با یک کلید به روتر وصل میشود و روتر درخواست را بر اساس قیمت، سرعت یا پایداری به یکی از ارائهدهندهها میفرستد. منبع تصویر: تحریریه رادینو
چرا یک مدل اینقدر متفاوت اجرا میشود؟
مدل یکی است، اما تجربهٔ شما نه. چهار عامل اصلی این تفاوت را میسازند:
سختافزار: Groq با تراشهٔ اختصاصی LPU و Cerebras با تراشههای ویفری بزرگ ساخته شدهاند تا تولید توکن را بسیار سریع کنند؛ بیشتر بقیه روی GPUهای NVIDIA کار میکنند.
کوانتیزهسازی: برخی ارائهدهندهها مدل را با دقت پایینتر (مثلاً FP8 یا FP4) اجرا میکنند تا ارزانتر و سریعتر شود. این کار ممکن است کیفیت را کمی پایین بیاورد.
تنظیمات سرو: طول کانتکست مجاز، سقف خروجی، پشتیبانی از tool calling و structured output بین ارائهدهندهها یکسان نیست.
بار سرور: در ساعتهای شلوغ سرعت و تأخیر یک ارائهدهنده میتواند محسوس تغییر کند.
نمودار زیر سرعت خروجی همان مدل gpt-oss-120b (سطح استدلال high) را روی ارائهدهندههای مختلف نشان میدهد. فاصلهٔ سریعترین و کندترین بیش از ۴۰ برابر است. برای اینکه بدانید این اعداد چطور اندازه گرفته میشوند، مقالهٔ سرعت مدل هوش مصنوعی را بخوانید.
سرعت خروجی gpt-oss-120b (high) بر حسب توکن در ثانیه روی ارائهدهندههای مختلف. منبع تصویر: تحریریه رادینو بر اساس Artificial Analysis
معرفی مهمترین ارائهدهندههای API
OpenRouter؛ یک کلید برای همهٔ مدلها
OpenRouter خودش مدل اجرا نمیکند؛ یک روتر است. طبق صفحهٔ قیمتگذاری رسمی، در پلن Standard بیش از ۶۰۰ مدل از بیش از ۸۰ ارائهدهنده در دسترس است و API آن با استاندارد OpenAI سازگار است، پس معمولاً فقط با عوضکردن آدرس پایه و کلید، کد فعلیتان کار میکند. OpenRouter روی قیمت توکن سود نمیکشد و قیمت فهرست ارائهدهنده را حساب میکند؛ درآمدش از کارمزد ۵٫۵ درصدی خرید اعتبار (۸ درصد در پلن Business) است. بیش از ۲۵ مدل رایگان هم دارد که محدودیت درخواست پایینی دارند و برای محیط واقعی مناسب نیستند.
با پارامتر provider میتوانید رفتار روتر را کنترل کنید: sort برای مرتبسازی بر اساس قیمت، سرعت (throughput) یا تأخیر؛ order برای ترتیب دلخواه؛ only و ignore برای محدودکردن ارائهدهندهها؛ quantizations برای حذف نسخههای کمدقت؛ و data_collection: "deny" برای استفادهنکردن از ارائهدهندههایی که ممکن است داده را ذخیره کنند. پسوند :nitro روی نام مدل سریعترین و :floor ارزانترین ارائهدهنده را انتخاب میکند.
نمونهٔ درخواست OpenRouter با ترجیح سرعت و حذف نسخههای کمدقت
Groq با تراشهٔ اختصاصی LPU شناخته میشود و حالا آن را کنار GPUهای NVIDIA هم به کار میگیرد. در مستندات رسمی، gpt-oss-120b با سرعت حدود ۵۰۰ توکن در ثانیه و قیمت ۰٫۱۵ دلار ورودی و ۰٫۶ دلار خروجی به ازای هر میلیون توکن ارائه میشود و gpt-oss-20b با حدود ۱۰۰۰ توکن در ثانیه و نصف این قیمت. فهرست مدلهای Groq کوتاهتر از رقباست و برخی مدلها مثل Llama 3.3 70B فقط برای مشتریان سازمانی است.
Cerebras؛ سریعترین در اندازهگیری مستقل
Cerebras در جدول Artificial Analysis با حدود ۱٬۶۷۳ توکن در ثانیه برای gpt-oss-120b سریعترین ارائهدهندهٔ این مدل است و زمان رسیدن اولین توکنش هم حدود ۰٫۴ ثانیه است. خود Cerebras سرعت این مدل را حدود ۳۰۰۰ توکن در ثانیه اعلام میکند؛ تفاوت این دو عدد یادآوری میکند که همیشه به اندازهگیری مستقل نگاه کنید. فهرست مدلهای عمومی Cerebras هم کوتاه است (در زمان نگارش، gpt-oss-120b و Qwen 3.8 27B).
Together AI، Fireworks، DeepInfra و Baseten؛ کاتالوگ بزرگ
این گروه روی GPU کار میکنند و مزیت اصلیشان تنوع مدل، امکان فاینتیون و سرور اختصاصی است. Together AI برای نمونه DeepSeek V4.1 Flash را با ۰٫۳ دلار ورودی و ۱٫۲ دلار خروجی و gpt-oss-120b را با ۰٫۱۵ و ۰٫۶ دلار ارائه میکند. DeepInfra معمولاً جزو ارزانترینهاست اما در اندازهگیریها سرعت پایینتری دارد؛ Baseten هم برای برخی مدلها نسخهٔ «FAST» گرانتر و بسیار سریعتر دارد.
مقایسهٔ سرعت و هزینهٔ هر تسک
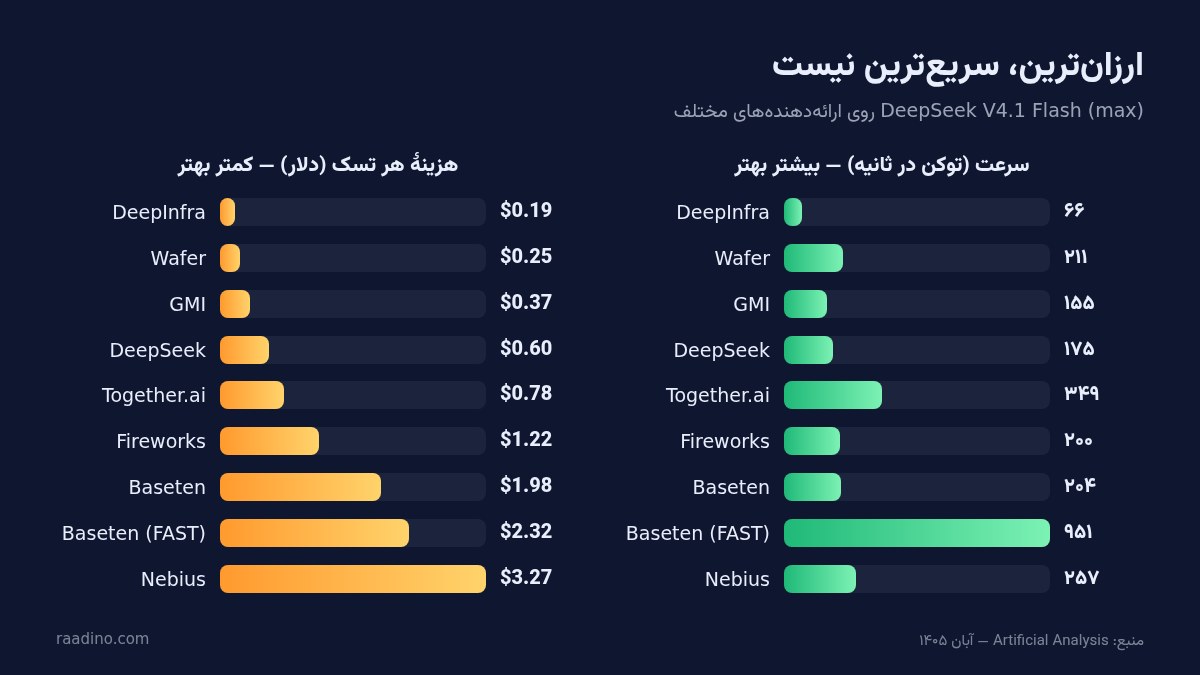
قیمت هر توکن همهٔ ماجرا نیست. Artificial Analysis برای هر ارائهدهنده «هزینهٔ هر تسک» را هم میسنجد؛ یعنی اجرای کامل مجموعهآزمون شاخص هوش با همان ارائهدهنده چقدر خرج دارد. جدول زیر این عدد را برای DeepSeek V4.1 Flash (سطح max) نشان میدهد؛ همه یک مدلاند و امتیاز هوش همه ۳۲ است. دربارهٔ روش این سنجش در راهنمای Artificial Analysis نوشتهایم.
ارائهدهنده
هزینهٔ هر تسک (دلار)
سرعت خروجی (توکن/ثانیه)
اولین توکن (ثانیه)
DeepInfra
۰٫۱۹
۶۶
۰٫۷۷
Wafer
۰٫۲۵
۲۱۱
۰٫۷۳
GMI
۰٫۳۷
۱۵۵
۲٫۱۳
DeepSeek (سازنده)
۰٫۶۰
۱۷۵
۱٫۱۰
Together AI
۰٫۷۸
۳۴۹
۰٫۳۰
Fireworks
۱٫۲۲
۲۰۰
۱٫۳۴
Baseten
۱٫۹۸
۲۰۴
۰٫۳۰
Baseten (FAST)
۲٫۳۲
۹۵۱
۰٫۱۹
Nebius
۳٫۲۷
۲۵۷
۱٫۳۱
هزینهٔ هر تسک در برابر سرعت برای DeepSeek V4.1 Flash؛ ارزانترین لزوماً سریعترین نیست. منبع تصویر: تحریریه رادینو بر اساس Artificial Analysis
نکتهٔ جالب: هزینهٔ هر تسک بین ارزانترین و گرانترین ارائهدهنده بیش از ۱۷ برابر فرق دارد، در حالی که کیفیت مدل یکی است. اگر برای کارهای پرحجم دنبال گزینهٔ اقتصادی هستید، ارزانترین مدلهای هوش مصنوعی را هم ببینید.
چطور ارائهدهندهٔ مناسب را انتخاب کنیم؟
نیاز شما
پیشنهاد
چتبات و دستیار صوتی با پاسخ فوری
Cerebras، Groq یا نسخههای FAST؛ تأخیر اولین توکن را بسنجید
پردازش انبوه و شبانه (Batch)
ارزانترین هزینهٔ هر تسک؛ سرعت اهمیت کمتری دارد
آزمایش چند مدل و تعویض سریع
OpenRouter با یک کلید و API واحد
فاینتیون یا مدل اختصاصی
Together AI، Fireworks یا Baseten
حساسیت روی حریم داده
ارائهدهندههای Zero Data Retention یا data_collection: deny در OpenRouter
با دادهٔ خودتان تست کنید: ۲۰ تا ۵۰ درخواست واقعی را روی دو سه ارائهدهنده بفرستید و کیفیت، سرعت و هزینه را مقایسه کنید.
کوانتیزهسازی را چک کنید: اگر کیفیت پاسخها عجیب پایین است، شاید نسخهٔ FP4 یا int4 به شما رسیده باشد.
پشتیبانی از قابلیتها: اگر از tool calling یا خروجی JSON استفاده میکنید، در OpenRouter گزینهٔ require_parameters را فعال کنید تا فقط ارائهدهندههایی انتخاب شوند که این قابلیتها را دارند.
Fallback داشته باشید: هیچ ارائهدهندهای همیشه در دسترس نیست؛ حداقل یک گزینهٔ پشتیبان تعریف کنید.
⚠️ برای کاربران ایران: بیشتر این سرویسها پرداخت با کارت بینالمللی یا رمزارز میخواهند و ممکن است به دلیل تحریم، حساب کاربران ایرانی را محدود کنند. پیش از ثبتنام قوانین هر سرویس را بخوانید؛ جزئیات بیشتر در بخش پرداخت از ایران در راهنمای قیمت API آمده است.
سؤالات متداول
OpenRouter گرانتر از خرید مستقیم است؟
روی قیمت هر توکن نه؛ OpenRouter قیمت فهرست ارائهدهنده را حساب میکند. فقط هنگام خرید اعتبار ۵٫۵ درصد کارمزد (در پلن Standard) میگیرد. اگر کلید خود ارائهدهنده را وصل کنید (BYOK)، تا ۲۵ هزار دلار مصرف ماهانه کارمزدی ندارد و بالاتر از آن ۵ درصد میگیرد.
سریعترین ارائهدهندهٔ API کدام است؟
در اندازهگیریهای Artificial Analysis برای مدلهایی که پشتیبانی میکند، Cerebras معمولاً صدرنشین است؛ مثلاً حدود ۱٬۶۷۳ توکن در ثانیه برای gpt-oss-120b. Groq و SambaNova هم سریعاند. اما سرعت به مدل و ساعت بستگی دارد.
چرا جواب یک مدل در دو ارائهدهنده فرق دارد؟
به خاطر کوانتیزهسازی، تنظیمات متفاوت (مثل سقف کانتکست و قالب چت) یا نسخههای متفاوت مدل. اگر ثبات کیفیت مهم است، ارائهدهنده را ثابت کنید و دقت مدل را مشخص کنید.
برای شروع کدام ارائهدهنده را انتخاب کنم؟
برای آزمایش، OpenRouter سادهترین شروع است چون با یک کلید چندین مدل و ارائهدهنده را امتحان میکنید. وقتی الگوی مصرفتان مشخص شد، میتوانید مستقیم سراغ ارزانترین یا سریعترین ارائهدهنده بروید.
ارائهدهندهها دادههای من را ذخیره میکنند؟
سیاستها فرق میکند. در OpenRouter میتوانید با data_collection: "deny" یا گزینهٔ ZDR فقط سراغ ارائهدهندههایی بروید که داده را نگه نمیدارند. برای دادهٔ حساس، سیاست حریم خصوصی هر ارائهدهنده را جداگانه بخوانید.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.