اجرای مدل زبانی روی کامپیوتر خودتان مزیتهای بزرگی دارد: اطلاعاتتان از دستگاه بیرون نمیرود، به اینترنت و تحریم وابسته نیستید و هزینهٔ ماهانهٔ API ندارید. اما اولین سؤالی که پیش میآید این است: «آیا کامپیوتر من میکشد؟» و اگر نه، «چه بخرم؟»
جواب کوتاهش این است که در اجرای مدل زبانی، حافظه از هر چیز دیگری مهمتر است؛ حافظهٔ کارت گرافیک (VRAM) یا در مکها حافظهٔ یکپارچه. در این راهنما با عددهای واقعی میبینیم هر مدل چقدر حافظه میخواهد، کوانتیزهسازی چطور این عدد را پایین میآورد و کدام کارت گرافیک، مک یا سیستم برای چه مدلهایی مناسب است. اگر هنوز نمیدانید کدام مدل باز را اجرا کنید، اول فهرست بهترین مدلهای متنباز هوش مصنوعی را ببینید.
آخرین بهروزرسانی: ۷ آبان ۱۴۰۵ — مشخصات حافظهٔ کارتها و سیستمها از سایتهای رسمی NVIDIA و Apple و Artificial Analysis، و حجم مدلها از مستندات llama.cpp در همین تاریخ برداشته شدهاند. قیمتها دلاری و مربوط به بازار جهانیاند.
⚡ پاسخ کوتاه
برای مدلهای کوچک ۴ تا ۸ میلیارد پارامتری، یک کارت گرافیک با ۸ گیگابایت VRAM یا مک با ۱۶ گیگابایت حافظه کافی است. برای مدلهای حدود ۲۷ تا ۳۵ میلیارد پارامتری، کارت ۲۴ تا ۳۲ گیگابایتی مثل RTX 5090 یا مک با ۳۲ تا ۶۴ گیگابایت حافظه لازم است. مدلهای ۷۰ میلیارد پارامتری به بالا به حدود ۴۳ گیگابایت حافظه یا بیشتر نیاز دارند و سیستمهای ۱۲۸ گیگابایتی مثل DGX Spark یا مکبوک M5 Max برایشان ساخته شدهاند. RTX 5090 با پهنای باند ۱۷۹۲ گیگابایت بر ثانیه، هر مدلی را که در حافظهاش جا شود، از همه سریعتر اجرا میکند.
مدل زبانی در اصل مجموعهٔ عظیمی از عددهاست (پارامترها). برای تولید هر کلمه، تقریباً همهٔ این عددها باید از حافظه خوانده شوند. دو نتیجهٔ مهم دارد:
ظرفیت حافظه تعیین میکند اصلاً کدام مدل اجرا شود. اگر مدل در VRAM جا نشود، بخشی از آن به رم سیستم منتقل میشود و سرعت بهشدت افت میکند.
پهنای باند حافظه (سرعت خواندن از حافظه) تعیین میکند هر کلمه با چه سرعتی تولید شود. به همین دلیل کارت گرافیک با حافظهٔ کمتر ولی سریعتر، گاهی از سیستمی با حافظهٔ زیاد ولی کند جلو میزند.
پردازنده (CPU) و حتی رم سیستم در درجهٔ دوم اهمیتاند؛ هرچند LM Studio برای اجرای راحت حداقل ۱۶ گیگابایت رم و دستکم ۴ گیگابایت VRAM اختصاصی را پیشنهاد میکند و پردازندههای x86 باید از دستورالعمل AVX2 پشتیبانی کنند. دربارهٔ اینکه سرعت تولید توکن چه معنایی دارد، مقالهٔ سرعت مدلهای هوش مصنوعی را ببینید.
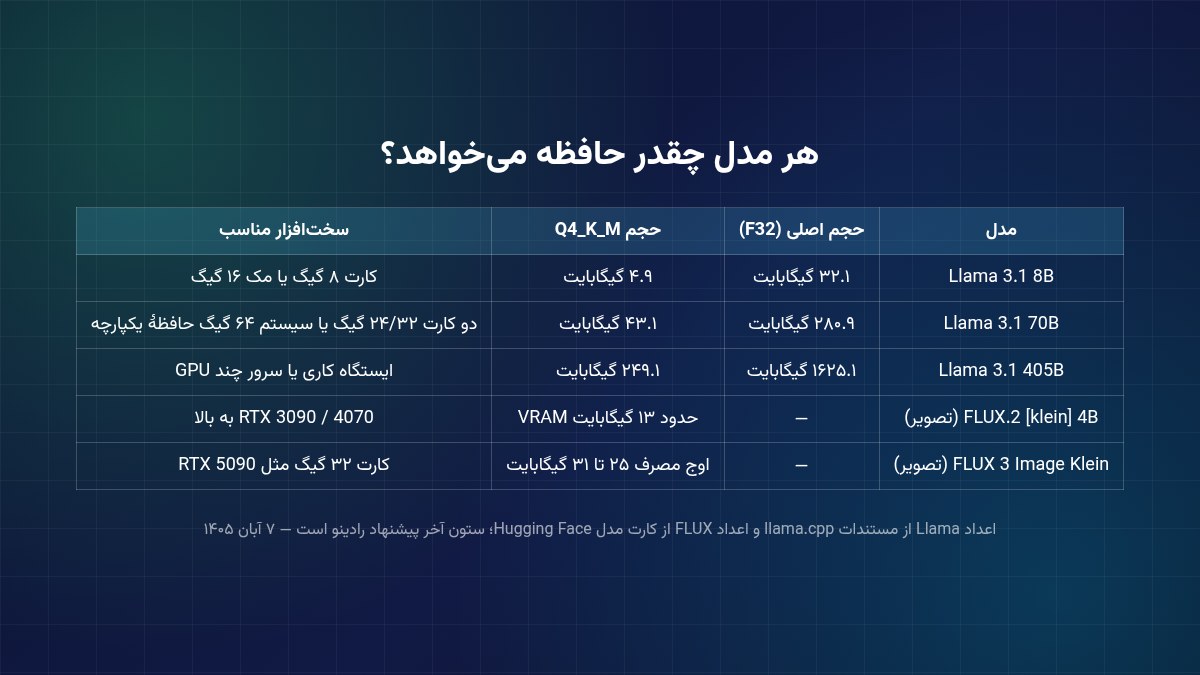
هر مدل چقدر حافظه میخواهد؟
قاعدهٔ تقریبی این است که هر میلیارد پارامتر در دقت کامل (۱۶ بیتی) حدود ۲ گیگابایت حافظه میخواهد. اما تقریباً هیچکس مدلها را در خانه با دقت کامل اجرا نمیکند؛ از نسخههای کوانتیزه استفاده میشود.
حجم مدلهای Llama در حالت اصلی و کوانتیزهٔ Q4_K_M و حافظهٔ لازم مدلهای FLUX؛ ستون آخر پیشنهاد رادینوست. منبع تصویر: تحریریه رادینو
مدل
حجم اصلی
حجم در Q4_K_M
سختافزار پیشنهادی
Llama 3.1 8B
۳۲.۱ گیگابایت
۴.۹ گیگابایت
کارت ۸ گیگابایتی یا مک ۱۶ گیگابایتی
Llama 3.1 70B
۲۸۰.۹ گیگابایت
۴۳.۱ گیگابایت
دو کارت ۲۴ یا ۳۲ گیگابایتی، یا سیستم ۶۴ گیگابایتی با حافظهٔ یکپارچه
Llama 3.1 405B
۱۶۲۵.۱ گیگابایت
۲۴۹.۱ گیگابایت
ایستگاه کاری یا سرور چند GPU
این اعداد از مستندات ابزار llama-quantize در پروژهٔ llama.cpp آمدهاند (حجم «اصلی» در این جدول با دقت ۳۲ بیتی است). توجه کنید که علاوه بر حجم خود مدل، چند گیگابایت هم برای پنجرهٔ متنی (KV cache) و سیستم لازم است؛ پس همیشه کمی جای خالی بگذارید. اگر با خانوادهٔ Llama آشنا نیستید، مقالهٔ همه چیز دربارهٔ Llama را بخوانید.
کوانتیزهسازی؛ کوچک کردن مدل بدون افت جدی کیفیت
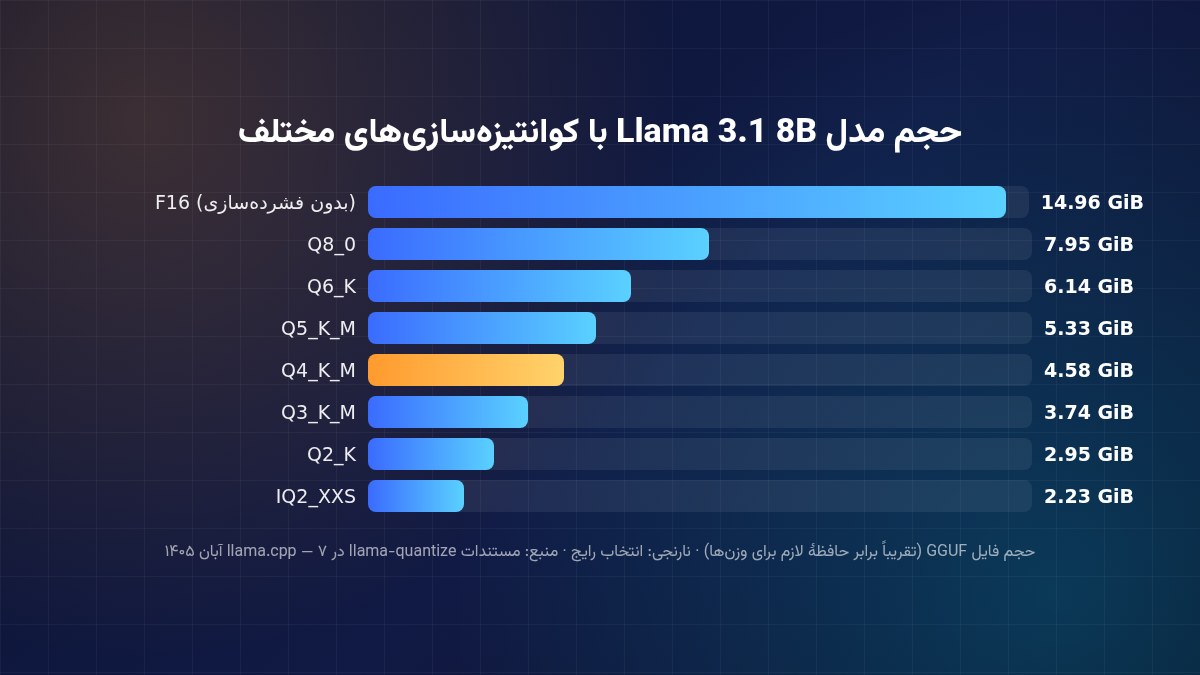
حجم فایل GGUF مدل Llama 3.1 8B در سطوح مختلف کوانتیزهسازی طبق مستندات llama.cpp. منبع تصویر: تحریریه رادینو
کوانتیزهسازی یعنی ذخیرهٔ پارامترها با دقت کمتر؛ مثلاً ۴ بیت بهجای ۱۶ بیت. طبق جدول llama.cpp، مدل Llama 3.1 8B در حالت F16 حدود ۱۴.۹۶ گیبیبایت است، در Q8_0 حدود ۷.۹۵، در Q4_K_M حدود ۴.۵۸ و در IQ2_XXS فقط ۲.۲۳ گیبیبایت. سرعت هم بالا میرود: در همان آزمایش، تولید متن با Q4_K_M حدود ۷۱.۹ توکن بر ثانیه بود، در حالی که F16 حدود ۲۹.۲ توکن بر ثانیه سرعت داشت.
💡 پیشنهاد عملی: برای بیشتر کاربران، Q4_K_M نقطهٔ تعادل خوبی بین حجم و کیفیت است. کوانتیزهسازیهای ۲ و ۳ بیتی فقط وقتی ارزش دارند که چارهای جز جا دادن یک مدل بزرگ در حافظهٔ کم نداشته باشید؛ افت کیفیت در آنها محسوستر است. فایلهای GGUF که در Hugging Face میبینید معمولاً همین سطوح را در نامشان دارند.
کدام کارت گرافیک یا سیستم بخرم؟
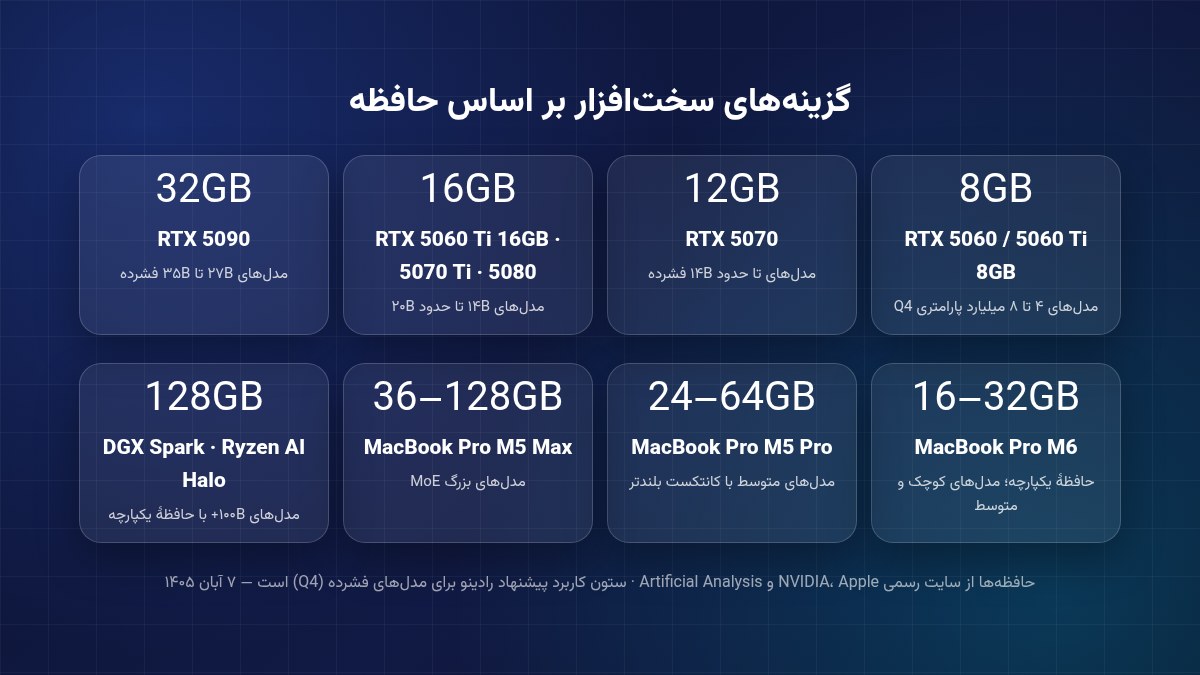
گزینههای رایج سختافزار بر اساس مقدار حافظه؛ مدلهای پیشنهادی برای نسخهٔ Q4 هستند. منبع تصویر: تحریریه رادینو
اگر کارت قدیمیتری دارید، نگران نباشید: طبق مستندات Ollama، کارتهای NVIDIA با compute capability ۵.۰ به بالا و درایور ۵۵۰ به بعد پشتیبانی میشوند و Ollama روی کارتهای دیگر از طریق Vulkan هم کار میکند. در خرید کارت دستدوم، حافظهٔ بیشتر را به نسل جدیدتر ترجیح دهید.
مک با حافظهٔ یکپارچه
در مکهای اپل سیلیکون، پردازنده و گرافیک از یک حافظهٔ مشترک استفاده میکنند؛ پس مکبوکی با ۶۴ یا ۱۲۸ گیگابایت حافظه میتواند مدلهایی را اجرا کند که در هیچ کارت گرافیک خانگی جا نمیشوند. طبق صفحهٔ مشخصات اپل، مکبوک پرو با تراشهٔ M6 با ۱۶، ۲۴ یا ۳۲ گیگابایت حافظه، M5 Pro با ۲۴، ۴۸ یا ۶۴ گیگابایت و M5 Max با ۳۶ تا ۱۲۸ گیگابایت عرضه میشود و پهنای باند حافظهٔ M5 Max (نسخهٔ ۴۰ هستهای گرافیک) به ۶۱۴ گیگابایت بر ثانیه میرسد. Ollama روی مک از Metal استفاده میکند و LM Studio هم روی اپل سیلیکون با macOS 14 به بعد اجرا میشود.
سیستمهای ۱۲۸ گیگابایتی مخصوص هوش مصنوعی
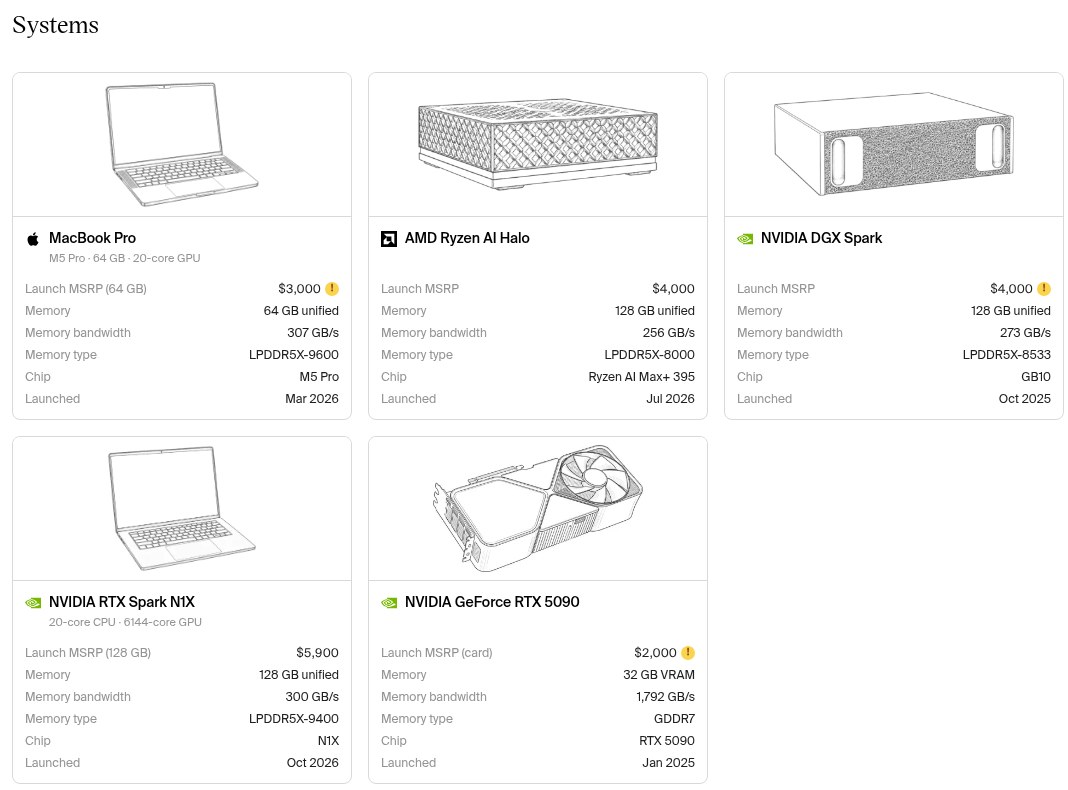
مشخصات سیستمهایی که Artificial Analysis برای اجرای محلی مدلها آزمایش کرده است. منبع تصویر: Artificial Analysis
Artificial Analysis چند سیستم محبوب اجرای محلی را کنار هم آزمایش کرده است:
سیستم
قیمت (دلار)
حافظه
پهنای باند
عرضه
MacBook Pro M5 Pro
۳٬۰۰۰
۶۴ گیگابایت
۳۰۷ گیگابایت بر ثانیه
مارس ۲۰۲۶
AMD Ryzen AI Halo
۴٬۰۰۰
۱۲۸ گیگابایت
۲۵۶ گیگابایت بر ثانیه
ژوئیهٔ ۲۰۲۶
NVIDIA DGX Spark
۴٬۰۰۰
۱۲۸ گیگابایت
۲۷۳ گیگابایت بر ثانیه
اکتبر ۲۰۲۵
لپتاپ NVIDIA RTX Spark (N1X)
۵٬۹۰۰
۱۲۸ گیگابایت
۳۰۰ گیگابایت بر ثانیه
اکتبر ۲۰۲۶
GeForce RTX 5090 (فقط کارت)
۲٬۰۰۰
۳۲ گیگابایت
۱٬۷۹۲ گیگابایت بر ثانیه
ژانویهٔ ۲۰۲۵
در عمل چقدر سریعاند؟ آزمون AgentPerf-Local
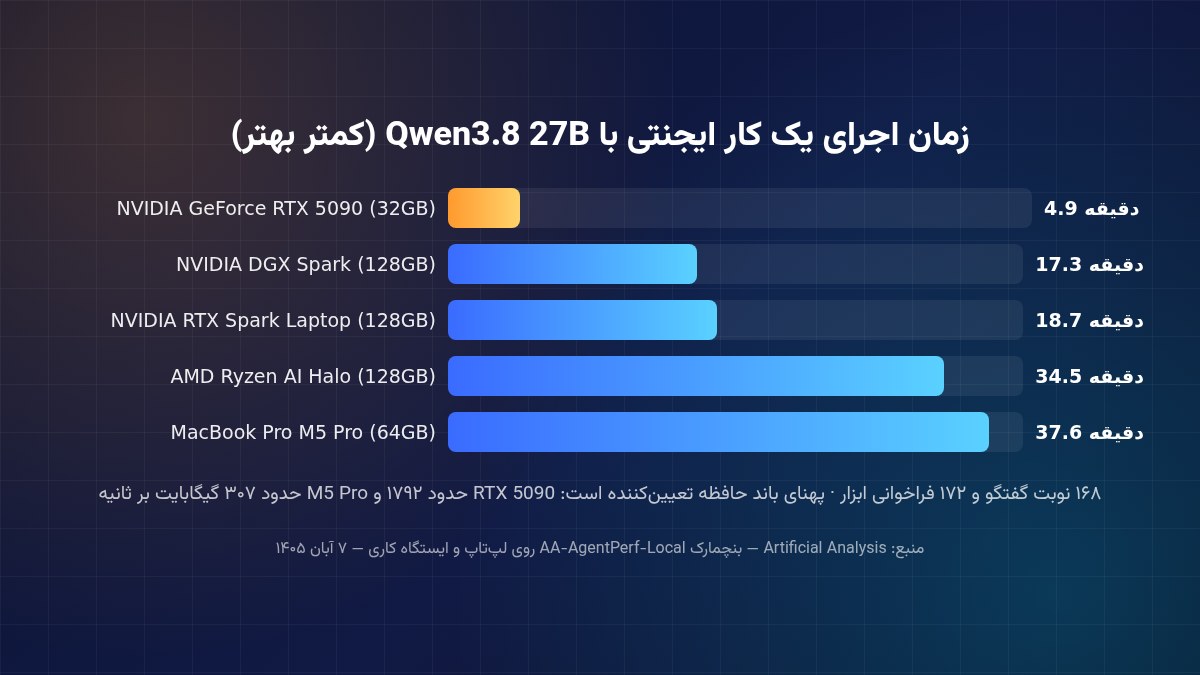
زمان کامل کردن یک کار ایجنتی ۱۶۸ نوبتی با مدل Qwen3.8 27B؛ عدد کمتر بهتر است. منبع تصویر: تحریریه رادینو
آزمون AgentPerf-Local در Artificial Analysis یک کار ایجنتی واقعی با ۱۶۸ نوبت گفتوگو و ۱۷۲ فراخوانی ابزار را روی هر سیستم اجرا میکند و زمان کل را میسنجد. نتیجهها خیلی آموزندهاند:
مدل
MacBook Pro M5 Pro
Ryzen AI Halo
DGX Spark
RTX Spark لپتاپ
RTX 5090
Qwen3.8 27B
۳۷.۶ دقیقه
۳۴.۵ دقیقه
۱۷.۳ دقیقه
۱۸.۷ دقیقه
۴.۹ دقیقه
Qwen3.6 35B A3B
۱۱.۹ دقیقه
۱۱.۷ دقیقه
۷.۳ دقیقه
۷.۶ دقیقه
۲ دقیقه
Ling 3.0 Flash (۱۲۴ میلیارد)
جا نمیشود
۲۵.۱ دقیقه
۱۴.۹ دقیقه
۱۵.۳ دقیقه
جا نمیشود
وقتی مدل در کارت جا شود، RTX 5090 بیرقیب است: کار Qwen3.8 27B را در ۴.۹ دقیقه تمام کرده، یعنی بیش از ۷ برابر سریعتر از مکبوک M5 Pro.
مدلهای MoE (مثل Qwen3.6 35B A3B) خیلی سبکترند: چون در هر قدم فقط بخش کوچکی از پارامترها فعال میشود، حتی روی مک هم در حدود ۱۲ دقیقه تمام شدهاند.
برای مدلهای خیلی بزرگ، حافظهٔ زیاد تنها راه است: Ling 3.0 Flash با ۱۲۴ میلیارد پارامتر نه در ۳۲ گیگابایت RTX 5090 جا شد و نه در ۶۴ گیگابایت مکبوک M5 Pro؛ اما سیستمهای ۱۲۸ گیگابایتی آن را اجرا کردند.
خیلی از مدلهای وزن باز محبوب این جدول، مثل Qwen و Ling، چینیاند؛ برای آشنایی با آنها مقالهٔ مدلهای هوش مصنوعی چینی را بخوانید.
جمعبندی: راهنمای سریع خرید
بودجهٔ کم، شروع یادگیری: کارت ۸ گیگابایتی (مثل RTX 5060) یا مک ۱۶ گیگابایتی؛ مدلهای ۴ تا ۸ میلیاردی.
کاربر جدی، مدلهای متوسط: کارت ۱۶ گیگابایتی (RTX 5060 Ti 16GB، 5070 Ti یا 5080)؛ مدلها تا حدود ۱۴ میلیارد.
بیشترین سرعت در خانه: RTX 5090 با ۳۲ گیگابایت؛ مدلهای ۲۷ تا ۳۵ میلیاردی با سرعت بالا.
مدلهای بزرگ و کار بیصدا و کممصرف: مکبوک M5 Pro یا M5 Max با ۶۴ تا ۱۲۸ گیگابایت.
مدلهای ۱۰۰ میلیارد پارامتری به بالا: سیستمهای ۱۲۸ گیگابایتی مثل DGX Spark یا Ryzen AI Halo.
برای مدلهای ۷ تا ۸ میلیاردی در حالت Q4 حدود ۵ گیگابایت برای خود مدل کافی است؛ پس کارت ۸ گیگابایتی جواب میدهد. مدلهای حدود ۳۰ میلیاردی به ۲۴ تا ۳۲ گیگابایت و مدلهای ۷۰ میلیاردی به حدود ۴۳ گیگابایت یا بیشتر نیاز دارند.
آیا بدون کارت گرافیک هم میشود مدل زبانی اجرا کرد؟
بله، ابزارهایی مثل Ollama و LM Studio روی CPU هم کار میکنند، اما خیلی کندتر. LM Studio دستکم ۱۶ گیگابایت رم و پردازندهٔ دارای AVX2 را پیشنهاد میکند. مکهای اپل سیلیکون بهخاطر حافظهٔ یکپارچه گزینهٔ بسیار بهتری هستند.
مک بهتر است یا کارت گرافیک NVIDIA؟
اگر مدل در حافظهٔ کارت جا شود، NVIDIA سریعتر است؛ در آزمون Artificial Analysis، RTX 5090 بیش از ۷ برابر سریعتر از مکبوک M5 Pro بود. اما مکها با حافظهٔ ۶۴ تا ۱۲۸ گیگابایتی میتوانند مدلهای بسیار بزرگتری را اجرا کنند.
کوانتیزهسازی Q4 کیفیت مدل را خراب میکند؟
افت کیفیت Q4_K_M برای بیشتر کاربردها کم است و در عوض حجم مدل را حدود یکسوم نسخهٔ F16 میکند. کوانتیزهسازیهای ۲ و ۳ بیتی افت کیفیت بیشتری دارند.
آیا رم سیستم هم مهم است؟
بله، اما کمتر از VRAM. اگر مدل در کارت جا نشود، بخشی از آن روی رم میرود و سرعت بهشدت کم میشود. ۱۶ گیگابایت رم حداقل راحت و ۳۲ گیگابایت برای کار جدیتر مناسب است.




نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.