تا همین چند وقت پیش، استفاده از هوش مصنوعی روی گوشی یعنی ارسال پیام به یک سرور دوردست و منتظر ماندن برای جواب. اما حالا مدلهای زبانی آنقدر سبک و بهینه شدهاند که مستقیم روی خود گوشی اجرا میشوند؛ بدون اینترنت، بدون اشتراک و بدون اینکه دادههایتان از گوشی خارج شود.
در این مقاله میبینیم هوش مصنوعی روی دستگاه (On-Device AI) چیست، چه مدلهایی امروز روی گوشی اجرا میشوند، با چه اپهایی میتوانید همین الان امتحانشان کنید و آیفون و گلکسی در اجرای این مدلها چقدر سریعاند. اگر دنبال مدلهای بزرگتر برای کامپیوتر هستید، مقالهٔ بهترین مدلهای متنباز هوش مصنوعی را ببینید.
آخرین بهروزرسانی: ۶ آبان ۱۴۰۵ — اعداد سرعت و مشخصات از مستندات رسمی Google AI Edge و Apple در همین تاریخ برداشته شدهاند.
⚡ پاسخ کوتاه
بله، امروز میتوانید یک مدل زبانی واقعی را بدون اینترنت روی گوشی اجرا کنید. سادهترین راه، نصب اپ رایگان Google AI Edge Gallery (اندروید ۱۲ به بالا و iOS 17 به بالا) و دانلود مدل Gemma 4 E2B است که حدود ۲.۵۸ گیگابایت حجم دارد. طبق مستندات گوگل، این مدل روی GPU آیفون ۱۷ پرو حدود ۵۶ و روی گلکسی S26 اولترا حدود ۵۲ توکن در ثانیه تولید میکند. اپل و گوگل هم مدلهای داخلی (AFM 3 Core و Gemini Nano) را مستقیم در سیستمعامل گذاشتهاند.
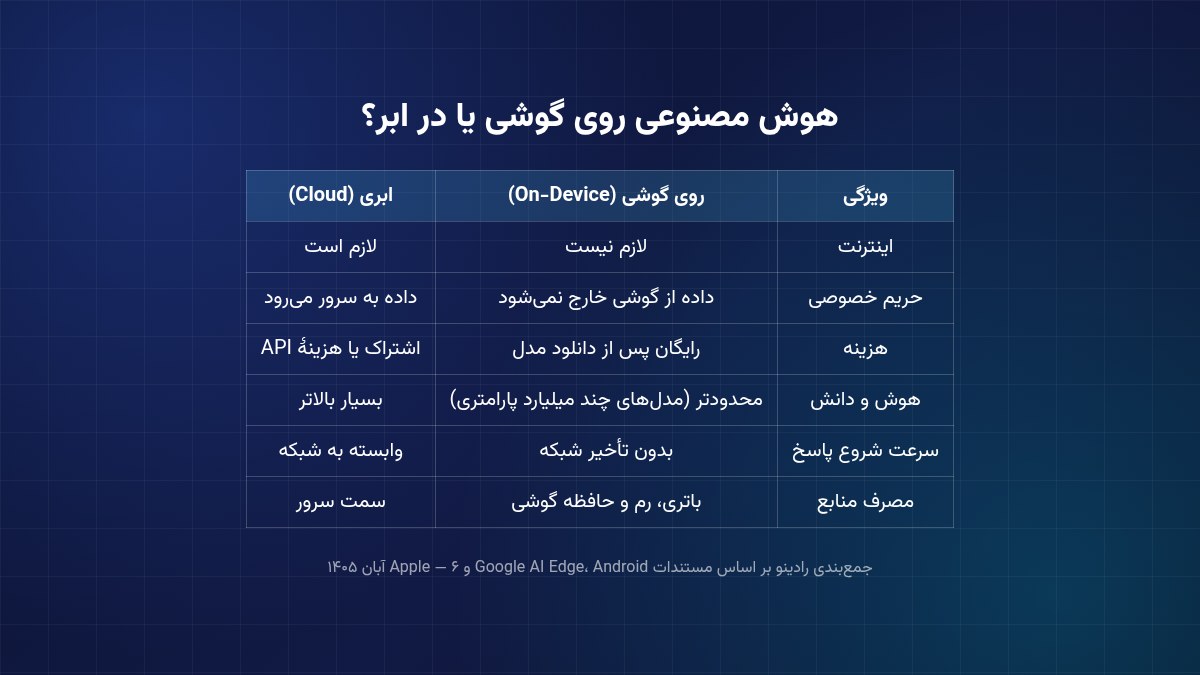
هوش مصنوعی روی دستگاه یعنی مدل روی پردازندههای خود گوشی (CPU، GPU یا NPU) اجرا میشود، نه روی سرور. برای این کار مدلها باید بسیار کوچکتر از مدلهای ابری باشند؛ بهجای صدها میلیارد پارامتر، چند میلیارد پارامتر. سازندگان با فشردهسازی (کوانتیزه کردن) وزنها و موتورهای اجرای مخصوص موبایل، این مدلها را در حد چند گیگابایت نگه میدارند.
مقایسهٔ اجرای هوش مصنوعی روی گوشی و روی سرورهای ابری. منبع تصویر: تحریریه رادینو
مزایا و محدودیتها
حریم خصوصی: متن، عکس و صدای شما از گوشی خارج نمیشود.
کار بدون اینترنت: در هواپیما، سفر یا جایی که اینترنت ضعیف یا محدود است.
رایگان: بعد از دانلود مدل، هزینهٔ اشتراک یا API ندارد.
بدون تأخیر شبکه: شروع پاسخ به سرعت اینترنت وابسته نیست.
محدودیت دانش و هوش: مدلهای کوچک در استدلال پیچیده و اطلاعات عمومی از مدلهای ابری ضعیفترند و بیشتر دچار اشتباه میشوند.
مصرف منابع: مدل چند گیگابایت حافظه میگیرد و اجرای آن رم و باتری مصرف میکند.
اگر فقط به هزینه فکر میکنید، گزینهٔ دیگر استفاده از ارزانترین مدلهای هوش مصنوعی ابری است؛ اما هیچکدام حریم خصوصی و کار آفلاین مدل روی گوشی را ندارند.
مدلهای مهم هوش مصنوعی روی گوشی
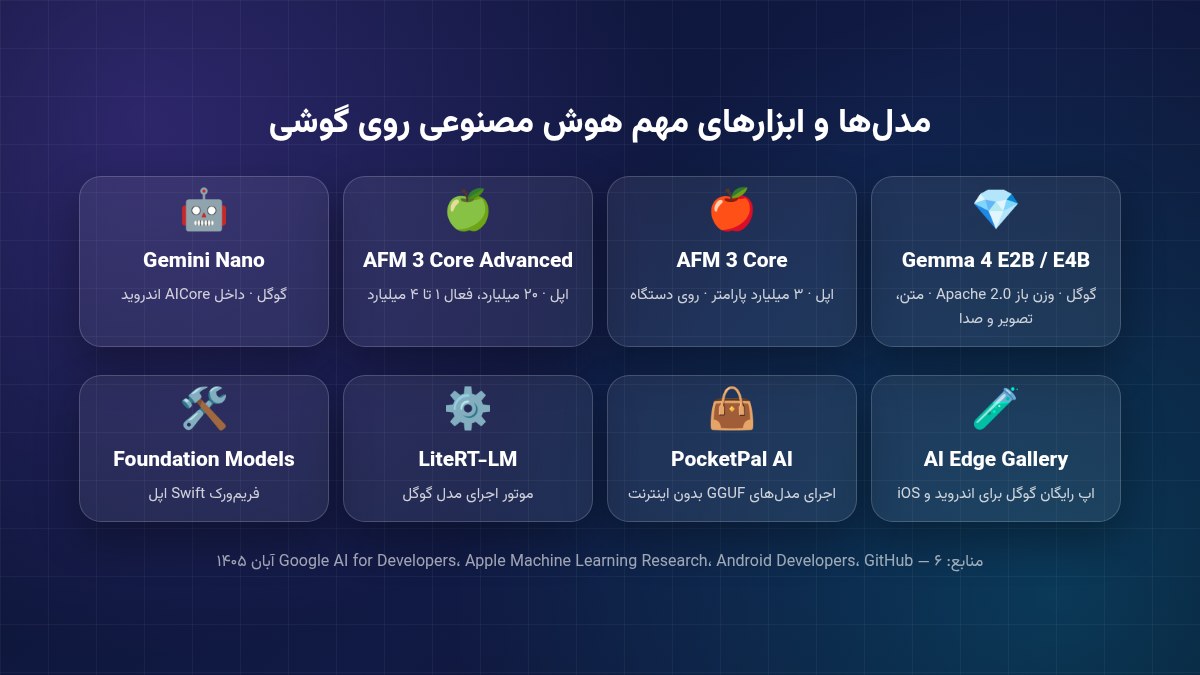
مدلها، اپها و ابزارهای اصلی اجرای هوش مصنوعی روی گوشی در آبان ۱۴۰۵. منبع تصویر: تحریریه رادینو
Gemma 4 گوگل؛ وزن باز و چندوجهی
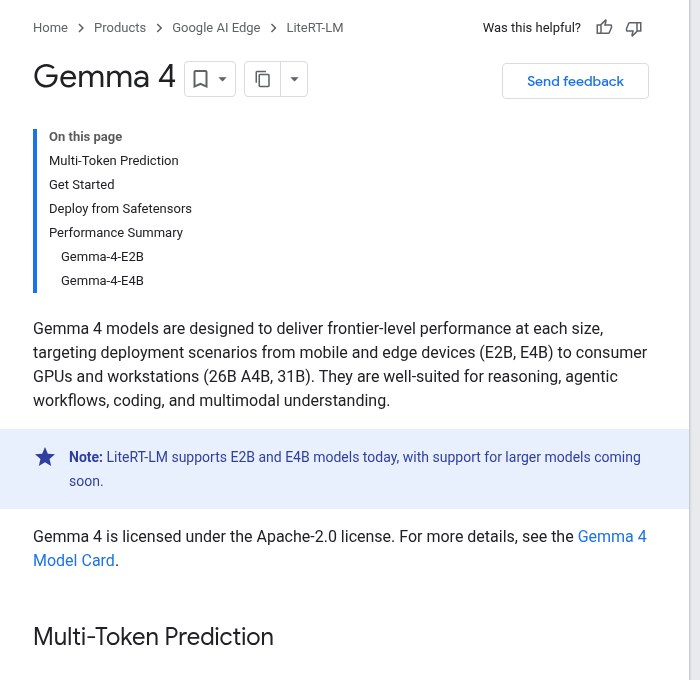
خانوادهٔ Gemma 4 گوگل در اندازههای E2B، E4B، 12B، 31B و 26B A4B عرضه شده است. حرف E یعنی «پارامتر مؤثر» (effective) و دو نسخهٔ E2B و E4B مخصوص موبایل و دستگاههای لبه طراحی شدهاند. طبق مستندات گوگل، این دو مدل پنجرهٔ زمینهٔ ۱۲۸ هزار توکنی دارند، علاوه بر متن و تصویر ورودی صوتی را هم بهصورت بومی میفهمند و با مجوز Apache 2.0 منتشر شدهاند؛ یعنی استفادهٔ تجاری هم آزاد است.
صفحهٔ Gemma 4 در مستندات Google AI Edge برای اجرای مدل روی دستگاه. منبع تصویر: Google AI Edge
موتور اجرای گوگل برای این مدلها LiteRT-LM است. طبق صفحهٔ رسمی، نسخهٔ E2B حدود ۲.۵۸ گیگابایت و نسخهٔ E4B حدود ۳.۶۵ گیگابایت حجم دارد و قابلیت Multi-Token Prediction سرعت تولید را روی GPU موبایل تا ۲.۲ برابر و روی CPU تا ۱.۵ برابر بالا میبرد.
اپل: AFM 3 و فریمورک Foundation Models
معرفی خانوادهٔ مدلهای پایهٔ اپل (AFM 3) در سایت Apple Machine Learning Research. منبع تصویر: Apple Machine Learning Research
اپل در ژوئن ۲۰۲۶ نسل سوم مدلهای پایهٔ خود (AFM 3) را معرفی کرد؛ خانوادهای پنجتایی که به گفتهٔ اپل با همکاری گوگل ساخته شده است. دو مدل روی خود دستگاه اجرا میشوند: AFM 3 Core با ۳ میلیارد پارامتر و AFM 3 Core Advanced؛ مدلی پراکنده (sparse) با ۲۰ میلیارد پارامتر که در هر لحظه فقط ۱ تا ۴ میلیارد پارامتر آن فعال است و بهصورت بومی چندوجهی است. بقیهٔ مدلها روی سرورهای Private Cloud Compute اپل اجرا میشوند.
برنامهنویسها از طریق فریمورک Foundation Models با چند خط کد Swift به مدل روی دستگاه دسترسی دارند. طبق صفحهٔ این فریمورک، در iOS 27 مدل روی دستگاه ورودی تصویر هم میپذیرد.
Gemini Nano در اندروید
Gemini Nano مدل روی دستگاه گوگل است که داخل سرویس سیستمی AICore اندروید اجرا میشود و برنامهنویسها از طریق APIهای ML Kit GenAI از آن استفاده میکنند. برای آشنایی با قابلیتهای هوش مصنوعی سامسونگ، مقالهٔ هوش مصنوعی گلکسی را بخوانید. اگر اپ اندرویدی میسازید، مقالهٔ بهترین هوش مصنوعی برای توسعهٔ اپ اندروید هم به کارتان میآید.
سرعت اجرای هوش مصنوعی روی آیفون و گلکسی
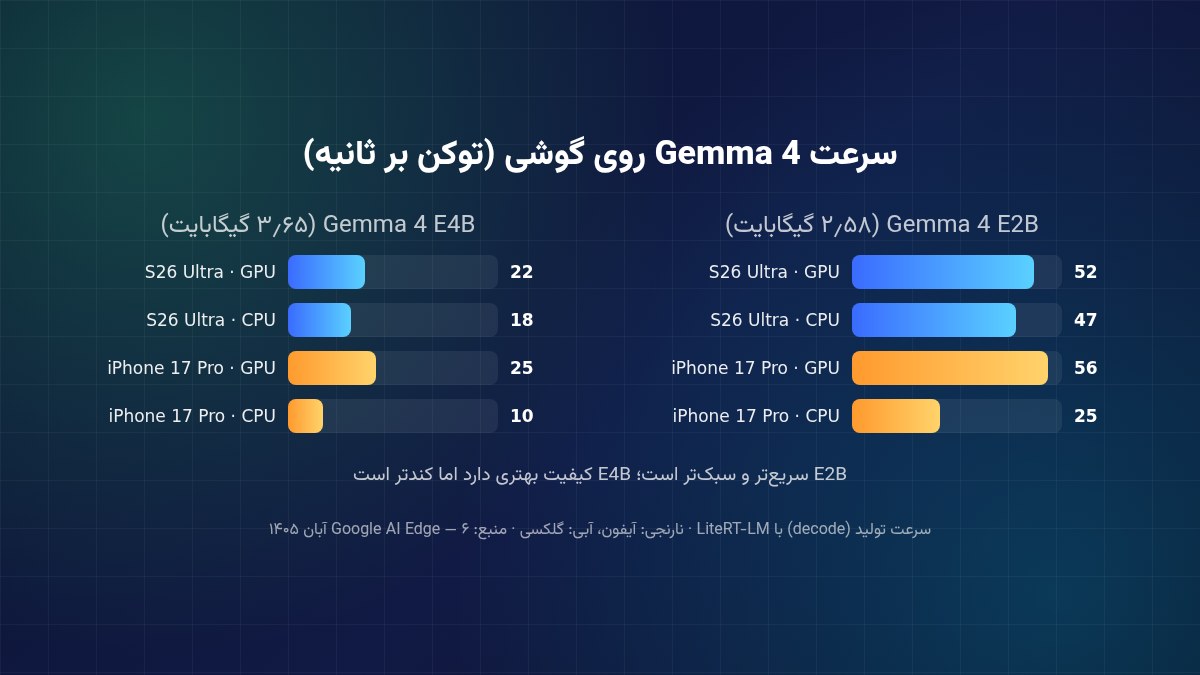
سرعت تولید متن Gemma 4 روی گوشی (توکن بر ثانیه) طبق مستندات LiteRT-LM. منبع تصویر: تحریریه رادینو
گوگل در صفحهٔ Gemma 4 سرعت این مدل را روی دو گوشی پرچمدار منتشر کرده است:
مدل و گوشی
CPU (توکن/ثانیه)
GPU (توکن/ثانیه)
Gemma 4 E2B · گلکسی S26 اولترا
۴۷
۵۲
Gemma 4 E2B · آیفون ۱۷ پرو
۲۵
۵۶
Gemma 4 E4B · گلکسی S26 اولترا
۱۸
۲۲
Gemma 4 E4B · آیفون ۱۷ پرو
۱۰
۲۵
چند نکته از این اعداد: روی GPU دو گوشی تقریباً همسطحاند و آیفون کمی جلوتر است، اما روی CPU گلکسی بهطور محسوس سریعتر است. زمان شروع پاسخ (TTFT) مدل E2B روی GPU گلکسی حدود ۰.۳ ثانیه و روی CPU حدود ۱.۸ ثانیه است. مدل E4B کیفیت بهتری دارد اما تقریباً نصف سرعت E2B را دارد. طبق همین صفحه، E2B به حدود ۴ گیگابایت رم یا بیشتر و E4B به ۶ گیگابایت یا بیشتر نیاز دارد.
اپهای اجرای هوش مصنوعی آفلاین روی گوشی
Google AI Edge Gallery: اپ رایگان و متنباز گوگل برای اندروید و iOS. امکان چت با Gemma 4 با حالت فکر کردن (Thinking Mode)، پرسیدن سؤال دربارهٔ عکس، تبدیل صدا به متن، Agent Skills و اجرای دستورهای گوشی با FunctionGemma را دارد.
PocketPal AI: اپ متنباز برای اندروید و iOS که مدلهای فرمت GGUF مثل Gemma، Qwen، Phi و Llama را کاملاً آفلاین اجرا میکند. میتوانید مدل را مستقیم از Hugging Face دانلود کنید.
MLC LLM: پروژهٔ متنباز برای کامپایل و اجرای مدلهای زبانی روی گوشی، مرورگر و کامپیوتر؛ بیشتر برای برنامهنویسها.
قابلیتهای داخلی سیستمعامل: Apple Intelligence در آیفون و Galaxy AI و Gemini Nano در اندروید، بدون نصب چیز اضافه.
خانوادهٔ Llama متا هم از اولین مدلهایی بود که نسخههای کوچک آن روی گوشی اجرا شد؛ دربارهٔ آن در مقالهٔ همهچیز دربارهٔ Llama خواندهاید.
چطور شروع کنیم؟
۱. مطمئن شوید گوشیتان دستکم ۴ تا ۶ گیگابایت رم و چند گیگابایت فضای خالی دارد.
۲. اپ Google AI Edge Gallery یا PocketPal AI را نصب کنید.
۳. با اینترنت، یک بار مدل کوچک (مثلاً Gemma 4 E2B) را دانلود کنید.
۴. اینترنت را قطع کنید و امتحان کنید؛ برای خلاصهسازی، بازنویسی متن، ترجمه و سؤال دربارهٔ عکس مناسب است.
۵. برای کارهای سنگینتر مثل استدلال پیچیده یا اطلاعات بهروز، همچنان سراغ مدلهای ابری بروید.
⚠️ یادتان باشد: مدلهای کوچک اطلاعات بهروز ندارند و بیشتر از مدلهای بزرگ اشتباه میکنند. برای اطلاعات مهم، جواب را بررسی کنید.
آیندهٔ هوش مصنوعی روی گوشی
روند روشن است: سازندگان مدلها نسخههای کوچک و بهینه را جدی گرفتهاند و اپل و گوگل مدل روی دستگاه را به بخشی از سیستمعامل تبدیل کردهاند. ترکیب مدل روی گوشی برای کارهای سریع و خصوصی و مدل ابری برای کارهای سنگین، احتمالاً شکل رایج استفاده از هوش مصنوعی در گوشیها خواهد بود. برای آشنایی بیشتر با تواناییهای هوش مصنوعی و یادگیری استفادهٔ درست از آن، دورهٔ کپسول هوش مصنوعی رادینو را ببینید.
سؤالات متداول
آیا میشود هوش مصنوعی را بدون اینترنت روی گوشی اجرا کرد؟
بله. با اپهایی مثل Google AI Edge Gallery یا PocketPal AI یک بار مدل را دانلود میکنید و بعد بدون اینترنت از آن استفاده میکنید.
بهترین مدل هوش مصنوعی برای اجرا روی گوشی کدام است؟
برای شروع، Gemma 4 E2B گوگل گزینهٔ خوبی است: حدود ۲.۵۸ گیگابایت حجم دارد، متن و تصویر و صدا را میفهمد و با مجوز Apache 2.0 منتشر شده است. اگر گوشی رم بیشتری دارد، E4B کیفیت بهتری دارد.
گوشی من چقدر رم لازم دارد؟
طبق مستندات گوگل، Gemma 4 E2B به حدود ۴ گیگابایت رم یا بیشتر و E4B به ۶ گیگابایت یا بیشتر نیاز دارد.
آیفون سریعتر است یا گلکسی؟
طبق اعداد گوگل برای Gemma 4 E2B، روی GPU آیفون ۱۷ پرو (۵۶ توکن در ثانیه) کمی از گلکسی S26 اولترا (۵۲) جلوتر است، اما روی CPU گلکسی (۴۷) بسیار سریعتر از آیفون (۲۵) است.
آیا هوش مصنوعی روی گوشی امنتر است؟
از نظر حریم خصوصی بله؛ دادههای شما برای پردازش به سرور فرستاده نمیشود. اما مدلهای کوچک دقت کمتری دارند و جوابشان باید بررسی شود.




نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.