یک ویس دوازدهدقیقهای در تلگرام، ضبط جلسهٔ کاری، مصاحبه برای پایاننامه یا یک قسمت پادکست؛ تایپ کردن دستی هر کدام ساعتها وقت میگیرد. خبر خوب اینکه تبدیل گفتار به متن فارسی با هوش مصنوعی حالا آنقدر خوب شده که بیشتر کار را در چند دقیقه انجام میدهد؛ خبر بد اینکه دقت ابزارها در فارسی خیلی با هم فرق دارد.
در این مقاله ابزارهای خارجی و ایرانی تبدیل ویس به متن را معرفی میکنیم، میگوییم دقت را با چه عددی میسنجند و نتیجهٔ بنچمارکهای مخصوص فارسی را کنار هم میگذاریم. اگر دنبال کار برعکس، یعنی ساخت صدا از متن هستید، بهترین هوش مصنوعی تبدیل متن به گفتار را ببینید.
آخرین بهروزرسانی: ۱۴ آبان ۱۴۰۵ — نتیجهها از بنچمارک فارسی PESTE، لیدربورد Open Persian ASR و جدول Speech to Text سایت Artificial Analysis در ۱۴ آبان ۱۴۰۵ خوانده شدهاند.
⚡ پاسخ کوتاه
برای تبدیل ویس فارسی به متن سه راه دارید: ابزارهای ایرانی مثل آوانگار (در اپ ویرا) و نویسا که فارسی محاوره را میشناسند و بدون فیلترشکن کار میکنند؛ سرویسهای جهانی مثل Gemini، ElevenLabs Scribe و GPT Transcribe که فارسی را هم پشتیبانی میکنند؛ و مدلهای متنباز مثل Whisper که روی کامپیوتر خودتان اجرا میشوند. در بنچمارک فارسی PESTE، Whisper large-v3 بدون آموزش اضافه حدود ۲۰ درصد خطای کلمه (WER) دارد، اما نسخههای فارسیسازیشدهاش خطا را به حدود ۱۳ تا ۱۵ درصد میرسانند. برای کار حساس، همیشه متن خروجی را یک بار با صدا مرور کنید.
به این فناوری تشخیص خودکار گفتار (Automatic Speech Recognition یا ASR) میگویند. مدل صدا را به تکههای کوچک تقسیم میکند، الگوهای صوتی را به واج و کلمه تبدیل میکند و با کمک یک مدل زبانی حدس میزند کدام جمله محتملتر است. مدلهای جدید مثل Whisper این دو کار را یکجا و با شبکههای ترنسفورمر انجام میدهند و روی صدها هزار ساعت صدای چندزبانه آموزش دیدهاند.
فارسی برای این مدلها چند چالش خاص دارد: فاصلهٔ زیاد زبان گفتار و نوشتار («میخوام برم» در برابر «میخواهم بروم»)، نیمفاصله، کلمههای انگلیسی وسط جمله، لهجهها و البته سهم کم فارسی در دادهی آموزشی. به همین دلیل مدلی که در انگلیسی تقریباً بیخطاست، ممکن است در فارسی خیلی ضعیفتر باشد.
دقت را با چه عددی بسنجیم؟ WER و CER
معروفترین معیار دقت، نرخ خطای کلمه (WER) است: تعداد کلمههایی که مدل اشتباه نوشته، جا انداخته یا اضافه کرده، تقسیم بر کل کلمههای متن درست. پس WER برابر ۲۰ درصد یعنی تقریباً از هر پنج کلمه یکی ایراد دارد. هر چه این عدد کمتر باشد بهتر است.
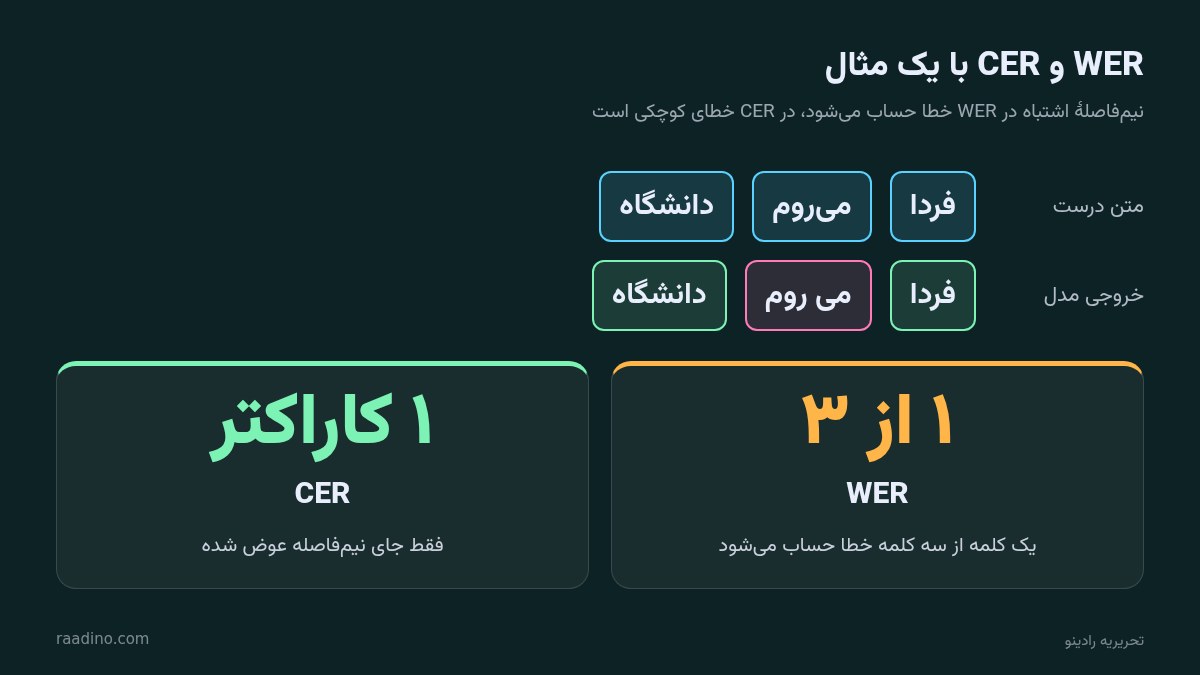
در فارسی یک معیار دیگر هم مهم است: نرخ خطای کاراکتر (CER). چون نوشتن «میروم» با نیمفاصله یا با فاصله، از نظر WER یک خطا حساب میشود، در حالی که معنی درست است. سازندگان بنچمارک فارسی PESTE هم به همین دلیل CER را معیار اصلی گذاشتهاند و نوشتهاند WER فارسی به نحوهٔ جدا کردن کلمهها حساس است.
WER و CER با یک مثال ساده: چرا یک نیمفاصلهٔ اشتباه در WER خطا حساب میشود. منبع تصویر: تحریریه رادینو
بهترین ابزارهای تبدیل ویس به متن فارسی
ابزارهای ایرانی: آوانگار و نویسا
آوانگار سرویس گفتار به متن مرکز تحقیقات هوش مصنوعی پارت است و کاربران عادی از داخل اپ و نسخهٔ وب ویرا به آن دسترسی دارند. ویرا آن را رایگان معرفی میکند و میگوید فارسی رسمی، محاوره و لهجهها را تشخیص میدهد. نسخهٔ API آن برای کسبوکارها دو حالت دارد: صوت کوتاه (زیر ۶۰ ثانیه) و صوت طولانی. طبق مستندات خودش، روی صدای ۱۶ کیلوهرتز آموزش دیده و روی صدای کمنویز و گفتار رسمی بهترین عملکرد را دارد.
نویسا سرویس دیگری است که هم تایپ گفتاری زنده دارد و هم تبدیل فایل صوتی و ویدیویی. طبق سایتش، گویندگان را از هم جدا میکند، زمان هر واژه را میدهد، خروجی Word، زیرنویس SRT و VTT و JSON دارد و یک مدل آفلاین هم ارائه میکند که صدا از کامپیوتر شما خارج نمیشود. تایپ زنده فقط فارسی است و تبدیل فایل فارسی، انگلیسی و عربی را پشتیبانی میکند.
مزیت بزرگ ابزارهای ایرانی این است که برای فارسی ساخته شدهاند و معمولاً بدون فیلترشکن و با پرداخت ریالی کار میکنند. ما دقت آنها را با یک آزمون مستقل و یکسان نسنجیدهایم و در بنچمارکهای عمومی هم حضور ندارند؛ پس پیش از انتخاب، یک فایل واقعی خودتان را امتحان کنید.
سرویسهای جهانی: Gemini، ElevenLabs و OpenAI
Gemini: مدلهای جمنای صدا را مستقیم میفهمند. طبق مستندات Gemini API، هر ثانیه صدا ۳۲ توکن حساب میشود و تا ۹٫۵ ساعت صدا را در یک درخواست میپذیرد. مزیتش این است که میتوانید در همان درخواست بخواهید متن را خلاصه، مرتب یا به زبان رسمی تبدیل کند.
ElevenLabs Scribe v2: طبق مستندات، بیش از ۹۰ زبان از جمله فارسی را پشتیبانی میکند، تا ۳۲ گوینده را از هم جدا میکند و زمانبندی کلمهبهکلمه میدهد.
OpenAI GPT Transcribe: اوپنایآی حالا gpt-transcribe را مدل پیشنهادی برای تبدیل صدای ضبطشده معرفی میکند. مدلهای قدیمیتر whisper-1 و gpt-4o-transcribe منسوخ شدهاند و طبق مستندات در ۲۶ فوریهٔ ۲۰۲۷ خاموش میشوند. فایلها حداکثر ۲۵ مگابایت میتوانند باشند.
جدول Speech to Text سایت Artificial Analysis این سرویسها را مقایسه میکند؛ مثلاً Scribe v2 حدود ۲٫۲ درصد، Gemini 3.5 Transcribe حدود ۲٫۶ درصد و GPT Transcribe حدود ۳٫۳ درصد خطا دارند. اما دقت کنید: دیتاستهای این جدول (AgentTalk، VoxPopuli و Earnings22) انگلیسیاند و این اعداد چیزی دربارهٔ دقت فارسی نمیگویند.
مدلهای متنباز: Whisper و نسخههای فارسیاش
Whisper مدل متنباز اوپنایآی است که فارسی را هم پشتیبانی میکند و نسخههایش از tiny (۳۹ میلیون پارامتر) تا large (حدود ۱٫۵۵ میلیارد پارامتر) است. طبق مخزن رسمی، نسخهٔ large حدود ۱۰ گیگابایت و نسخهٔ turbo حدود ۶ گیگابایت حافظهٔ کارت گرافیک لازم دارد. turbo نسخهٔ بهینهشدهٔ large-v3 است که سریعتر کار میکند و دقتش کمی پایینتر است. پژوهشگران ایرانی چند نسخهٔ فارسیسازیشده از Whisper هم روی Hugging Face منتشر کردهاند که در ادامه نتیجهشان را میبینید. برای اجرای مدلها روی کامپیوتر شخصی، آموزش اجرای هوش مصنوعی روی کامپیوتر را بخوانید.
دقت ابزارها در فارسی؛ بنچمارکها چه میگویند؟
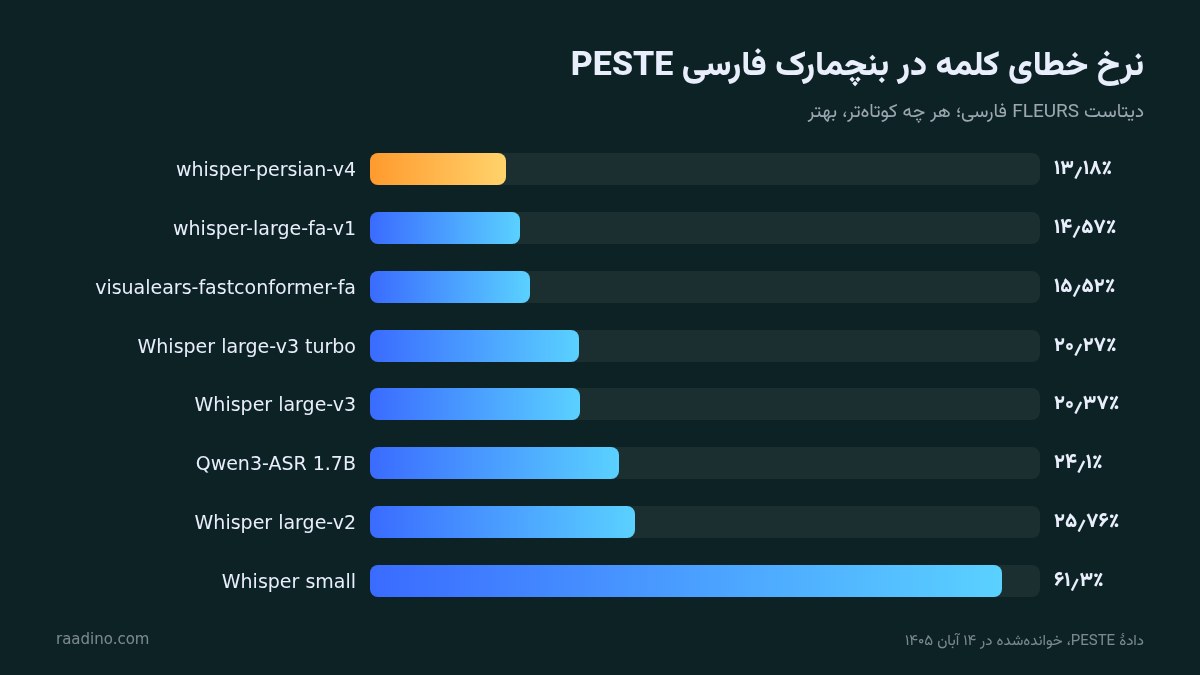
دو بنچمارک مخصوص فارسی، مدلهای متنباز را با دادهی فارسی سنجیدهاند. PESTE مدلها را روی ۸۷۱ فایل فارسی از دیتاست FLEURS (گفتار خواندهشده) میسنجد. این نتیجههای منتخب آن است:
رتبه (CER)
مدل
CER
WER
دقت کلمه
۱
whisper-persian-v4 (nezamisafa)
۴٫۹۷٪
۱۳٫۱۸٪
۸۶٫۸۲٪
۲
visualears-fastconformer-fa
۵٫۱۸٪
۱۵٫۵۲٪
۸۴٫۴۸٪
۳
whisper-large-fa-v1 (vhdm)
۵٫۵۰٪
۱۴٫۵۷٪
۸۵٫۴۳٪
۴
Whisper large-v3 (اصلی)
۵٫۹۷٪
۲۰٫۳۷٪
۷۹٫۶۳٪
۵
Whisper large-v3 turbo (اصلی)
۶٫۱۰٪
۲۰٫۲۷٪
۷۹٫۷۳٪
۱۶
Whisper large-v2 (اصلی)
۸٫۵۱٪
۲۵٫۷۶٪
۷۴٫۲۴٪
۲۰
Qwen3-ASR 1.7B
۸٫۹۲٪
۲۴٫۱۰٪
۷۵٫۹۰٪
۳۷
Whisper small (اصلی)
۲۵٫۹۶٪
۶۱٫۳۰٪
۳۸٫۷۰٪
چند نتیجهٔ مهم از این جدول: اول، نسخههای فارسیسازیشده خطای کلمه را از حدود ۲۰ درصد به ۱۳ تا ۱۵ درصد رساندهاند. دوم، نسخههای کوچک Whisper (small و پایینتر) بدون آموزش فارسی عملاً برای فارسی مناسب نیستند. سوم، سازندگان PESTE خودشان هشدار دادهاند که FLEURS گفتار خواندهشده و تمیز است و نمایندهی گفتار محاوره، پرسروصدا یا لهجهدار نیست.
Open Persian ASR Leaderboard همین کار را روی چند دیتاست متنوعتر انجام داده: Common Voice، ویدیوهای فارسی یوتیوب و مکالمههای خدمات مشتری. در آن، Whisper large-v3 در Common Voice حدود ۴۴ درصد و در مکالمهٔ خدمات مشتری حدود ۷۶ درصد WER داشته؛ یعنی روی گفتار واقعی و تلفنی خیلی ضعیفتر از گفتار تمیز است. بهترین مدل آن جدول (gooya-v1.4) در همین دو دیتاست به ۱۹٫۵ و ۲۲ درصد رسیده است.
نرخ خطای کلمه (WER) مدلهای منتخب در بنچمارک فارسی PESTE روی دیتاست FLEURS. هر چه کوتاهتر، بهتر. منبع تصویر: تحریریه رادینو بر اساس دادهی PESTE
سرویسهای تجاری مثل Gemini، Scribe و GPT Transcribe و ابزارهای ایرانی در این بنچمارکها نیستند. پس دربارهٔ دقت فارسیشان عدد مستقلی نداریم و بهترین راه، آزمون روی فایل خودتان است.
آموزش تبدیل ویس به متن قدمبهقدم
فایل را آماده کنید: ویس تلگرام یا واتساپ معمولاً با فرمت OGG یا OPUS است. اگر ابزار نپذیرفت، آن را به MP3 یا WAV تبدیل کنید.
کیفیت صدا را بالا ببرید: اگر هنوز ضبط نکردهاید، میکروفون را نزدیک دهان بگیرید و در محیط ساکت ضبط کنید. این کار بیشتر از عوض کردن ابزار دقت را بالا میبرد.
زبان را مشخص کنید: اگر ابزار گزینهٔ زبان دارد، فارسی را دستی انتخاب کنید تا تشخیص خودکار اشتباه نکند.
واژههای خاص را بدهید: اسم افراد، برندها و اصطلاحهای تخصصی را اگر ابزار امکانش را دارد (مثل keyterm در Scribe) وارد کنید.
متن را مرور کنید: خروجی را همزمان با پخش صدا بخوانید و اسمها و عددها را حتماً چک کنید.
یک ترفند مفید: متن خام را به یک چتبات بدهید تا نیمفاصلهها را درست کند، علامتگذاری بگذارد و اگر خواستید آن را رسمی کند. فقط بخواهید چیزی به متن اضافه نکند. برای فایلهای خیلی طولانی هم بعد از تبدیل میتوانید از ابزارهای خلاصهسازی متن طولانی کمک بگیرید.
پرامپت نمونه برای ویرایش متن خروجی
این متن از روی یک فایل صوتی فارسی تایپ شده است. فقط این کارها را انجام بده:
۱. علائم نگارشی و نیمفاصلهها را درست کن.
۲. کلمههایی که احتمالاً اشتباه شنیده شدهاند را داخل [ ] علامت بزن.
۳. هیچ جملهای اضافه یا حذف نکن و لحن محاوره را نگه دار.
[متن خروجی]
کدام ابزار برای چه کاری؟
کاربرد
پیشنهاد
دلیل
ویس کوتاه روزمره
آوانگار (ویرا)
رایگان، فارسی محاوره، بدون فیلترشکن
جلسه و مصاحبه با چند گوینده
نویسا یا ElevenLabs Scribe
جدا کردن گویندگان و زمانبندی
زیرنویس ویدیو
نویسا یا Whisper
خروجی SRT و VTT
فایل محرمانه
Whisper یا مدل آفلاین نویسا روی کامپیوتر خودتان
صدا از دستگاه خارج نمیشود
تبدیل و خلاصه در یک قدم
Gemini
فهم مستقیم صدا و پردازش متن در یک درخواست
برنامهنویسها (API)
آوانگار، Gemini یا GPT Transcribe
بسته به دسترسی و پرداخت
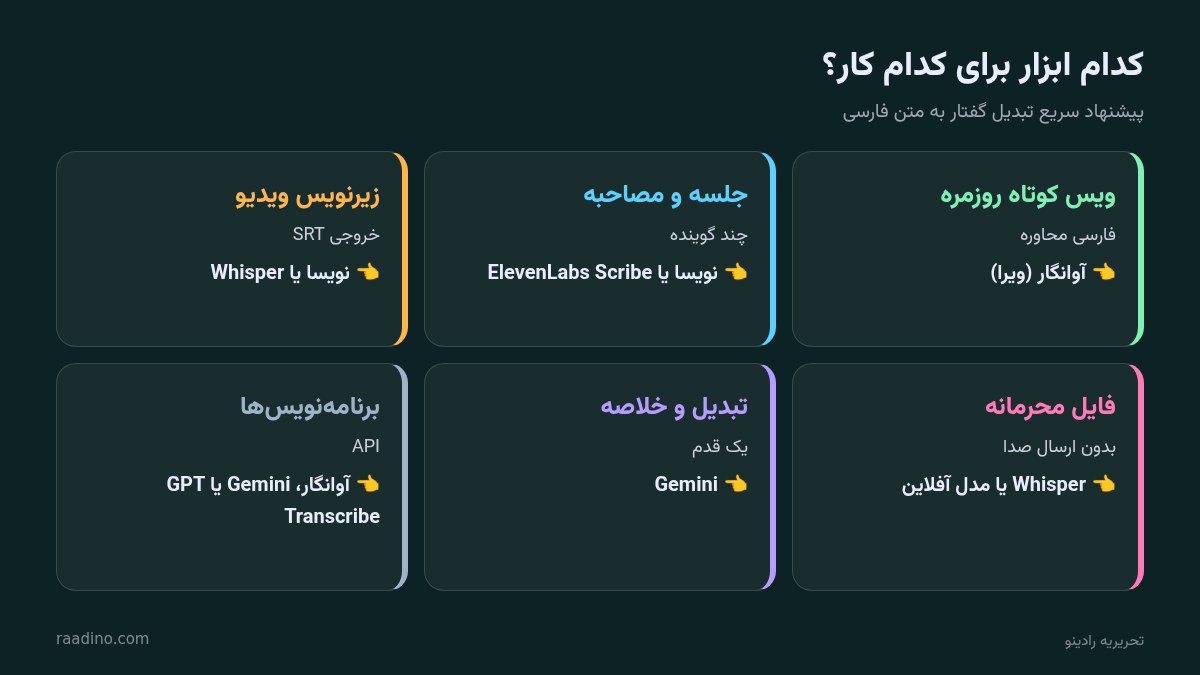
پیشنهاد سریع انتخاب ابزار تبدیل گفتار به متن فارسی بر اساس کاربرد. منبع تصویر: تحریریه رادینو
وقتی فایل جلسه یا مصاحبه را در سرویس آنلاین بارگذاری میکنید، آن فایل روی سرور شرکت دیگری پردازش میشود. برای محتوای محرمانه (جلسههای داخلی شرکت، مشاورههای پزشکی یا حقوقی) یا از مدلهای آفلاین استفاده کنید، یا قوانین نگهداری دادهی سرویس را بخوانید و از کسی که صدایش ضبط شده اجازه بگیرید.
سؤالات متداول
بهترین برنامه تبدیل ویس به متن فارسی کدام است؟
برای کاربر عادی، آوانگار در اپ ویرا و نویسا گزینههای ایرانی و سادهاند. برای کار حرفهای با چند گوینده، Scribe و نویسا امکانات بیشتری دارند. بنچمارک مستقل یکسانی برای مقایسهٔ همهٔ آنها در فارسی وجود ندارد.
دقت Whisper در فارسی چقدر است؟
در بنچمارک PESTE، Whisper large-v3 حدود ۲۰ درصد خطای کلمه و حدود ۶ درصد خطای کاراکتر دارد. روی گفتار محاوره و تلفنی خطا خیلی بیشتر میشود. نسخههای فارسیسازیشده دقیقترند.
WER چیست؟
نرخ خطای کلمه؛ درصد کلمههایی که مدل اشتباه نوشته، جا انداخته یا اضافه کرده است. هر چه کمتر باشد، دقت بیشتر است.
آیا میتوان بدون اینترنت صدا را به متن تبدیل کرد؟
بله. Whisper و نسخههای فارسیاش روی کامپیوتر اجرا میشوند و نویسا هم مدل آفلاین دارد. برای مدلهای بزرگ، کارت گرافیک با حافظهٔ کافی لازم است.
چرا دقت روی ویس تلگرام پایین است؟
ویسها معمولاً با میکروفون گوشی، در محیط پرسروصدا و با گفتار محاوره ضبط میشوند و فشردهاند. بنچمارکها هم نشان میدهند خطای مدلها روی چنین صدایی چند برابر گفتار تمیز است.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.