فرض کنید یک دستیار هوش مصنوعی دارید که بدون اینترنت کار میکند، اطلاعات شما را به هیچ سروری نمیفرستد، تحریم و فیلتر نمیشناسد و ماهانه هم هزینهای ندارد. این دقیقاً کاری است که Ollama انجام میدهد: مدلهای زبانی متنباز را روی کامپیوتر خودتان دانلود و اجرا میکند.
در این آموزش قدمبهقدم Ollama را روی ویندوز، مک یا لینوکس نصب میکنیم، اولین مدل را اجرا میکنیم، با دستورهای اصلی آشنا میشویم و یاد میگیریم چطور آن را به برنامههای دیگر وصل کنیم. اگر هنوز نمیدانید سیستمتان برای این کار کافی است یا نه، اول راهنمای سختافزار لازم برای اجرای مدل زبانی را بخوانید.
آخرین بهروزرسانی: ۱۱ آبان ۱۴۰۵ — دستورها، نیازمندیها و اندازهٔ مدلها از مستندات رسمی Ollama، کتابخانهٔ مدلهای ollama.com و صفحهٔ انتشارهای گیتهاب (نسخهٔ ۰٫۴۰٫۱۳) در همین تاریخ برداشته شدهاند.
⚡ پاسخ کوتاه
Ollama را از سایت رسمی دانلود و نصب کنید (ویندوز ۱۰ نسخهٔ 22H2 به بعد، مکاواس ۱۴ به بعد یا لینوکس با یک دستور). بعد در ترمینال بنویسید ollama run gemma4 تا مدل جمای ۴ (حدود ۷ تا ۱۰ گیگابایت) دانلود و اجرا شود. بعد از دانلود، همه چیز بدون اینترنت کار میکند. برای سیستمهای ضعیفتر gemma4:e2b و برای کارتهای گرافیک ۲۴ گیگابایتی qwen3.8 یا gpt-oss:20b گزینههای خوبیاند. Ollama یک API سازگار با OpenAI روی آدرس localhost:11434 هم دارد.
Ollama یک برنامهٔ رایگان و متنباز است که کار سخت اجرای مدلهای زبانی را ساده میکند. بهجای درگیر شدن با پایتون، کتابخانهها و فایلهای چندگیگابایتی، با یک دستور مدل را دانلود و اجرا میکنید. پروژهٔ Ollama در گیتهاب بیش از ۱۸۵ هزار ستاره دارد و از محبوبترین ابزارهای این حوزه است.
مزیتهای اجرای محلی روشن است:
حریم خصوصی کامل: متنها، اسناد و کدهای شما از کامپیوترتان خارج نمیشوند.
کار بدون اینترنت: بعد از دانلود مدل، هیچ اتصالی لازم نیست؛ در قطعی اینترنت هم دستیارتان کار میکند.
بدون هزینهٔ ماهانه: اجرای مدلهای محلی رایگان است و فقط برق مصرف میکند.
بدون تحریم و محدودیت حساب: نیازی به ثبتنام در سرویس خارجی یا پرداخت ارزی نیست.
البته مدلهای محلی هنوز به پای قویترین مدلهای ابری نمیرسند. برای اینکه بدانید کدام مدل متنباز چقدر قوی است، رتبهبندی بهترین مدلهای متنباز را ببینید.
پیشنیازها: سیستم شما کافی است؟
Ollama روی هر سه سیستمعامل اصلی کار میکند، اما سرعت آن بیشتر از همه به حافظهٔ کارت گرافیک (VRAM) یا حافظهٔ یکپارچهٔ مک بستگی دارد. نیازمندیهای رسمی:
ویندوز: ویندوز ۱۰ نسخهٔ 22H2 یا جدیدتر و حداقل ۴ گیگابایت فضای خالی برای خود برنامه (مدلها جداگانه دهها گیگابایت فضا میخواهند). برای کارتهای انویدیا درایور 551.61 به بعد لازم است. نصب به دسترسی مدیر (Administrator) نیاز ندارد.
مک: مکاواس Sonoma (نسخهٔ ۱۴) یا جدیدتر. روی مکهای اپل سیلیکون (سری M) از پردازندهٔ گرافیکی استفاده میشود و روی مکهای اینتلی فقط پردازنده.
لینوکس: کارتهای انویدیا با Compute Capability نسخهٔ ۵٫۰ به بالا و کارتهای AMD با ROCm یا Vulkan پشتیبانی میشوند.
بهعنوان یک قاعدهٔ سرانگشتی، مدلی را انتخاب کنید که حجمش از VRAM شما کمتر باشد تا کامل روی کارت گرافیک اجرا شود. جزئیات محاسبهٔ حافظه را در مقالهٔ سختافزار گفتهایم و اینجا تکرار نمیکنیم. اگر کارت گرافیک ندارید، مدلهای کوچک روی پردازنده و رم هم اجرا میشوند؛ فقط کندترند.
آموزش نصب Ollama
نصب روی ویندوز
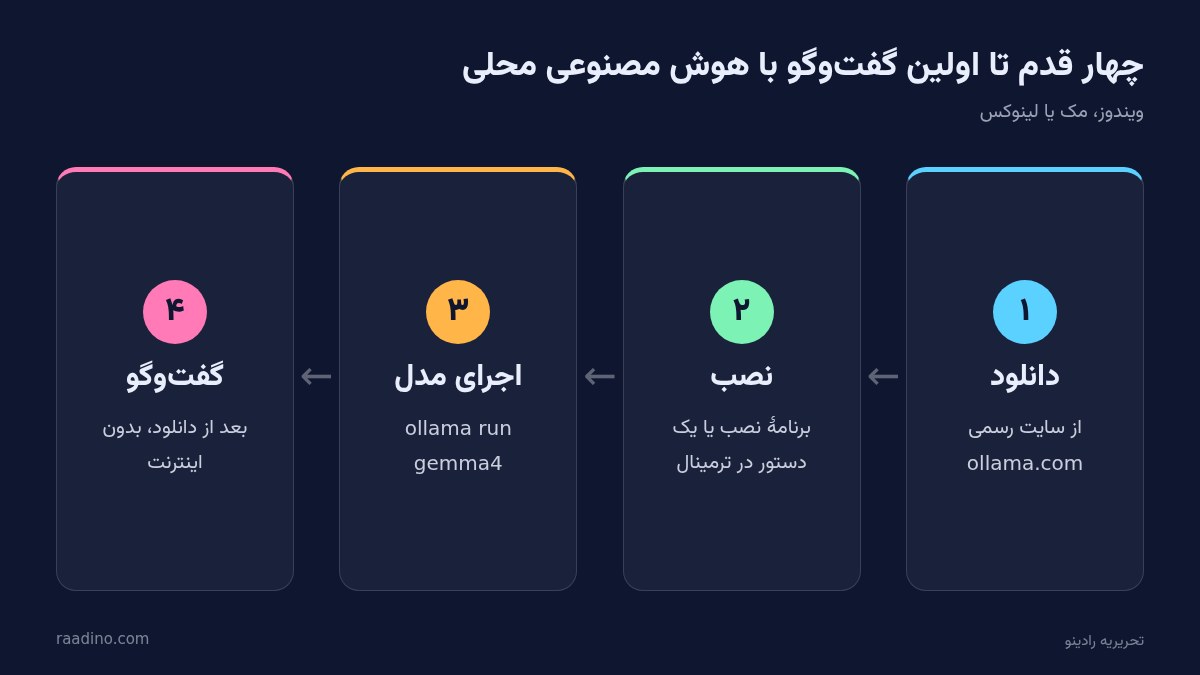
فایل OllamaSetup.exe را از صفحهٔ دانلود سایت ollama.com بگیرید و اجرا کنید. اگر با PowerShell راحتترید، این دستور هم همین کار را میکند:
irm https://ollama.com/install.ps1 | iex
نصب روی مک و لینوکس
در مک میتوانید برنامه را از سایت دانلود کنید و در پوشهٔ Applications بکشید. روی لینوکس (و مک از طریق ترمینال) کافی است این دستور را اجرا کنید:
curl -fsSL https://ollama.com/install.sh | sh
بعد از نصب، Ollama در پسزمینه اجرا میشود. نسخهٔ دسکتاپ یک پنجرهٔ چت ساده هم دارد، اما ما برای کنترل بیشتر از ترمینال استفاده میکنیم.
چهار مرحله تا اولین گفتوگو با هوش مصنوعی محلی. منبع تصویر: تحریریه رادینو
اجرای اولین مدل و دستورهای اصلی
ترمینال (یا PowerShell) را باز کنید و بنویسید:
ollama run gemma4
بار اول، Ollama مدل را دانلود میکند (برای gemma4 حدود ۷ تا ۱۰ گیگابایت) و بعد یک خط فرمان برای گفتوگو باز میشود. سؤالتان را بنویسید و Enter بزنید. برای خروج /bye را تایپ کنید. دستورهای پرکاربرد دیگر:
دستور
کاربرد
ollama pull qwen3.8
فقط دانلود مدل بدون اجرا
ollama list
نمایش مدلهای دانلودشده
ollama ps
مدلهای در حال اجرا، حافظهٔ مصرفی و سهم GPU/CPU
ollama rm gemma4
حذف مدل و آزاد کردن فضا
ollama stop gemma4
خارج کردن مدل از حافظه
ollama launch claude
اجرای ابزار کدنویسی Claude Code با مدلهای Ollama
Ollama مدل را بعد از آخرین استفاده بهطور پیشفرض ۵ دقیقه در حافظه نگه میدارد تا پاسخ بعدی سریعتر باشد. اگر رم یا VRAM کم دارید، بعد از کار با ollama stop مدل را از حافظه خارج کنید.
کدام مدل را روی Ollama اجرا کنیم؟
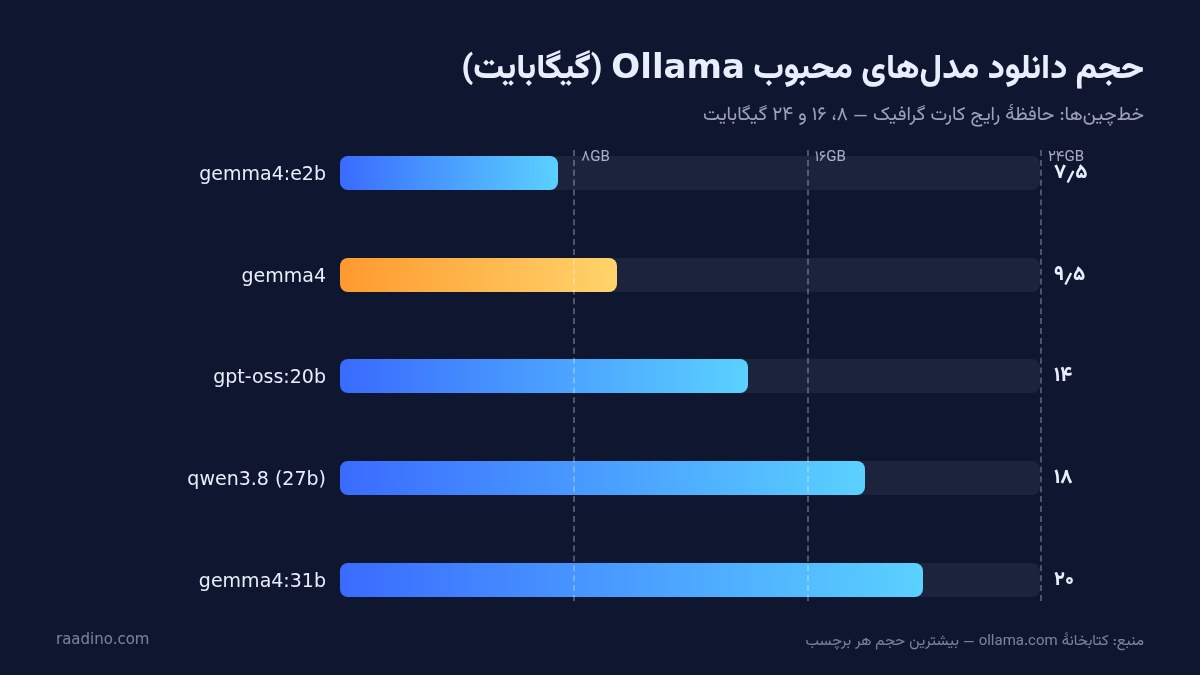
کتابخانهٔ Ollama صدها مدل دارد. اینها چند انتخاب خوب برای شروعاند (حجمها از صفحهٔ رسمی هر مدل):
مدل
حجم دانلود
پنجرهٔ متنی
مناسب برای
gemma4:e2b
۴٫۶ تا ۷٫۵ گیگابایت
۱۲۸ هزار توکن
لپتاپ و سیستمهای ضعیف
gemma4 (همان e4b)
۶٫۶ تا ۹٫۵ گیگابایت
۱۲۸ هزار توکن
شروع؛ متن و تصویر
gpt-oss:20b
۱۴ گیگابایت
۱۲۸ هزار توکن
استدلال و کارهای عمومی
qwen3.8 (27b)
۱۸ گیگابایت
۲۵۶ هزار توکن
کدنویسی و کارهای ایجنتی؛ کارت ۲۴ گیگ
gemma4:31b
۱۹ تا ۲۰ گیگابایت
۲۵۶ هزار توکن
بهترین کیفیت جمای ۴ روی کارت ۲۴ گیگ
برای فارسی، مدلهای جمای و کوئن عملکرد بهتری دارند. اگر به خانوادهٔ متا علاقه دارید، مدلهای لاما هم در کتابخانه هستند؛ دربارهٔ آنها در همه چیز دربارهٔ هوش مصنوعی لاما نوشتهایم. مدلهای هوش مصنوعی چینی مثل دیپسیک و کوئن هم از محبوبترینهای اجرای محلیاند.
حجم دانلود چند مدل محبوب Ollama در کنار ظرفیت رایج حافظهٔ کارت گرافیک. منبع تصویر: تحریریه رادینو بر اساس کتابخانهٔ ollama.com
تنظیم پنجرهٔ متنی و محل ذخیرهٔ مدلها
یکی از تنظیمات مهمی که کمتر کسی به آن توجه میکند، طول پنجرهٔ متنی است. Ollama آن را بر اساس VRAM تعیین میکند: زیر ۲۴ گیگابایت ۴ هزار توکن، بین ۲۴ تا ۴۸ گیگابایت ۳۲ هزار توکن و بالاتر از آن ۲۵۶ هزار توکن. یعنی روی بیشتر کامپیوترهای خانگی، مدل فقط حدود ۴ هزار توکن آخر گفتوگو را به یاد دارد. مستندات Ollama برای کارهای ایجنتی و کدنویسی حداقل ۶۴ هزار توکن را توصیه میکند:
OLLAMA_CONTEXT_LENGTH=64000 ollama serve
در نسخهٔ دسکتاپ همین کار با یک اسلایدر در تنظیمات انجام میشود. یادتان باشد پنجرهٔ بزرگتر حافظهٔ بیشتری مصرف میکند؛ با ollama ps بررسی کنید مدل ۱۰۰٪ روی GPU مانده باشد. اگر درایو C پر است، با متغیر محیطی OLLAMA_MODELS محل ذخیرهٔ مدلها را به درایو دیگری منتقل کنید.
اتصال Ollama به برنامهها با API
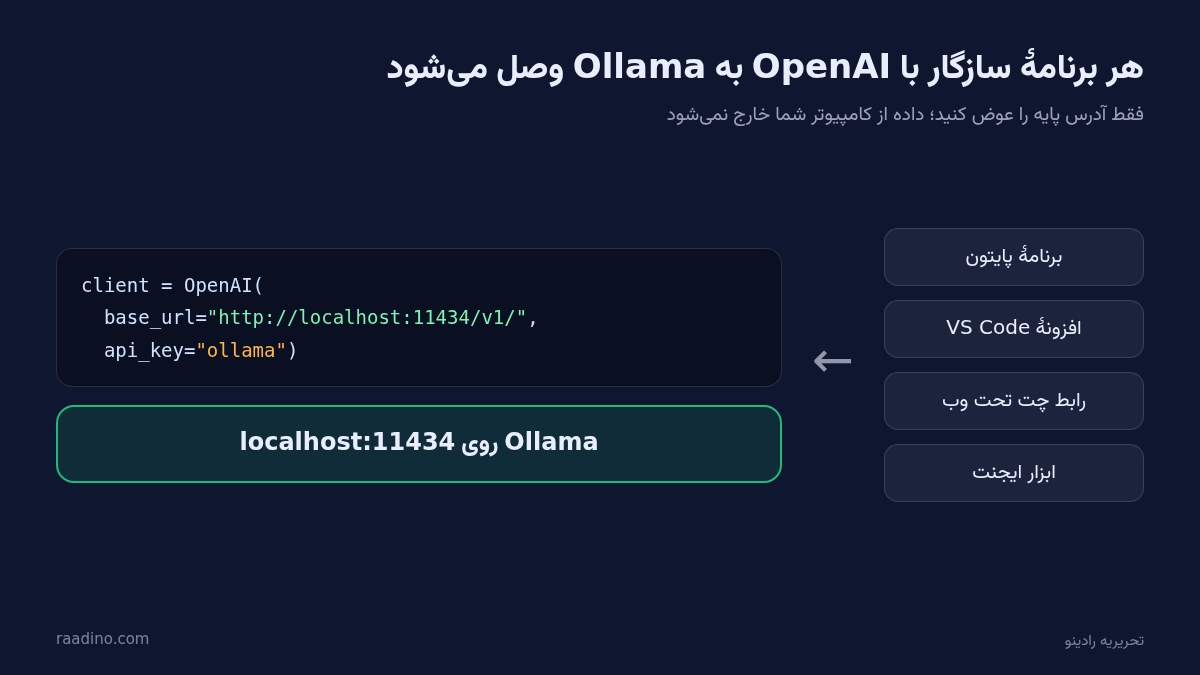
Ollama روی آدرس http://localhost:11434 یک API دارد که با کتابخانههای OpenAI سازگار است. یعنی هر برنامهای که برای جیپیتی نوشته شده، با تغییر آدرس پایه به Ollama وصل میشود:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:11434/v1/", api_key="ollama")
r = client.chat.completions.create(
    model="gemma4",
    messages=[{"role": "user", "content": "سه ایده برای نام یک کافه بده"}],
)
print(r.choices[0].message.content)
بهطور پیشفرض این API فقط روی خود کامپیوتر (127.0.0.1) در دسترس است که از نظر امنیتی درست است. اگر میخواهید از کامپیوترهای دیگر شبکه هم وصل شوید، متغیر OLLAMA_HOST را تغییر دهید، اما هرگز آن را بدون محافظت روی اینترنت باز نکنید. برای اتصال مدل محلی به ابزارها و فایلها هم میتوانید از MCP استفاده کنید.
هر برنامهٔ سازگار با OpenAI با تغییر آدرس پایه به Ollama وصل میشود. منبع تصویر: تحریریه رادینو
رفع مشکلات رایج
پاسخها خیلی کند است: دستور ollama ps را بزنید. اگر در ستون PROCESSOR بخشی از مدل روی CPU است، یعنی مدل در VRAM جا نشده؛ مدل کوچکتر یا پنجرهٔ متنی کوتاهتر انتخاب کنید.
خطای کمبود حافظه: نسخهٔ فشردهتر همان مدل را امتحان کنید. در صفحهٔ هر مدل در کتابخانه، برچسبهایی مثل q4_K_M حجم کمتری دارند.
پیام اشغال بودن پورت ۱۱۴۳۴: معمولاً یعنی Ollama از قبل در پسزمینه اجرا شده است و نیازی به اجرای دوبارهٔ ollama serve نیست.
دانلود مدل نیمهکاره ماند: همان دستور pull یا run را دوباره اجرا کنید. چون فایلها بزرگاند، بهتر است دانلود را با اینترنت پایدار انجام دهید.
کارت گرافیک شناسایی نمیشود: درایور را بهروز کنید و فهرست کارتهای پشتیبانیشده را در صفحهٔ Hardware support مستندات ببینید.
Ollama یا LM Studio؟
LM Studio رقیب اصلی Ollama است و با رابط گرافیکی کامل، برای کسانی که با ترمینال راحت نیستند جذابتر است. نسخهٔ تازهٔ آن، LM Studio Bionic، روی قابلیتهای ایجنتی تمرکز دارد؛ اجرای محلی مدلها همچنان رایگان است و پلنهای پولی برای امکانات اضافه ارائه میشوند. اگر میخواهید مدل را به برنامهها و اسکریپتها وصل کنید یا روی سرور اجرا کنید، Ollama سبکتر و انعطافپذیرتر است.
خود Ollama هم برای مدلهای خیلی بزرگ یک سرویس ابری اختیاری دارد (مدلهایی با پسوند cloud) که پلن Pro آن ماهی ۲۰ دلار است؛ اما اجرای محلی کاملاً رایگان باقی میماند. برای اجرای هوش مصنوعی روی گوشی هم سراغ هوش مصنوعی روی گوشی بروید.
سؤالات متداول
آیا Ollama واقعاً بدون اینترنت کار میکند؟
بله. فقط برای نصب و دانلود مدلها اینترنت لازم است. بعد از آن میتوانید اینترنت را قطع کنید و مدلها کاملاً محلی اجرا میشوند.
بدون کارت گرافیک هم میشود از Ollama استفاده کرد؟
بله، مدلهای کوچک مثل gemma4:e2b با رم کافی روی پردازنده هم اجرا میشوند، اما سرعت پاسخ محسوساً کمتر است.
Ollama رایگان است؟
بله. خود برنامه متنباز است و اجرای مدلهای محلی هزینهای ندارد. فقط سرویس ابری اختیاری آن پلن پولی دارد.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.