ابزارهای هوش مصنوعی حالا بخش بزرگی از کد را مینویسند. Veracode در گزارش ۲۰۲۶ خود میگوید در تیمهایی که از این ابزارها استفاده میکنند، تقریباً نیمی از کدهای commitشده را هوش مصنوعی نوشته است. کدی که سریع نوشته میشود، اجرا میشود و تمیز به نظر میرسد، الزاماً امن نیست.
در این مقاله میبینیم کدهای تولیدشده با هوش مصنوعی چقدر آسیبپذیری دارند، چه ریسکهایی بیشتر از همه تکرار میشوند، ایجنتهای کدنویسی چه خطرهای تازهای اضافه کردهاند و با یک چکلیست ساده چطور کد AI را قبل از رسیدن به سرور واقعی بازبینی کنیم. اگر هنوز ابزار مناسب را انتخاب نکردهاید، مقالهٔ بهترین هوش مصنوعی برای برنامهنویسی را ببینید.
آخرین بهروزرسانی: ۶ آبان ۱۴۰۵ — آمارها از گزارشها و پژوهشهای منتشرشده است و منبع هر عدد در متن آمده.
⚡ پاسخ کوتاه
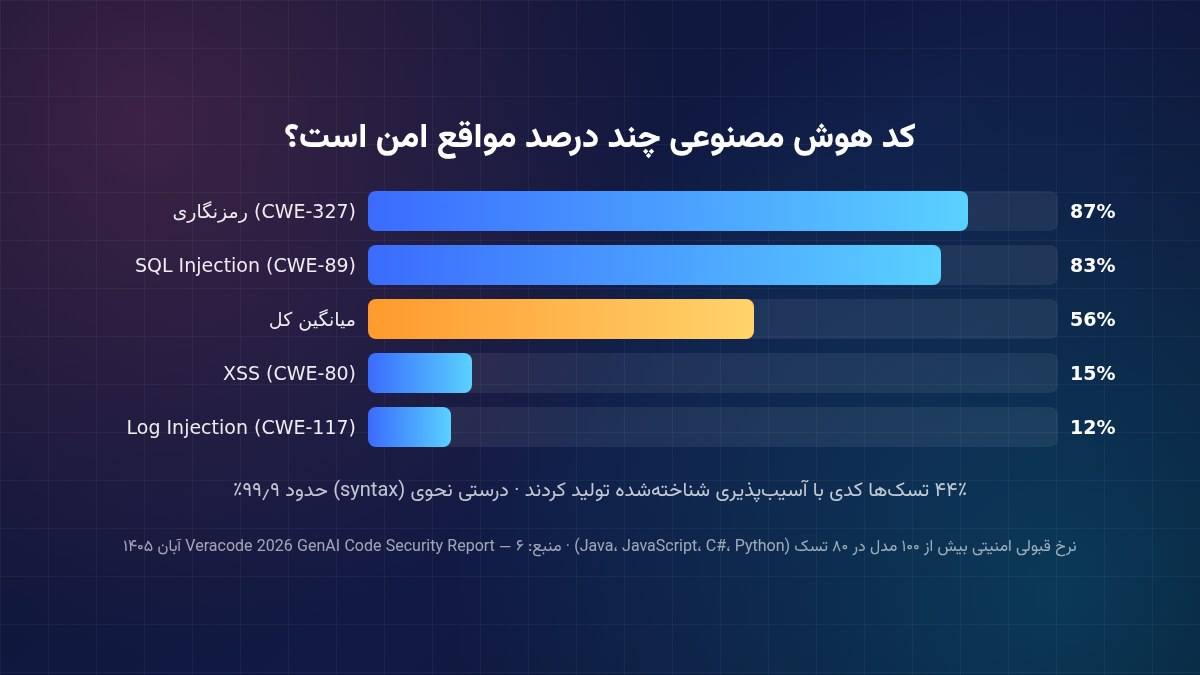
طبق گزارش امنیت کد GenAI سال ۲۰۲۶ شرکت Veracode، در حدود ۴۴٪ تسکها مدلهای هوش مصنوعی کدی با یک آسیبپذیری شناختهشده تولید کردند و میانگین نرخ قبولی امنیتی ۵۶٪ است؛ تقریباً همان ۵۵٪ گزارش اول. مدلها در جلوگیری از SQL Injection خوباند (۸۳٪) اما در XSS فقط ۱۵٪ و در Log Injection فقط ۱۲٪ موفقاند. راهحل، کنار گذاشتن AI نیست؛ بازبینی انسانی، اسکن خودکار (SAST)، بررسی وابستگیها و رازها و محدود کردن دسترسی ایجنتهاست.
نرخ قبولی امنیتی مدلها در انواع آسیبپذیری طبق گزارش Veracode 2026. منبع تصویر: تحریریه رادینو
Veracode در چهار سال گذشته بیش از ۱۰۰ مدل را روی ۸۰ تسک کدنویسی در چهار زبان Java، JavaScript، C# و Python آزموده است. هر تسک طوری طراحی شده که مدل میتواند آن را امن یا ناامن پیاده کند و هیچ دستور امنیتی خاصی در پرامپت نیست. مهمترین یافتهها:
یافته
عدد
تسکهایی که کد آسیبپذیر تولید کردند
حدود ۴۴٪
میانگین نرخ قبولی امنیتی (تابستان ۲۰۲۶)
۵۶٪ (در گزارش اول ۵۵٪)
درستی نحوی (syntax) کد
حدود ۹۹.۹٪
بهترین مدل این دوره (GPT-5.5)
۶۸٪
مدلهای استدلالی در برابر غیراستدلالی
۵۶٪ در برابر ۵۱٪
مدلهای تخصصی کدنویسی در برابر مدلهای عمومی
۵۱٪ در برابر ۵۲٪
اندازهٔ مدل (بزرگ / متوسط / کوچک)
۵۳٪ / ۵۱٪ / ۵۱٪
نکتهٔ اصلی این است که با وجود پیشرفت زیاد مدلها در نوشتن کد درست و قابل اجرا، امنیت تقریباً ثابت مانده است. Veracode مینویسد «Syntax حل شده، اما امنیت نه». حتی مدلهای بزرگتر یا مخصوص کدنویسی هم امنتر نیستند؛ و صدرنشین سال قبل در این گزارش ۷۲٪ داشت، یعنی بهترین عدد امسال حتی پایینتر است.
کدام آسیبپذیریها بیشتر تکرار میشوند؟
در گزارش Veracode، مدلها در دو مورد عملکرد خوبی دارند: جلوگیری از SQL Injection (CWE-89) با میانگین ۸۳٪ و انتخاب الگوریتم رمزنگاری امن (CWE-327) با ۸۷٪. اما در دو مورد دیگر وضع بسیار بد است: Cross-Site Scripting یا XSS (CWE-80) با ۱۵٪ و Log Injection (CWE-117) با ۱۲٪. یعنی در ۸۵٪ موارد، کد AI جلوی XSS را نگرفته است. این مهم است، چون XSS (CWE-79) در فهرست CWE Top 25 سال ۲۰۲۵ رتبهٔ اول خطرناکترین ضعفهای نرمافزاری را دارد و SQL Injection رتبهٔ دوم.
این مشکل تازه نیست
یکی از اولین پژوهشهای جدی در این زمینه، مقالهٔ «Asleep at the Keyboard?» در سال ۲۰۲۱ بود. پژوهشگران GitHub Copilot را در ۸۹ سناریوی مرتبط با ضعفهای پرخطر CWE آزمودند و از ۱۶۸۹ برنامهٔ تولیدشده، حدود ۴۰٪ آسیبپذیر بودند. چند سال و چند نسل مدل بعد، عدد Veracode (حدود ۴۴٪ تسک ناامن) نشان میدهد این مسئله با بزرگتر شدن مدلها خودبهخود حل نشده است.
ریسکهای رایج در کد تولیدشده با هوش مصنوعی
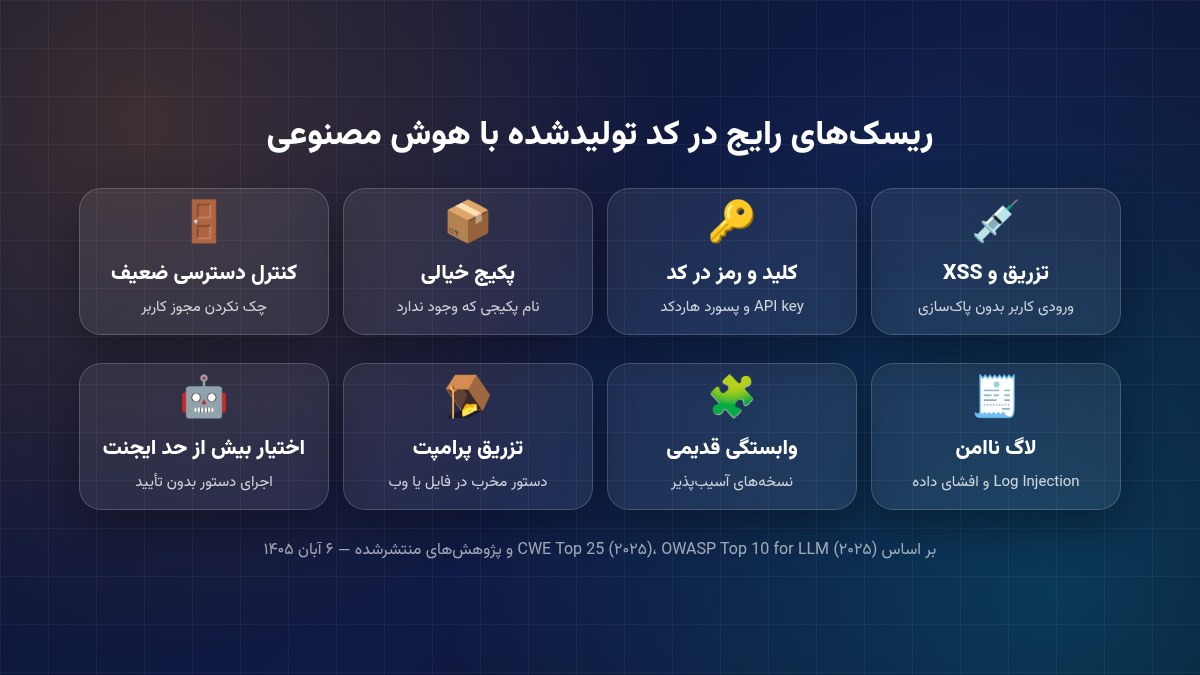
هشت ریسک رایج در کد و ایجنتهای هوش مصنوعی. منبع تصویر: تحریریه رادینو
تزریق (Injection) و XSS: استفاده از ورودی کاربر در کوئری، دستور سیستم یا HTML بدون پاکسازی و escape.
رازهای هاردکد: قرار دادن کلید API، پسورد دیتابیس یا توکن داخل کد نمونهای که بعداً به مخزن میرود.
پکیجهای خیالی: مدل نام کتابخانهای را پیشنهاد میکند که وجود ندارد. مهاجم میتواند همان نام را ثبت کند و کد مخرب منتشر کند (حملهٔ زنجیرهٔ تأمین).
کنترل دسترسی ضعیف: فراموش کردن بررسی مجوز کاربر؛ مثلاً CWE-862 (نبود احراز مجوز) رتبهٔ چهارم CWE Top 25 سال ۲۰۲۵ است.
وابستگیهای قدیمی: مدل ممکن است نسخههای قدیمی و آسیبپذیر کتابخانهها را پیشنهاد کند، چون دانش آن تا تاریخ مشخصی است.
مدیریت خطا و لاگ ناامن: ثبت اطلاعات حساس در لاگ یا Log Injection.
دربارهٔ پکیجهای خیالی، پژوهشی که ۵۷۶ هزار نمونه کد از ۱۶ مدل را بررسی کرد، نشان داد میانگین پکیجهای خیالی دستکم ۵.۲٪ در مدلهای تجاری و ۲۱.۷٪ در مدلهای متنباز است و در مجموع ۲۰۵٬۴۷۴ نام پکیج خیالی منحصربهفرد پیدا شد. این همان پدیدهٔ توهم هوش مصنوعی است که این بار مستقیم به امنیت میرسد.
ایجنتهای کدنویسی و ریسکهای تازه
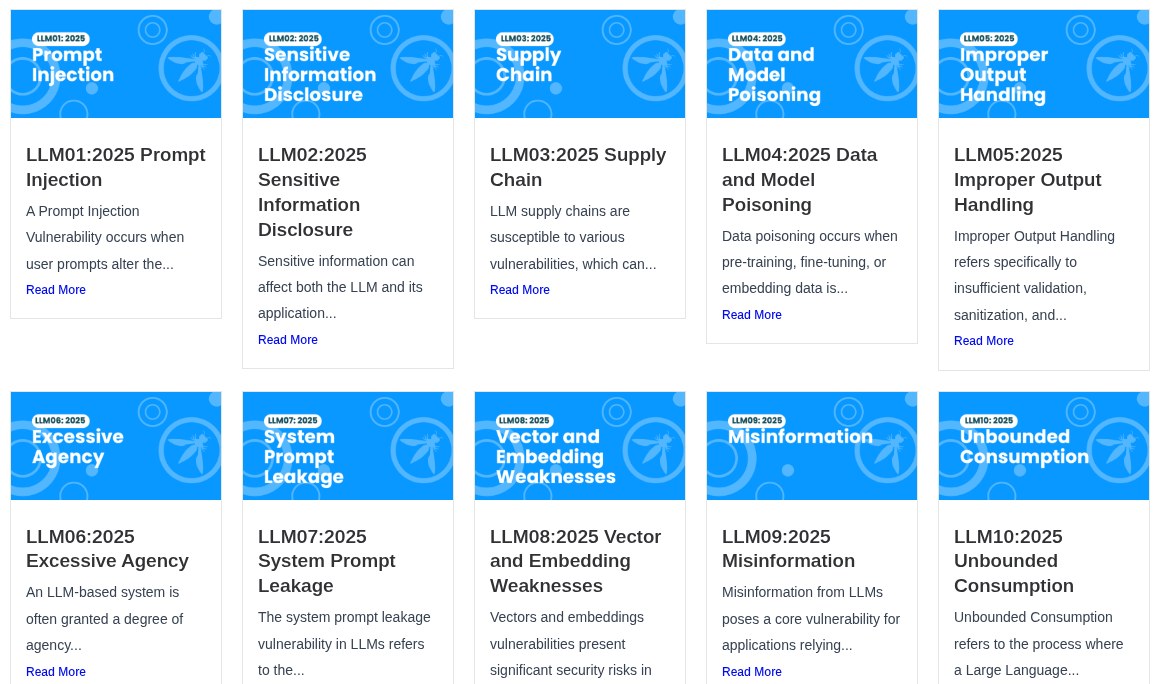
ده ریسک اصلی برنامههای مبتنی بر LLM در فهرست OWASP Top 10 for LLM Applications 2025. منبع تصویر: OWASP GenAI Security Project
وقتی هوش مصنوعی فقط پیشنهاد کد میدهد، شما آخرین نفری هستید که کد را میبینید. اما ایجنتهایی مثل Claude Code میتوانند فایل بنویسند، دستور اجرا کنند و از طریق پروتکل MCP به ابزارهای دیگر وصل شوند. فهرست OWASP Top 10 for LLM Applications 2025 چند ریسک را نام میبرد که مستقیم به این ایجنتها مربوط است:
LLM01: Prompt Injection: دستور مخرب داخل یک فایل، صفحهٔ وب یا issue که ایجنت میخواند و ممکن است آن را اجرا کند.
LLM03: Supply Chain: مدلها، پلاگینها و پکیجهای آلوده.
LLM05: Improper Output Handling: اعتماد کردن به خروجی مدل و اجرای مستقیم آن بدون اعتبارسنجی.
LLM06: Excessive Agency: دسترسی بیش از نیاز به ایجنت؛ مثلاً حق حذف فایل یا دسترسی به سرور تولید.
مستندات امنیتی Claude Code نمونهٔ خوبی از کنترل این ریسکهاست: معماری مبتنی بر مجوز، حالتی که در آن کارهای حساس به تأیید صریح کاربر نیاز دارد، و sandbox برای محدود کردن دسترسی فایل و شبکهٔ دستورهای bash. هر ابزار ایجنتی که استفاده میکنید، این تنظیمات را جدی بگیرید.
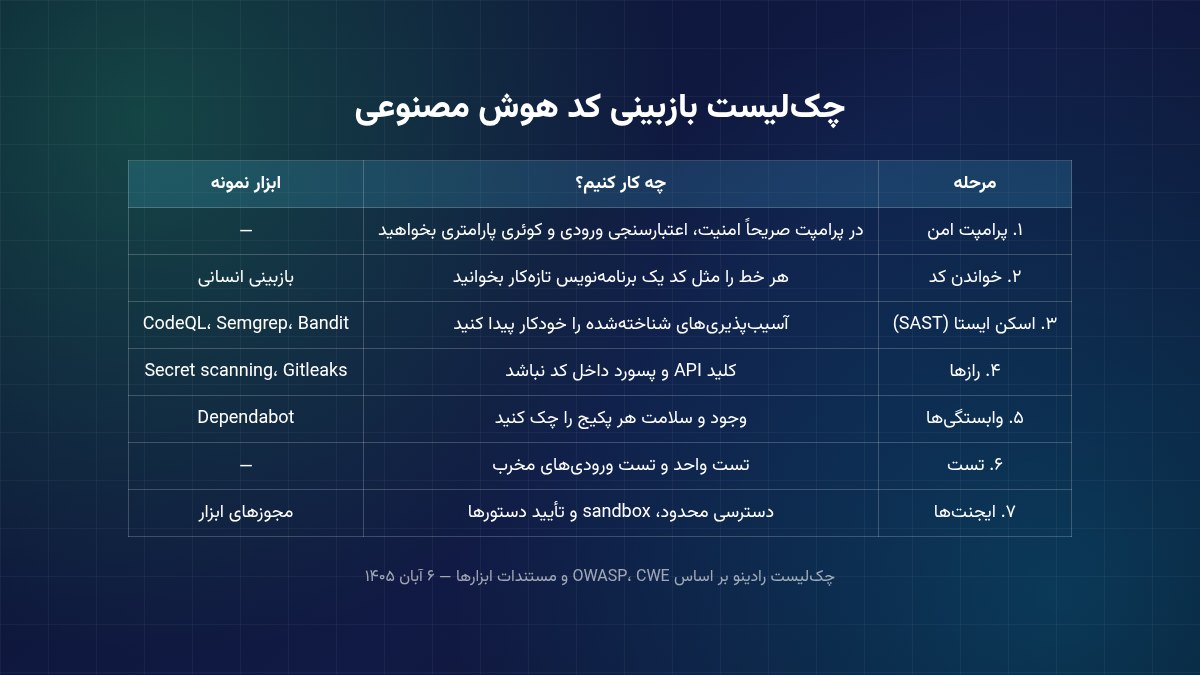
این چکلیست را برای هر کدی که هوش مصنوعی نوشته، قبل از merge یا انتشار اجرا کنید:
۱. امنیت را در پرامپت بخواهید: صریحاً بنویسید «ورودیها را اعتبارسنجی کن، از کوئری پارامتری استفاده کن، خروجی HTML را escape کن». گزارش Veracode تأکید میکند که نتایجش بدون راهنمایی امنیتی در پرامپت به دست آمده است.
۲. کد را بخوانید، نه فقط اجرا کنید: کد AI را مثل کد یک همکار تازهکار بازبینی کنید؛ بهخصوص هر جایی که ورودی کاربر وارد میشود.
۳. اسکن ایستا (SAST): ابزارهایی مثل CodeQL، Semgrep یا Bandit (برای Python) را در CI اجرا کنید تا الگوهای ناامن خودکار پیدا شوند.
۴. اسکن رازها: با Secret scanning گیتهاب یا Gitleaks مطمئن شوید هیچ کلید و پسوردی وارد مخزن نشده است.
۵. وابستگیها را چک کنید: قبل از نصب هر پکیج پیشنهادی، وجود، محبوبیت و نگهدارندهاش را بررسی کنید و Dependabot را برای بهروزرسانی فعال کنید.
۶. تست امنیتی بنویسید: علاوه بر تست عملکرد، ورودیهای مخرب (مثل اسکریپت و کاراکترهای خاص SQL) را هم تست کنید.
۷. دسترسی ایجنت را محدود کنید: ایجنت را در محیط جدا و با sandbox اجرا کنید، دستورهای حساس را تأیید دستی کنید و دسترسی آن به سرور تولید و رازها را ببندید.
💡 برای وردپرس: اگر با هوش مصنوعی افزونه یا قالب وردپرس مینویسید، همهٔ ورودیها را sanitize و خروجیها را escape کنید و پلاگینها و قالبها را بهروز نگه دارید؛ مقالهٔ بهروز نگه داشتن قالبها و افزونههای وردپرس را ببینید.
وایبکدینگ؛ سرعت بالا، ریسک بالا
وایبکدینگ یعنی ساخت برنامه فقط با توصیف خواستهها و پذیرفتن کد AI بدون خواندن دقیق آن. برای نمونهٔ اولیه و پروژهٔ شخصی عالی است، اما وقتی همان کد بدون بازبینی به محصول واقعی با دادههای کاربران میرسد، همهٔ ریسکهای بالا را با خودش میآورد. اصول کدنویسی تمیز و حرفهای همچنان لازم است؛ هوش مصنوعی سرعت را بالا میبرد، اما مسئولیت کد با شماست.
اگر برای کسبوکارتان سایت یا نرمافزاری میخواهید که امنیت آن از ابتدا جدی گرفته شود، میتوانید از خدمات طراحی و توسعهٔ سایت رادینو کمک بگیرید.
سؤالات متداول
آیا کد تولیدشده با هوش مصنوعی امن است؟
نه بهصورت پیشفرض. طبق گزارش Veracode 2026، حدود ۴۴٪ تسکها کدی با آسیبپذیری شناختهشده تولید کردند و میانگین نرخ قبولی امنیتی ۵۶٪ بود. کد AI باید مثل هر کد دیگری بازبینی و تست شود.
کدام آسیبپذیری در کد هوش مصنوعی رایجتر است؟
در گزارش Veracode، مدلها در جلوگیری از XSS فقط ۱۵٪ و در Log Injection فقط ۱۲٪ موفق بودند، در حالی که در SQL Injection به ۸۳٪ رسیدند.
پکیج خیالی (package hallucination) چیست؟
وقتی مدل نام کتابخانهای را پیشنهاد میکند که وجود ندارد. پژوهشی روی ۱۶ مدل نشان داد این نرخ دستکم ۵.۲٪ در مدلهای تجاری و ۲۱.۷٪ در مدلهای متنباز است. مهاجم میتواند همان نام را با کد مخرب ثبت کند.
آیا مدلهای بزرگتر کد امنتری مینویسند؟
طبق Veracode تقریباً نه: مدلهای بزرگ ۵۳٪، متوسط ۵۱٪ و کوچک ۵۱٪ نرخ قبولی امنیتی داشتند. مدلهای استدلالی کمی بهتر بودند (۵۶٪ در برابر ۵۱٪).
بهترین ابزار برای بررسی امنیت کد AI چیست؟
ترکیبی از بازبینی انسانی و ابزارهای خودکار: اسکن ایستا با CodeQL یا Semgrep، اسکن رازها با Secret scanning یا Gitleaks و بررسی وابستگیها با Dependabot.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.