Django ORM فقط راهی برای حذف نوشتن SQL نیست؛ باید زمان اجرای QuerySet، معنای اتصالها و هزینه خواندن روابط را هم بشناسید. این آموزش از filter و عبارتها تا annotate، aggregate و رفع N+1 پیش میرود و بین نمونه آموزشی و نتیجه اندازهگیریشده تمایز میگذارد.
آخرین بهروزرسانی: ۱۷ آبان ۱۴۰۵ — منابع بررسیشده در این روز: صفحه دریافت جنگو، راهنماهای کوئری و تجمیع، مرجع QuerySet و عبارتها، بهینهسازی جنگو و Django Debug Toolbar.
⚡ پاسخ کوتاه
QuerySet توصیف پرسوجوی قابل ترکیب و معمولاً تنبل است. annotate معمولاً برای هر عضو مقدار میافزاید؛ aggregate خلاصه مجموعه میدهد. برای روابط تکمقداری select_related و برای مجموعههای مرتبط prefetch_related را بررسی کنید و نتیجه را با SQL، آزمون صحت و اندازهگیری تأیید کنید.
در جنگو، مدل ساختار داده و رفتار مرتبط را تعریف میکند و فیلدها به نگاشت اطلاعات کمک میکنند. برای آموزش پایه، مدلها در جنگو را بخوانید؛ اینجا وارد تعریف دوباره همه فیلدها نمیشویم. هدف ما استفاده درست از Django ORM برای انتخاب، ترکیب و خلاصهسازی داده است. مثالها با شاخه مستندات جنگو ۶.۱ نوشته شدهاند؛ صفحه دریافت رسمی در زمان بررسی، نسخه پایدار ۶.۱.۳ را نشان میداد.
برای داشتن مثال منسجم، یک اپلیکیشن کتابخانه کوچک فرض میکنیم. نویسنده و کتاب رابطه چندبهیک دارند و کتاب و برچسب چندبهچند هستند. کد زیر فقط بستر مثال است؛ بعد از ساخت اپلیکیشن و مهاجرتهای معمول، داده آزمایشی اضافه کنید. ساخت اپلیکیشن در جنگو این پیشنیاز را توضیح میدهد. کوئریها آموزشیاند؛ اجرای یکپارچه و اندازهگیری تعداد کوئری روی پایگاه داده برای این مقاله انجام نشده است.
from django.db import models

class Author(models.Model):
    name = models.CharField(max_length=120)

class Tag(models.Model):
    name = models.CharField(max_length=80, unique=True)

class Book(models.Model):
    title = models.CharField(max_length=200)
    author = models.ForeignKey(Author, on_delete=models.CASCADE, related_name="books")
    tags = models.ManyToManyField(Tag, related_name="books", blank=True)
    price = models.DecimalField(max_digits=12, decimal_places=2)
    published = models.BooleanField(default=False)
QuerySet چیست و تنبل بودن آن چه معنایی دارد؟
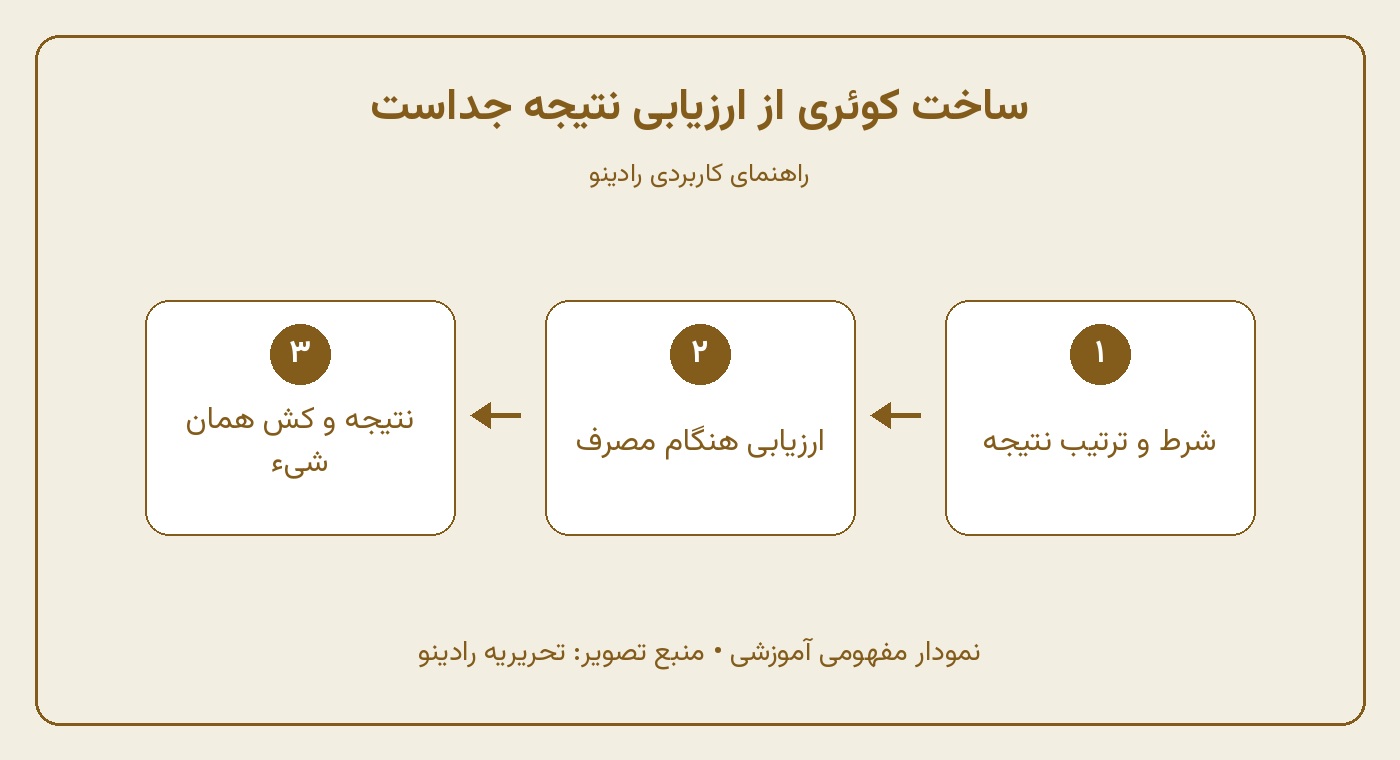
QuerySet توصیف یک پرسوجوی قابل ترکیب است، نه الزاماً فهرست آماده داده. معمولاً میتوانید شرط و ترتیب را زنجیره کنید و اجرای واقعی هنگام نیاز به نتیجه رخ میدهد. ساخت یک متغیر با filter بهتنهایی معمولاً داده را دریافت نمیکند؛ پیمایش، تبدیل به لیست و بعضی عملیات دیگر میتوانند باعث ارزیابی شوند. بنابراین هنگام عیبیابی، میان «ساخت کوئری» و «اجرای کوئری» تفاوت بگذارید.
در این نمونه، برش محدود به توصیف کوئری اضافه شده و تبدیل به لیست، ارزیابی را درخواست میکند. عدد بیست یک انتخاب آموزشی برای صفحه است، نه استاندارد کارایی. استفاده از گام در برش یا بعضی عملیات دیگر رفتار متفاوتی دارد. برای کار جدی، قواعد ارزیابی را در مرجع QuerySet بخوانید؛ تصور «هر خط دقیقاً یک کوئری» یا «هیچوقت تا حلقه اجرا نمیشود» هر دو گمراهکنندهاند.
کش نتیجه؛ فقط همان شیء، نه کش جهانی
پس از ارزیابی معمول کامل، QuerySet میتواند نتایج خود را نگه دارد و پیمایش دوباره همان شیء از آن استفاده کند. این به معنی کش عمومی همه پرسوجوهای مشابه نیست. ساخت QuerySet تازه یا اجرای یک روش متفاوت لزوماً از نتیجه قبلی استفاده نمیکند. همچنین داده ذخیرهشده میتواند با تغییرات همزمان قدیمی شود؛ اگر تازگی اهمیت دارد، قرارداد خواندن و تراکنش را متناسب با مسئله تعیین کنید.
برای پرسش «آیا چیزی هست؟» متد exists و برای شمارش صرف count اغلب مناسباند؛ اما اگر بلافاصله همان دادهها را هم میخوانید، ممکن است پرسوجوی جدا بیفایده باشد. انتخاب روش را از نیاز مصرفکننده شروع کنید. تنبل بودن یک ابزار است، نه تضمین خودکار بهینگی؛ با ارزیابیهای پراکنده میتوانید ناخواسته چند بار به پایگاه داده مراجعه کنید و تصور کنید هنوز فقط زنجیرهای ساده ساختهاید.
ساخت کوئری از ارزیابی نتیجه جداست؛ نمودار آموزشی، نه نتیجه بنچمارک. منبع تصویر: تحریریه رادینو
filter و exclude؛ نوشتن شرطهای قابل فهم
پارامترهای متداول در یک فراخوانی filter با رابطه منطقی «و» ترکیب میشوند. lookupها با دو زیرخط، نوع مقایسه یا عبور از رابطه را مشخص میکنند. برای مبلغ، در نمونه از مقدار اعشاری دقیق استفاده میکنیم. مبلغ زیر داده ساختگی برای آموزش شرط است، نه قیمت کتاب واقعی. در ورودی وب نیز نوع و دامنه داده را پیش از ساخت پرسوجو اعتبارسنجی کنید.
exclude صرفاً جایگزین ظاهری filter نیست؛ وقتی چند شرط یا رابطه چندمقداری دارید، دامنه نقیض و اتصال اهمیت پیدا میکند. برای روابط چندبهچند، چند filter زنجیرهای میتوانند با یک filter چندشرطی معنای متفاوت داشته باشند، چون ممکن است روی ردیفهای مرتبط متفاوت منطبق شوند. نتیجه مورد انتظار را با داده کوچک بنویسید و SQL و خروجی را کنترل کنید؛ حدس از روی ظاهر کد کافی نیست.
Q برای ترکیب شرط و F برای مقایسه فیلد
شیء Q امکان ترکیب صریح شرطها با «یا»، «و» و نقیض را فراهم میکند. F به مقدار فیلد در سمت پایگاه داده اشاره میکند و برای مقایسه یا محاسبه مناسب است. اینها عبارت کوئریاند، نه داده بارگیریشده در پایتون. پرانتزها را روشن بنویسید تا اولویت عملگرها معنای تجاری شرط را عوض نکند و بازبینی کد ساده بماند.
from django.db.models import Q, F

matches = Book.objects.filter(
    Q(title__icontains="python") | Q(title__icontains="django"),
    published=True,
)
Book.objects.filter(pk=book_id).update(price=F("price") + Decimal("1.00"))
آخرین خط نمونه بهروزرسانی آموزشی است و به شناسه معتبر نیاز دارد؛ آن را روی داده واقعی بدون مجوز اجرا نکنید. update مانند فراخوانی save روی تکتک نمونهها عمل نمیکند و مسیر متد save و سیگنالهای معمول آن را طی نمیکند. محاسبه سمت پایگاه داده میتواند بعضی رقابتهای خواندن و نوشتن را کم کند، اما جای قرارداد تراکنش، محدودیت داده و کنترل مجوز را نمیگیرد.
روابط ForeignKey و ManyToMany در کوئری
برای عبور از نویسنده به کتاب یا برعکس، از نام فیلد و نام رابطه برگشتی استفاده میکنید. در مثال ما books نام رابطه برگشتی نویسنده و برچسب است. قرارداد نامگذاری را در مدل واقعی خودتان بررسی کنید؛ کپی کردن نامهای این مقاله در پروژهای با نام متفاوت کار نمیکند. هنگام عبور از رابطه چندمقداری نیز احتمال تکثیر ردیف را جدی بگیرید.
distinct میتواند تکرار بعضی نتایج را رفع کند، اما دکمه همیشگی اصلاح هر کوئری نیست. مرتبسازی روی فیلدهای مرتبط، نوع پایگاه داده و هدف نتیجه میتوانند رفتار و هزینه را عوض کنند. ابتدا بدانید چرا ردیفها تکرار شدهاند؛ سپس تصمیم بگیرید یکتاسازی لازم است یا باید شکل پرسوجو اصلاح شود. پاک کردن علامت مشکل بدون فهم اتصال، ممکن است خطای گزارش را پنهان کند.
annotate و aggregate؛ مقدار برای هر ردیف یا خلاصه کل؟
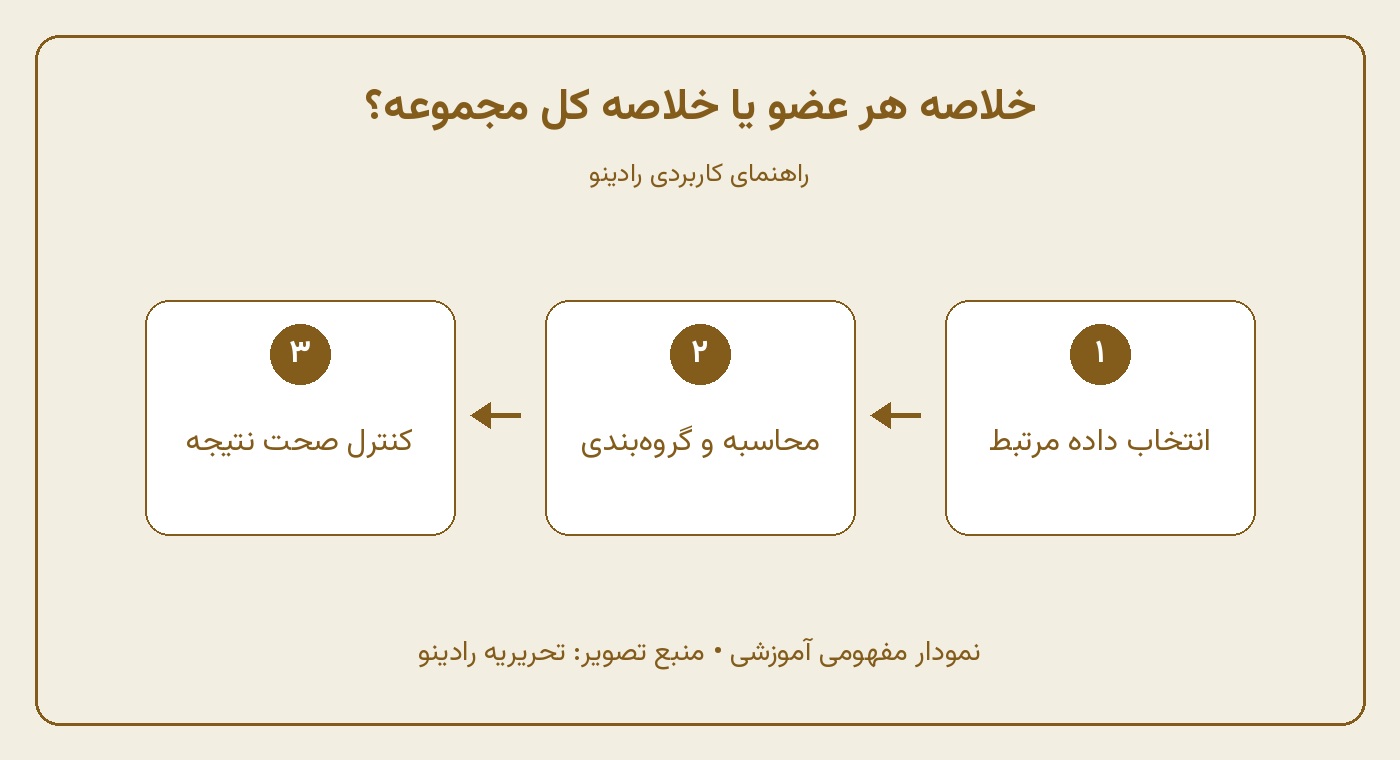
با annotate معمولاً برای هر عضو مجموعه، مقدار محاسبهشده یا خلاصه مرتبط اضافه میکنید و همچنان QuerySet قابل ترکیب دارید. aggregate نتیجه خلاصه را معمولاً به شکل دیکشنری برمیگرداند. برای مثال، شمار کتابهای منتشرشده هر نویسنده با میانگین قیمت کل کتابهای منتشرشده دو پرسش متفاوتاند. اولی برای هر نویسنده یک مقدار میخواهد، دومی یک خلاصه برای مجموعه انتخابشده.
نام مستعار روشن مثل published_count بهتر از نام مبهم است و در مصرف نتیجه خوانایی ایجاد میکند. درباره مجموعه خالی هم تصمیم بگیرید؛ بعضی توابع مانند میانگین ممکن است مقدار تهی بدهند، در حالی که Count رفتار شمارشی دارد. لایه نمایش نباید بیتوجه نتیجه تهی را به عدد ظاهراً معتبر تبدیل کند. معنی «داده نداریم» با «مقدار صفر است» یکسان نیست و در گزارشگیری اهمیت دارد.
ترتیب filter، annotate و values مهم است
این عملیات همیشه جابهجاپذیر نیستند. اگر اول مجموعه مرتبط را محدود کنید و بعد بشمارید، معنای شمارش با حالتی که ابتدا محاسبه و بعد بر نتیجه شرط میگذارید فرق میکند. همچنین values پیش از annotate میتواند گروهبندی را تعیین کند. گروهبندی فقط بر اساس نام نویسنده، دو نویسنده همنام را ممکن است در یک گروه جمع کند؛ شناسه را هم در نظر بگیرید.
وقتی چند رابطه چندمقداری را همزمان به گزارش وصل میکنید، ضرب ردیفهای اتصال ممکن است شمارشها را متورم کند. Count همراه distinct در بعضی سناریوها کمک میکند، اما راهحل عمومی همه توابع تجمیعی نیست. برای مجموع یا میانگین، شاید زیرکوئری یا بازطراحی لازم شود. مثال کوچک با نتیجه دستی و بررسی SQL، از هر ترفند عمومی مطمئنتر است و خطای خاموش آمار را زودتر آشکار میکند.
خلاصه هر عضو یا خلاصه کل مجموعه؟؛ نمودار آموزشی، نه نتیجه بنچمارک. منبع تصویر: تحریریه رادینو
مشکل N+1 چیست و چطور آن را تشخیص دهیم؟
فرض کنید کتابها را میخوانید و در حلقه نام نویسنده هر کدام را میگیرید. اگر رابطه از قبل دریافت نشده باشد، دسترسی به آن میتواند پرسوجوی اضافی ایجاد کند. این الگوی رشد مراجعه با تعداد آیتمها را معمولاً N+1 مینامیم. عدد دقیق به کش، مسیر ارزیابی و تنظیمات بارگیری وابسته است؛ اینجا تعداد اندازهگیریشدهای برای اجرای واقعی ادعا نمیکنیم، فقط منشأ الگو را توضیح میدهیم.
for book in Book.objects.filter(published=True):
    print(book.author.name)
مشکل ممکن است در ویو دیده نشود و در قالب یا سریالساز رخ دهد. متد یا ویژگیای که ظاهراً فقط داده نمایش میدهد، میتواند رابطه را بخواند و کوئری بسازد. با ابزار توسعه، گزارش کوئری و آزمون تعداد مراجعه، مسیر کامل درخواست را ببینید. ویوها و URLها در جنگو کمک میکند محل دریافت داده را از نمایش و مسیر جدا کنید، اما برای تشخیص باید کل مسیر ارزیابی را بررسی کرد.
select_related؛ مناسب رابطه تکمقداری
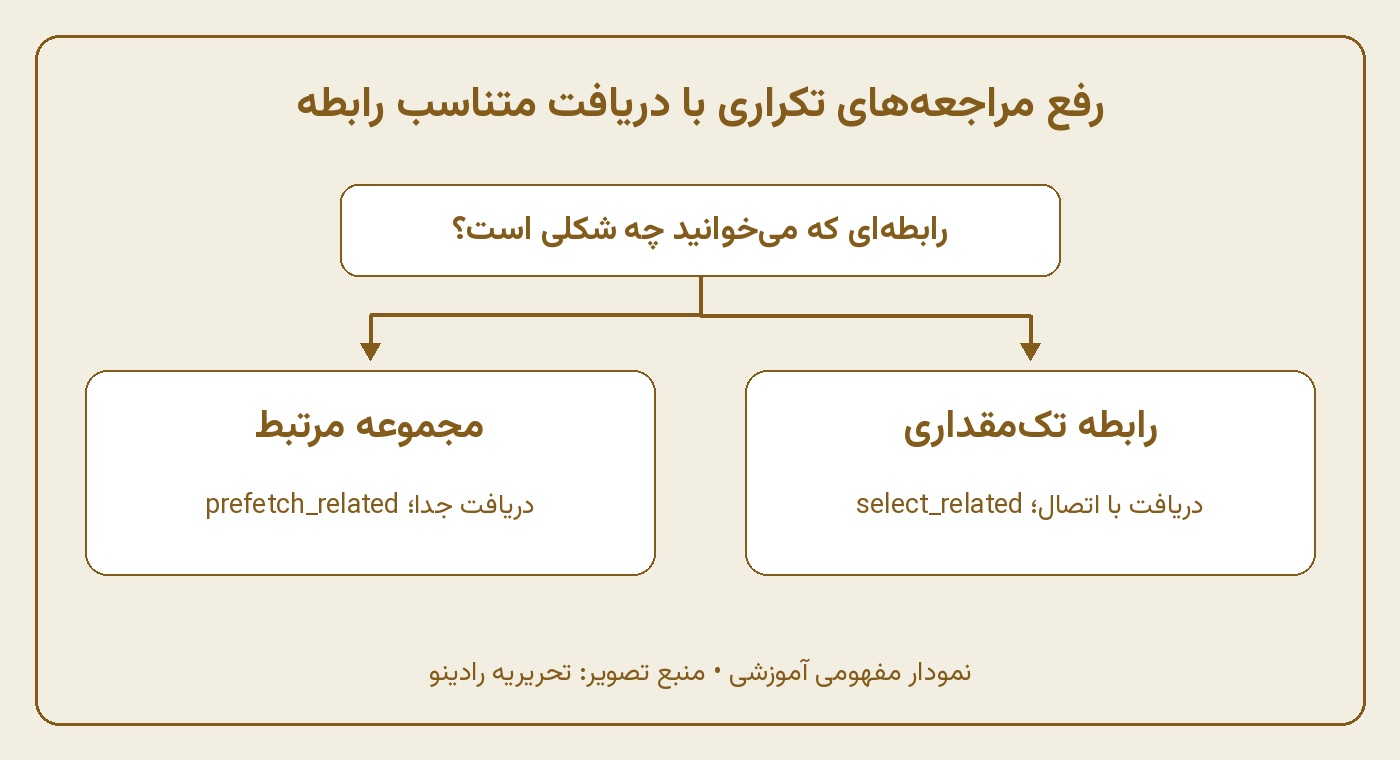
این روش برای رابطههایی مانند ForeignKey و OneToOne با اتصال SQL، داده مرتبط را در همان دریافت اصلی میآورد. در مثال ما، نویسنده برای هر کتاب یک رابطه تکمقداری است. این کار میتواند مراجعههای جداگانه را کاهش دهد، اما دریافت همه رابطهها بدون نیاز، اندازه نتیجه را زیاد میکند. فقط مسیرهای لازم را مشخص کنید و هزینه کوئری را در داده واقعی بسنجید.
books = Book.objects.filter(published=True).select_related("author")
for book in books:
    print(book.title, book.author.name)
prefetch_related؛ مناسب مجموعههای مرتبط
برای روابط چندبهچند یا سمت چندتایی رابطه برگشتی، معمولاً prefetch_related مناسب است. پرسوجوهای جدا میزند و اتصال نتایج را در پایتون انجام میدهد. این روش هزینه حافظه و انتقال داده دارد و فقط به خاطر کم شدن تعداد کوئری نباید آن را نامحدود استفاده کنید. اگر داخل حلقه شرط تازهای روی مدیر رابطه بگذارید، ممکن است از نتیجه پیشدریافتشده استفاده نکنید و دوباره کوئری بسازید.
books = Book.objects.select_related("author").prefetch_related("tags")
for book in books:
    names = [tag.name for tag in book.tags.all()]
روش
مسیر مناسب متداول
نکته مهم
select_related
ForeignKey و OneToOne
اتصال SQL؛ مراقب اندازه ردیفها باشید
prefetch_related
ManyToMany و رابطه برگشتی چندتایی
دریافت جدا و ترکیب در پایتون؛ هزینه حافظه دارد
Prefetch با to_attr
زیرمجموعه فیلترشده رابطه
نتیجه فهرست جداست؛ مدیر رابطه کامل را تغییر نمیدهد
Prefetch سفارشی و to_attr
وقتی فقط زیرمجموعه مشخصی از رابطه را لازم دارید، میتوانید QuerySet پیشدریافت را تعیین کنید و نتیجه را در ویژگی جدا قرار دهید. در نمونه زیر، نویسندهها با کتابهای منتشرشده مرتبط دریافت میشوند و مصرفکننده مستقیماً همان فهرست را میخواند. این کار معنای مجموعه فیلترشده را واضح میکند؛ آن را با مدیر کامل رابطه اشتباه نگیرید و انتظار نداشته باشید هر فیلتر بعدی روی مدیر از آن استفاده کند.
from django.db.models import Prefetch

authors = Author.objects.prefetch_related(
    Prefetch(
        "books",
        queryset=Book.objects.filter(published=True).order_by("pk"),
        to_attr="published_books",
    )
)
for author in authors:
    for book in author.published_books:
        print(book.title)
بهینهسازی؛ اول اندازهگیری، بعد تغییر
از زمان پاسخ و کوئریهای تکراری شروع کنید. Django Debug Toolbar در محیط توسعه برای دیدن پرسوجوها مفید است؛ آن را بدون توجه به راهنمای امنیت و پیکربندی در محیط عمومی فعال نکنید. explain نیز برنامه اجرای کوئری را نشان میدهد، اما قالب و گزینههای آن به پایگاه داده وابسته است. انتخاب ایندکس باید از الگوی فیلتر، مرتبسازی و حجم داده بیاید، نه از اضافه کردن ایندکس به همه فیلدها.
اگر فقط چند ستون لازم دارید، values یا values_list میتواند ساخت نمونههای کامل را حذف کند. only و defer هم ابزارند، ولی دسترسی بعدی به فیلد عقبافتاده ممکن است دریافت دیگری بسازد. صفحهبندی، محدود کردن نتیجه و حذف محاسبه تکراری اغلب از تغییرهای نمایشی مفیدترند. در شاخه ۶.۱ گزینههای تازهای مانند حالت دریافت FETCH_PEERS هم مستند شدهاند؛ بااینحال بارگیری صریح رابطه و سنجش مسیر واقعی همچنان مهم است.
کش، تراکنش و آزمون رگرسیون
کش کردن گزارش سنگین میتواند مفید باشد، اما مدت اعتبار و روش ابطال آن باید روشن باشد. کش نادرست سرعت را زیاد میکند و صحت را کم؛ این معامله همیشه پذیرفتنی نیست. برای عملیات حساس، تراکنش و محدودیت پایگاه داده را مطابق نیاز طراحی کنید. بعد از اصلاح N+1 نیز یک آزمون رگرسیون با داده مرتبط کافی بسازید تا تغییر قالب یا سریالساز مشکل را بیصدا برنگرداند.
رفع مراجعههای تکراری با دریافت متناسب رابطه؛ نمودار آموزشی، نه نتیجه بنچمارک. منبع تصویر: تحریریه رادینو
چه زمانی raw SQL یا راهکار دیگری لازم است؟
اگر پرسوجوی تخصصی، قابلیت خاص پایگاه داده یا محدودیت واقعی ORM دارید، SQL خام میتواند انتخاب آگاهانه باشد. اول امکانات عبارتها، زیرکوئری و ابزارهای ORM را بررسی کنید. سپس ورودی را با پارامترهای امن منتقل کنید؛ الحاق رشته ورودی کاربر به SQL خطرناک است. قابلیت حمل، نگهداری و آزمون را هم بسنجید. سخت بودن خواندن یک زنجیره طولانی همیشه نشانه نیاز به SQL خام نیست؛ شاید مسئله نیازمند سادهسازی طراحی باشد.
برای قرار دادن ORM در معماری برنامه، ساختار MVT جنگو و مقایسه جنگو و FastAPI را بخوانید. انتخاب فریمورک بهتنهایی مشکل داده را حل نمیکند؛ یک API ساده هم میتواند N+1 داشته باشد. اگر از پرامپتهای کدنویسی برای پیشنهاد بهینهسازی استفاده میکنید، مدلها، SQL بیاطلاعات حساس و نتیجه مورد انتظار را بدهید و هر پیشنهاد را با آزمون مستقل تأیید کنید.
سؤالات متداول
select_related و prefetch_related چه فرقی دارند؟
اولی معمولاً روابط تکمقداری را با اتصال SQL میآورد؛ دومی مجموعههای مرتبط را با دریافت جدا و ترکیب در پایتون آماده میکند. میتوان آنها را برای مسیرهای متفاوت ترکیب کرد. تعداد کوئری تنها معیار نیست؛ حجم ردیف، حافظه و نیاز نمایش را هم بسنجید.
مشکل N+1 را چطور پیدا کنیم؟
گزارش کوئری درخواست کامل را ببینید و دنبال پرسوجوهای مشابه با شناسههای متفاوت بگردید. قالب و سریالساز را هم بررسی کنید. بعد از اصلاح، با داده نمونه و آزمون تعداد مراجعه مطمئن شوید تغییر بعدی همان مشکل را برنمیگرداند.
annotate با aggregate چه فرقی دارد؟
annotate برای هر عضو مجموعه مقدار اضافه میکند و معمولاً زنجیره QuerySet را ادامه میدهد؛ aggregate خلاصه مجموعه را برمیگرداند. ترتیب فیلتر و محاسبه و گروهبندی اهمیت دارد. برای گزارش حساس، نتیجه کوچک را دستی کنترل کنید و SQL تولیدشده را ببینید.
QuerySet تنبل یعنی چه؟
یعنی ساخت و ترکیب پرسوجو معمولاً از دریافت نتیجه جداست و داده هنگام ارزیابی خوانده میشود. برخی عملیات خودشان ارزیابی میکنند. کش همان QuerySet هم با کش عمومی یا تازگی همیشگی داده تفاوت دارد؛ رفتار متد مصرفکننده را بررسی کنید.
برای مصاحبه ORM چه چیزهایی مهماند؟
از تعریف کوتاه عبور کنید و یک مثال واقعی از فیلتر، رابطه، تجمیع و رفع N+1 توضیح دهید. پرسشهای ۲۲ و ۴۰ سؤالات مصاحبه جنگو نقطه شروعاند و آمادگی مصاحبه جنگو مرور گستردهتری دارد. برای پروژه واقعی هم خدمات توسعه وبسایت رادینو را با نیاز داده و معیار پذیرش روشن بررسی کنید.
چه زمانی SQL خام را به ORM ترجیح دهیم؟
وقتی نیاز مشخصی دارید که با ابزارهای ORM به شکلی روشن و قابل نگهداری بیان نمیشود یا قابلیت تخصصی پایگاه داده لازم است، آن را بررسی کنید. تصمیم را با SQL واقعی، برنامه اجرا و آزمون صحت پشتیبانی کنید. ورودی را پارامتری منتقل کنید و از ساخت SQL با چسباندن متن کاربر دور بمانید. همچنین هزینه وابستگی به پایگاه داده و انتقال دانش به تیم را حساب کنید؛ کوتاهتر شدن یک تابع تنها معیار نیست.
چطور برای یک بهینهسازی معیار پذیرش بنویسیم؟
یک درخواست مشخص، اندازه داده نمونه، روابط مورد استفاده و نتیجه مورد انتظار را ثبت کنید. سپس علاوه بر محدود کردن مراجعههای تکراری، درست بودن تعداد ردیفها و محاسبهها را بررسی کنید. ممکن است کوئری سریعتر شود اما به علت اتصال چندمقداری، جمع مبلغ اشتباه باشد. آزمون کارایی بدون آزمون صحت کافی نیست. برای مقایسه زمان هم محیط، کش و بار همزمان را ثابت یا مستند نگه دارید تا عددها قابل تفسیر باشند.
در بازبینی کد، مسیر مصرف داده را تا انتها دنبال کنید: آیا قالب رابطهای را میخواند که ویو پیشبینی نکرده، آیا سریالساز شرط جدیدی میزند و آیا صفحهبندی بعد از بارگیری کامل انجام شده است؟ این پرسشها اغلب از جابهجا کردن بیهدف متدها مفیدترند. هدف بهینهسازی جنگو فقط کم کردن تعداد کوئری نیست؛ باید زمان، حافظه، فشار پایگاه داده و سادگی نگهداری را با هم و بر اساس نیاز واقعی محصول بسنجید.





نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.