آرایه در جاوا اندازه ثابت دارد، اما دادههای برنامه واقعی مدام بزرگ و کوچک میشوند. Collections Framework با ArrayList، HashMap، HashSet و ArrayDeque این مشکل را حل میکند. در این آموزش با مثالهایی که با JDK 25 اجرا کردهایم، کار با هر کدام، تفاوتها، انتخاب درست و اشتباهات رایج را یاد میگیرید.
آخرین بهروزرسانی: ۲۰ آبان ۱۴۰۵ — منابع بررسیشده در این روز: مستندات API کلاسهای ArrayList، LinkedList، HashMap، HashSet، ArrayDeque، List، Map و ConcurrentModificationException در JDK 25، نمای کلی Collections Framework، آموزش Collections در dev.java، JEP 431 و صفحه پروژه JDK.
⚡ پاسخ کوتاه
ArrayList لیستی مرتب با اندازه خودکار است که دسترسی با اندیس در آن سریع است و برای بیشتر کارها انتخاب پیشفرض است. HashMap داده را به شکل کلید و مقدار نگه میدارد و جستوجو با کلید در آن معمولاً زمان ثابت دارد، اما ترتیب را تضمین نمیکند. برای حذف تکراریها HashSet و برای صف و پشته ArrayDeque را انتخاب کنید. Collections فقط شیء نگه میدارند، پس بهجای int از Integer استفاده کنید.
آرایه در جاوا اندازه ثابتی دارد. وقتی مینویسید new int[3]، تا آخر عمر آن آرایه فقط سه خانه دارید. اگر بخواهید عضو چهارم اضافه کنید، باید آرایه بزرگتری بسازید و همه اعضا را دستی در آن کپی کنید. حذف یک عضو از وسط هم یعنی جابهجا کردن بقیه اعضا با حلقه. این محدودیتها را در آرایهها در جاوا و مقداردهی اولیه آرایه دیدهایم. در برنامههای واقعی تعداد دادهها از قبل معلوم نیست: سبد خرید کاربر، فهرست دانشجویان یک کلاس یا موجودی انبار مدام بزرگ و کوچک میشوند. اینجا Collections Framework به کمک میآید؛ مجموعهای از رابطها (Interface) و کلاسهای آماده در بسته java.util که ساختارهای داده رایج مثل لیست، مجموعه، صف و نقشه را با متدهای آماده در اختیارتان میگذارد. طبق مستندات رسمی جاوا، این فریمورک یک معماری یکپارچه برای نگهداری و کار با گروهی از اشیاست که پیادهسازیهایش جدا از رابطها تعریف شدهاند. در این آموزش دو کلاسی را که بیشترین استفاده را دارند، یعنی ArrayList و HashMap، با جزئیات یاد میگیریم و بعد سراغ HashSet، ArrayDeque و LinkedList میرویم. همه مثالها را با JDK 25، آخرین نسخه پشتیبانی بلندمدت، اجرا کردهایم و خروجیهایی که میبینید واقعیاند.
نقشه Collections Framework؛ List، Set، Queue و Map
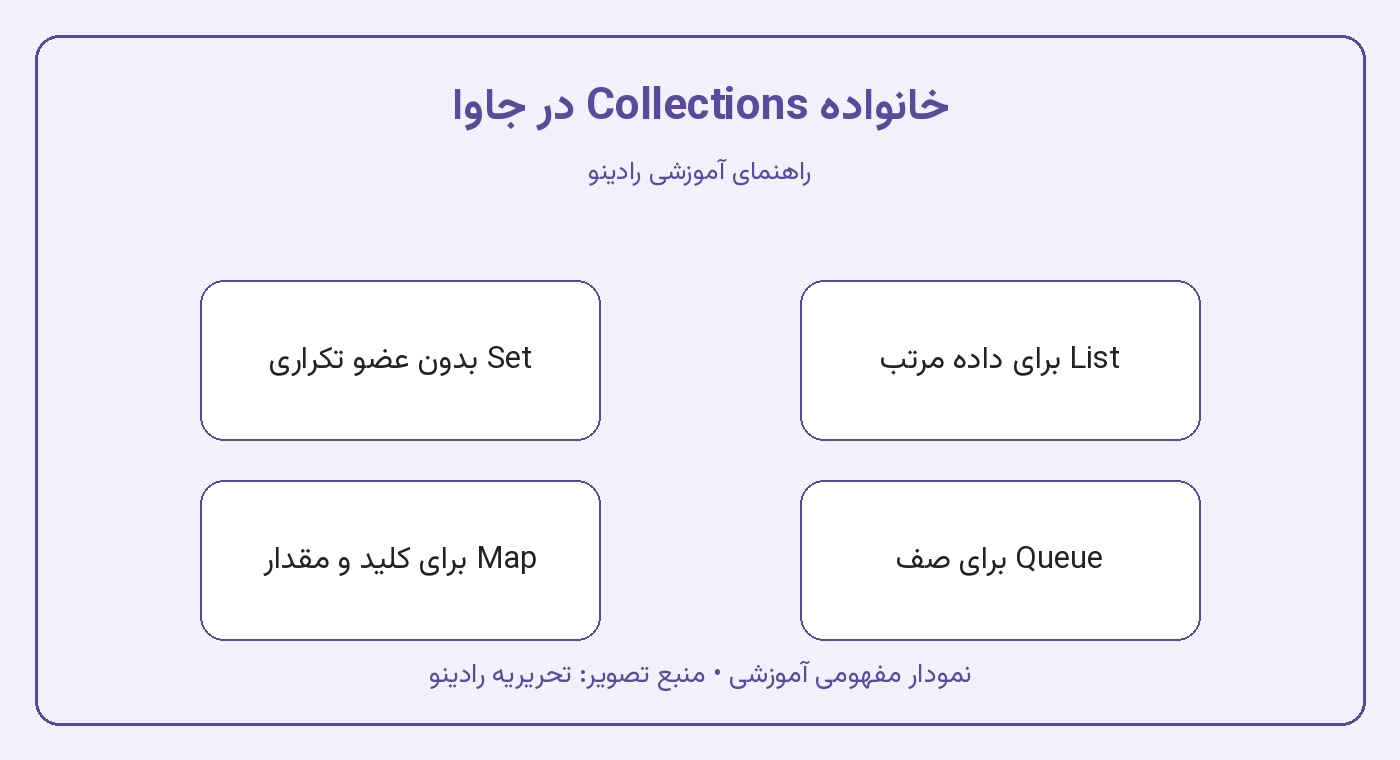
قبل از کد، بهتر است تصویر کلی را ببینیم. در بالای سلسلهمراتب رابط Collection قرار دارد که سه زیررابط اصلی دارد: List مجموعهای مرتب است که عضو تکراری را میپذیرد و با شماره خانه (اندیس) به اعضا دسترسی میدهد. مهمترین پیادهسازیاش ArrayList است. Set عضو تکراری را نمیپذیرد. HashSet پرکاربردترین پیادهسازی آن است. Queue و زیررابطش Deque برای صف و پشتهاند و ArrayDeque پیادهسازی پیشنهادی آنهاست. Map خانواده جداگانهای است و از Collection ارث نمیبرد. Map داده را به شکل جفت کلید و مقدار نگه میدارد؛ مثل دفترچه تلفن که با نام، شماره را پیدا میکنید. HashMap معروفترین پیادهسازی آن است.
خانواده Collections در جاوا؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
یک عادت خوب از همین ابتدا: متغیر را با نوع رابط تعریف کنید و پیادهسازی را فقط در new بیاورید؛ یعنی List<String> courses = new ArrayList<>() بهجای ArrayList<String> courses. اینطوری اگر روزی خواستید پیادهسازی را عوض کنید، فقط یک خط تغییر میکند. فلسفه این کار را در تفاوت Interface و Abstract Class در جاوا توضیح دادهایم.
ArrayList در جاوا؛ آرایهای که خودش بزرگ میشود
ArrayList در عمل یک آرایه معمولی در پشت صحنه دارد. وقتی جای آن پر شود، خودش آرایه بزرگتری میسازد و اعضا را منتقل میکند. شما فقط add میکنید و نگران اندازه نیستید. مستندات API تأکید میکند که get و set و size در زمان ثابت اجرا میشوند و add هم بهطور میانگین زمان ثابت دارد.
خط به خط ببینیم چه شد. add بدون اندیس عضو را به انتهای لیست اضافه میکند و add(1, "Git") آن را در خانه ۱ میگذارد و بقیه را یک خانه جلو میبرد. get(0) اولین عضو را برمیگرداند؛ اندیسها مثل آرایه از صفر شروع میشوند. set(3, ...) خانه ۳ را که SQL بود، با PostgreSQL جایگزین کرد. remove("Python") عضوی با این مقدار را پیدا و حذف کرد و contains بررسی کرد Git در لیست هست یا نه. دو متد آخر یعنی getFirst و getLast از جاوا ۲۱ با معرفی Sequenced Collections در JEP 431 اضافه شدهاند. قبلاً برای آخرین عضو باید get(list.size() - 1) مینوشتید. اگر روی نسخههای قدیمیتر جاوا کار میکنید، این دو متد را ندارید. برای پیمایش لیست، حلقه for-each سادهترین راه است. انواع حلقه و جای مناسب هر کدام را در حلقهها در جاوا مفصل گفتهایم.
چرا List<int> نداریم؟ Wrapper و Autoboxing
Collections فقط شیء نگه میدارند، نه نوعهای اولیه مثل int و double. برای همین بهجای List<int> باید List<Integer> بنویسید. جاوا تبدیل int به Integer و برعکس را خودکار انجام میدهد که به آن Autoboxing میگویند. این راحتی یک دام معروف دارد:
import java.util.ArrayList;
import java.util.List;

public class C2 {
    public static void main(String[] args) {
        List<Integer> nums = new ArrayList<>(List.of(10, 20, 30));
        nums.remove(1);
        System.out.println(nums);
        nums.remove(Integer.valueOf(10));
        System.out.println(nums);

        List<String> fixed = List.of("a", "b");
        try {
            fixed.add("c");
        } catch (UnsupportedOperationException e) {
            System.out.println("List.of is unmodifiable");
        }
    }
}
// output:
// [10, 30]
// [30]
// List.of is unmodifiable
خیلیها انتظار دارند nums.remove(1) عدد ۱ را حذف کند، اما List دو متد remove دارد: remove(int index) که بر اساس شماره خانه حذف میکند و remove(Object o) که بر اساس مقدار. چون ۱ یک int است، جاوا نسخه اندیس را انتخاب کرد و خانه ۱ یعنی عدد ۲۰ حذف شد. برای حذف بر اساس مقدار باید صریحاً Integer.valueOf(10) بدهید. بخش دوم مثال هم نکته مهمی دارد: لیستی که با List.of ساخته میشود، تغییرناپذیر است و add روی آن UnsupportedOperationException میدهد. برای همین در خط اول، List.of را داخل new ArrayList<>() گذاشتیم تا یک لیست قابل تغییر بسازیم. درباره این نوع خطاها در آموزش مدیریت خطا در جاوا بیشتر خواندهاید.
HashMap در جاوا؛ جستوجوی سریع با کلید
فرض کنید موجودی انبار را نگه میدارید و میخواهید با نام کالا، تعدادش را بلافاصله پیدا کنید. با لیست باید همه اعضا را یکییکی بگردید، اما HashMap با کلید مستقیماً به مقدار میرسد. طبق مستندات API، اگر تابع هش کلیدها را خوب پخش کند، get و put در زمان ثابت انجام میشوند.
import java.util.HashMap;
import java.util.Map;
import java.util.TreeMap;

public class C3 {
    public static void main(String[] args) {
        Map<String, Integer> stock = new HashMap<>();
        stock.put("pen", 40);
        stock.put("notebook", 12);
        stock.put("pen", 35);
        System.out.println(stock.get("pen") + " " + stock.get("eraser"));
        System.out.println(stock.getOrDefault("eraser", 0));
        stock.merge("notebook", 5, Integer::sum);
        stock.putIfAbsent("eraser", 8);
        System.out.println(new TreeMap<>(stock));
        for (Map.Entry<String, Integer> e : stock.entrySet()) {
            if (e.getValue() < 20) System.out.println("low: " + e.getKey());
        }

        String text = "java is fun and java is fast";
        Map<String, Integer> freq = new TreeMap<>();
        for (String w : text.split(" ")) {
            freq.merge(w, 1, Integer::sum);
        }
        System.out.println(freq);
    }
}
// output:
// 35 null
// 0
// {eraser=8, notebook=17, pen=35}
// low: eraser
// low: notebook
// {and=1, fast=1, fun=1, is=2, java=2}
put دوم برای کلید pen مقدار قبلی را جایگزین کرد؛ در Map هر کلید فقط یک بار وجود دارد. get برای کلیدی که نیست null برمیگرداند و همین null منشأ خیلی از NullPointerExceptionهاست؛ getOrDefault این مشکل را با یک مقدار پیشفرض حل میکند. merge اگر کلید باشد، مقدار جدید را با تابع دادهشده با مقدار قبلی ترکیب میکند (اینجا ۱۲ + ۵ = ۱۷) و اگر نباشد، همان مقدار را میگذارد. putIfAbsent فقط وقتی مقدار را میگذارد که کلید وجود نداشته باشد. بخش آخر، الگوی کلاسیک شمارش کلمات است: با merge(w, 1, Integer::sum) هر کلمه یک بار شمرده میشود. این الگو در مصاحبههای برنامهنویسی هم زیاد پرسیده میشود. برای جدا کردن کلمات از متد split کلاس String استفاده کردیم که در کلاس String در جاوا توضیح دادهایم.
ترتیب در HashMap تضمین نمیشود
مستندات HashMap صریحاً میگوید هیچ تضمینی درباره ترتیب اعضا نمیدهد و حتی ممکن است ترتیب با گذشت زمان تغییر کند. در خروجی بالا دو خط low به ترتیب eraser و notebook آمدند، اما روی سیستم یا نسخه دیگری از جاوا ممکن است ترتیب فرق کند. برای همین برای چاپ کل نقشه از TreeMap استفاده کردیم که کلیدها را مرتب نگه میدارد. اگر ترتیب درج برایتان مهم است، LinkedHashMap را به کار ببرید.
کلید HashMap باید equals و hashCode درست داشته باشد
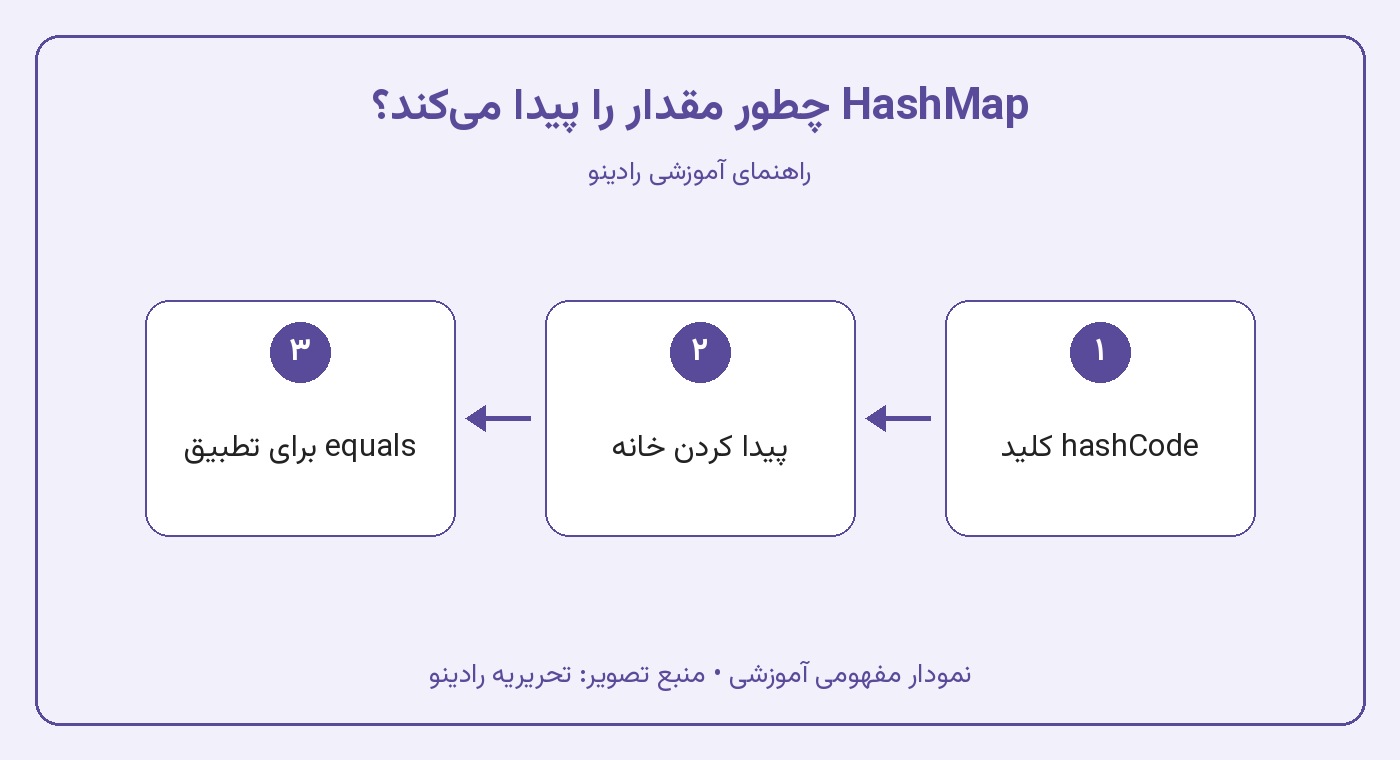
HashMap برای پیدا کردن کلید، اول hashCode و بعد equals را صدا میزند. String و Integer این دو متد را درست پیاده کردهاند. اما اگر کلاس خودتان را کلید بگذارید و این دو را بازنویسی نکنید، دو شیء با محتوای یکسان، دو کلید متفاوت حساب میشوند. سادهترین راه حل استفاده از record است که equals و hashCode را بر اساس فیلدها خودکار میسازد. درباره record در کلاس و شیء در جاوا نوشتهایم. کلیدها را هم بعد از گذاشتن در Map تغییر ندهید.
HashMap چطور مقدار را پیدا میکند؟؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
HashSet، ArrayDeque و LinkedList
علاوه بر ArrayList و HashMap، سه کلاس دیگر هم در کارهای روزمره زیاد به کار میآیند:
import java.util.*;

public class C4 {
    public static void main(String[] args) {
        Set<String> tags = new HashSet<>(List.of("java", "oop", "java", "jvm"));
        System.out.println(tags.size() + " " + tags.contains("oop"));
        System.out.println(new LinkedHashSet<>(List.of("c", "a", "b", "a")));
        System.out.println(new TreeSet<>(List.of("c", "a", "b", "a")));

        Deque<String> queue = new ArrayDeque<>();
        queue.offer("order-1");
        queue.offer("order-2");
        queue.push("urgent");
        System.out.println(queue.poll() + " then " + queue.poll());

        LinkedList<Integer> linked = new LinkedList<>(List.of(1, 2, 3));
        linked.addFirst(0);
        linked.removeLast();
        System.out.println(linked);
    }
}
// output:
// 3 true
// [c, a, b]
// [a, b, c]
// urgent then order-1
// [0, 1, 2]
HashSet تکراریها را حذف کرد و از چهار عضو، سه عضو ماند. contains در HashSet مثل HashMap سریع است؛ برای همین وقتی فقط میخواهید بدانید چیزی «هست یا نیست»، Set از List بهتر است. LinkedHashSet ترتیب درج را حفظ کرد و TreeSet اعضا را مرتب کرد. ArrayDeque هم صف است و هم پشته: offer به انتهای صف اضافه میکند، push به ابتدای آن و poll از ابتدا برمیدارد. برای همین urgent که با push آمد، زودتر از order-1 بیرون آمد. مستندات جاوا میگوید ArrayDeque وقتی بهعنوان پشته استفاده شود احتمالاً از Stack سریعتر است و وقتی صف باشد از LinkedList. LinkedList لیست پیوندی دوطرفه است. افزودن و حذف از دو سر آن سریع است، اما دسترسی به عضو وسط با get(i) باید از یک سر لیست شروع به حرکت کند.
کلاس
ترتیب
تکراری
نقطه قوت
مناسب برای
ArrayList
ترتیب درج
بله
get و set با اندیس در زمان ثابت
بیشتر لیستهای معمولی
LinkedList
ترتیب درج
بله
افزودن و حذف در دو سر
موارد خاص و اندازهگیریشده
HashSet
بدون تضمین
خیر
contains سریع
حذف تکراری و بررسی عضویت
LinkedHashSet
ترتیب درج
خیر
حفظ ترتیب و حذف تکراری
تکراریزدایی با ترتیب
TreeSet
مرتب
خیر
اعضای مرتب
فهرست مرتب بدون تکرار
ArrayDeque
دو سر صف
بله
صف و پشته سریع
صف کار و پشته
HashMap
بدون تضمین
کلید یکتا
get و put با کلید
جستوجو با کلید و شمارش
TreeMap
کلیدهای مرتب
کلید یکتا
کلیدهای مرتب
گزارش مرتب
ArrayList یا LinkedList؛ کدام را انتخاب کنیم؟
تصور رایج این است که LinkedList برای افزودن و حذف همیشه سریعتر است. واقعیت این است که فقط افزودن و حذف در دو سر لیست یا از طریق یک Iterator که جای عنصر را دارد سریع است. برای افزودن در وسط، LinkedList اول باید تا آن نقطه حرکت کند. ما یک آزمایش ساده انجام دادیم: هر دو لیست را با صد هزار عدد پر کردیم و هر صدمین عضو را با get خواندیم.
// ArrayList get: 0.21 ms, LinkedList get: 47.67 ms
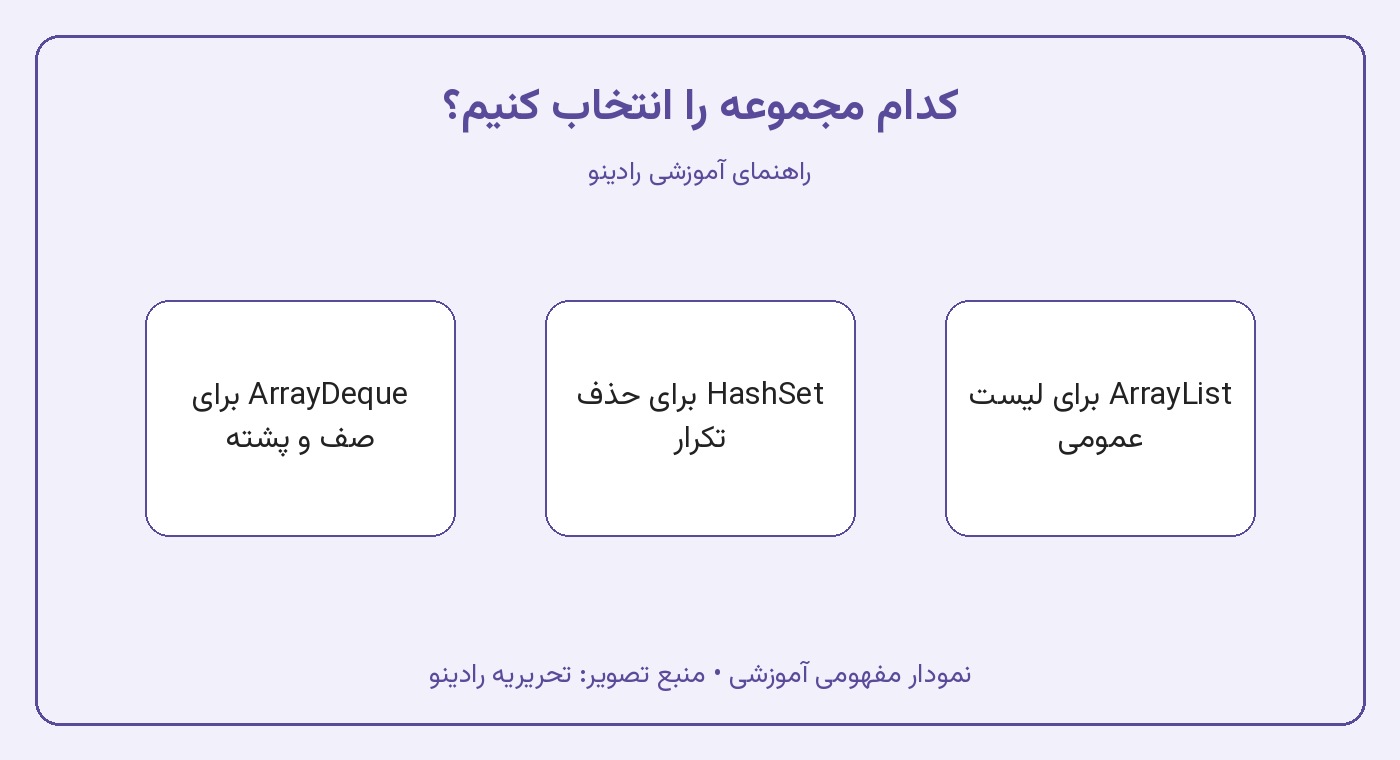
این یک اجرای ساده روی سیستم ما بود و عدد دقیق آن روی سیستم شما فرق میکند؛ گرم شدن JVM و جزئیات دیگر روی نتیجه اثر دارند. برای اندازهگیری دقیق باید از ابزاری مثل JMH استفاده کرد. اما تفاوت چندصدبرابری در یک اجرا، بهخوبی نشان میدهد چرا get روی LinkedList کند است. جمعبندی عملی: در اکثر موارد ArrayList را انتخاب کنید. اگر صف یا پشته لازم دارید، ArrayDeque. LinkedList را فقط وقتی به کار ببرید که دلیل مشخص و اندازهگیریشده داشته باشید.
مرتبسازی، حذف امن و گروهبندی
در این مثال با یک record دانشجو، سه کار رایج را انجام میدهیم: مرتبسازی، حذف عضوها در حین پیمایش و گروهبندی در Map:
import java.util.*;

public class C5 {
    record Student(String name, double gpa) { }

    public static void main(String[] args) {
        List<Student> list = new ArrayList<>(List.of(
            new Student("Sara", 18.5), new Student("Reza", 14.0), new Student("Mina", 16.25)));
        list.sort(Comparator.comparingDouble(Student::gpa).reversed());
        System.out.println(list.get(0).name());

        try {
            for (Student s : list) {
                if (s.gpa() < 15) list.remove(s);
            }
        } catch (ConcurrentModificationException e) {
            System.out.println("ConcurrentModificationException");
        }
        list.removeIf(s -> s.gpa() < 15);
        System.out.println(list.size());

        Map<Boolean, List<String>> passed = new HashMap<>();
        for (Student s : list) {
            passed.computeIfAbsent(s.gpa() >= 17, k -> new ArrayList<>()).add(s.name());
        }
        System.out.println(passed);
    }
}
// output:
// Sara
// ConcurrentModificationException
// 2
// {false=[Mina], true=[Sara]}
Comparator.comparingDouble لیست را بر اساس معدل مرتب کرد و reversed ترتیب را نزولی کرد؛ پس Sara با معدل ۱۸٫۵ اول قرار گرفت. بخش دوم، اشتباه بسیار رایجی را نشان میدهد: حذف عضو با list.remove داخل حلقه for-each. پیمایشگر لیست متوجه میشود لیست زیر دستش تغییر کرده و ConcurrentModificationException میدهد. مستندات جاوا توضیح میدهد این رفتار «fail-fast» است و فقط برای پیدا کردن باگ طراحی شده، نه برای اینکه برنامه به آن تکیه کند. راه درست، removeIf است که شرط را میگیرد و حذف را امن انجام میدهد؛ یا استفاده مستقیم از Iterator و متد remove خودش. بخش سوم، computeIfAbsent را نشان میدهد: اگر کلید وجود نداشت، لیست تازهای میسازد و برمیگرداند و بعد نام دانشجو به آن اضافه میشود. این الگو برای گروهبندی، کد را از چند خط if به یک خط کاهش میدهد. اگر با Stream API آشنا شوید، Collectors.groupingBy همین کار را به شکل دیگری انجام میدهد.
کدام مجموعه را انتخاب کنیم؟؛ نمودار آموزشی. منبع تصویر: تحریریه رادینو
اشتباهات رایج کار با Collections
اشتباه
نتیجه
راه درست
حذف با list.remove در for-each
ConcurrentModificationException
removeIf یا Iterator.remove
nums.remove(1) برای حذف مقدار ۱
عضو خانه ۱ حذف میشود
remove(Integer.valueOf(1))
add روی List.of
UnsupportedOperationException
new ArrayList<>(List.of(...))
تکیه بر ترتیب HashMap
ترتیب در اجرای دیگر فرق میکند
LinkedHashMap یا TreeMap
کلید بدون equals و hashCode
دو کلید با محتوای یکسان جدا شمرده میشوند
record یا بازنویسی هر دو متد
get روی کلید ناموجود و استفاده مستقیم
null و NullPointerException
getOrDefault
LinkedList برای دسترسی با اندیس
کندی get(i)
ArrayList
یک نکته دیگر درباره چندنخی: ArrayList و HashMap همگامسازیشده نیستند و اگر چند نخ همزمان آنها را تغییر دهند، نتیجه قابل پیشبینی نیست. برای این حالت، کلاسهای بسته java.util.concurrent مثل ConcurrentHashMap ساخته شدهاند. برای برنامههای تکنخی معمولی نیازی به آنها ندارید.
Collections در مصاحبه و پروژه واقعی
سؤالهایی مثل «تفاوت ArrayList و LinkedList»، «HashMap چطور کار میکند» و «چرا باید equals و hashCode را با هم بازنویسی کرد» از پرتکرارترین سؤالهای مصاحبه جاوا هستند. اگر مثالهای این مقاله را خودتان اجرا کنید و تغییر دهید، پاسخ این سؤالها را با تجربه میدانید، نه با حفظ کردن. در پروژههای واقعی هم تقریباً هر لایهای با Collections کار میکند: نتیجه کوئری پایگاه داده معمولاً به شکل List برمیگردد، تنظیمات برنامه در Map نگه داشته میشوند و برای حذف تکراریها از Set استفاده میشود. وقتی داده از ورودی کاربر یا فایل میآید، مدیریت خطا هم اهمیت پیدا میکند که در مدیریت خطا در جاوا توضیح دادهایم. اگر برای ساخت نرمافزار سفارشی به تیم توسعه نیاز دارید، خدمات توسعه نرمافزار رادینو را ببینید.
تمرین Collections در جاوا
تمرین اول: برنامهای بنویسید که یک جمله فارسی بگیرد و پرتکرارترین کلمه آن را با HashMap پیدا کند. تمرین دوم: لیستی از اعداد بسازید و با یک LinkedHashSet، تکراریها را حذف کنید بهطوری که ترتیب اولیه حفظ شود. تمرین سوم: یک record به نام Product با نام، دسته و قیمت بسازید. محصولات را با computeIfAbsent بر اساس دسته گروهبندی کنید و جمع قیمت هر دسته را چاپ کنید. تمرین چهارم: یک صف سفارش با ArrayDeque بسازید که سفارشهای فوری با push و سفارشهای عادی با offer وارد شوند و با poll پردازش شوند.
سؤالات متداول درباره Collections در جاوا
تفاوت ArrayList و آرایه در جاوا چیست؟
آرایه اندازه ثابت دارد و میتواند نوع اولیه مثل int را مستقیم نگه دارد. ArrayList اندازهاش خودکار تغییر میکند، متدهای آماده مثل add و remove و contains دارد، اما فقط شیء نگه میدارد؛ یعنی بهجای int باید Integer بنویسید.
تفاوت HashMap و TreeMap چیست؟
HashMap ترتیب کلیدها را تضمین نمیکند و get و put در آن معمولاً زمان ثابت دارند. TreeMap کلیدها را مرتب نگه میدارد، اما این عملیات در آن زمان لگاریتمی دارد. اگر ترتیب درج مهم است، LinkedHashMap را انتخاب کنید.
چرا List<int> در جاوا خطا میدهد؟
چون Generics در جاوا فقط با نوعهای شیء کار میکنند. باید از کلاس پوششی Integer استفاده کنید؛ جاوا تبدیل int و Integer را خودکار انجام میدهد.
ConcurrentModificationException چیست و چطور رفع میشود؟
وقتی مجموعهای را در حین پیمایش با for-each از طریق خود مجموعه تغییر دهید، این خطا رخ میدهد. برای حذف شرطی از removeIf یا متد remove خود Iterator استفاده کنید.
کی از HashSet بهجای ArrayList استفاده کنیم؟
وقتی تکراری نمیخواهید یا بیشتر کارتان بررسی وجود یک عضو با contains است. contains در HashSet معمولاً زمان ثابت دارد، اما در ArrayList باید کل لیست را بگردد.



نظرات 0
برای ارسال نظر وارد حساب کاربری شوید.
هنوز نظری ثبت نشده؛ اولین نفر باشید.